第4章 差分の差分法(DID)とCausalImpact:ユーザ単位で割り当てられない施策の効果を測る
本ノートは『効果検証入門』第4章の4.1〜4.4を解説するものである。教科書ではJohn Snowのコレラ調査と、カリフォルニア州の禁煙キャンペーン(Proposition 99)を例にしているが、本ノートではそれに加えて、Huluの「デバイスや期間の単位でしか切り替えられなかった推薦施策の効果をどう測るか」という問題に置き換えて考える。数式の前提、手計算できる小さな例、Python(Polars + NumPy + statsmodels)による分析までを一つにまとめている。Huluの数値例はすべて説明のために作った架空のデータであり、実際の施策の成果を表すものではない。
第2章と第3章では、介入を受けた人と受けなかった人が同じデータの中に混ざっている状況を前提にしていた。回帰分析も傾向スコアも、「似た特徴を持つ人同士で比べる」ための道具である。しかし現実には、 介入を受けなかった人が同じ集団の中にそもそも存在しない ことがある。第4章のテーマは、そのような状況で「別のグループ」と「介入前の時期」という二つの方向の比較を組み合わせ、効果を取り出すことである。
この章の出発点:ユーザ単位で切り替えられなかった施策
Huluの推薦開発では、次のような状況がよく起きる。
- 新しいホーム画面のトレイ構成を、アプリの実装都合で Fire TVだけに先行リリース した。ユーザ単位のA/Bテストは組めなかった。
- 『SPY×FAMILY』の新シーズン配信に合わせて、 全ユーザに ホーム最上段での訴求とプッシュ通知を行った。訴求を受けなかったユーザは一人もいない。
- 通信キャリアとの提携キャンペーンが、 特定の地域・期間だけ で実施された。
いずれも、介入は「デバイス」「期間」「地域」といったまとまりの単位で決まっている。Fire TVの中で「新トレイを見た人」と「見なかった人」を探しても見つからないし、訴求期間中の「訴求を受けなかった人」も存在しない。第2章・第3章の道具は、介入群と非介入群の両方に似た人がいることを前提にしていたので、ここでは使えない。
素朴な代案は二つある。一つは「Fire TVとAndroid TVを比べる」というグループ間の比較、もう一つは「Fire TVの導入前と導入後を比べる」という前後比較である。しかし、どちらにも見せかけの差が混ざる。Fire TVのユーザはもともとテレビで長時間見る人が多いかもしれないし、導入後の週にたまたま人気作の配信が始まったかもしれない。 DID(Difference in Differences、差分の差分法)は、この二つの素朴な比較を組み合わせることで、それぞれの弱点を打ち消す方法 である。さらに後半のCausalImpactは、「比較対象のグループ」すら用意できないときに、介入前のデータから「介入がなかった場合の推移」を予測して効果を測る。
この章では次の順序で問題を解いていく。
| 分析の途中で生じる疑問 | 導入する考え方 | それによって分かること |
|---|---|---|
| 他のグループと比べると何がまずいのか | グループ固有の効果 | グループ間比較に混ざるバイアスの正体 |
| 前後で比べると何がまずいのか | 時間固有の効果(トレンド) | 前後比較に混ざるバイアスの正体 |
| 二つのバイアスを同時に消せないか | 差分の差分(DID) | 2回の引き算で効果だけが残る仕組み |
| 集計でなく回帰で行うと何が得られるか | 交互作用項による定式化 | 標準誤差、共変量、多期間への拡張 |
| 同じ地域を何度も観測すると何が起きるか | 自己相関とクラスター標準誤差 | 標準誤差が過小になる理由と対処 |
| DIDが正しいと言えるのはどんなときか | 平行トレンド仮定 | 検証できない仮定とその確認方法 |
| 比べるグループがないときはどうするか | CausalImpact(反実仮想の予測) | 予測モデルによる効果推定 |
| 比べる相手を自動で選べないか | 合成コントロール | 平行トレンドを満たす相手の作り方 |
数式が出てきたら、「この式はどの疑問に答えようとしているのか」を確認しながら読むと理解しやすい。
4.1 DID(差分の差分法)
4.1.1 DIDが必要になる状況
回帰分析と傾向スコアは、介入グループと非介入グループの両方に、同じような特徴を持つサンプルが含まれている状況を利用して比較する方法であった。しかし、実際に得られるデータセットには、介入・非介入それぞれのグループに同質なサンプルが存在しないことがよくある。これは、 介入が広い範囲に一斉に影響する 場合によく発生する。特定の地域における政策や法律の変更のほか、特定の地域で広告を出稿する場合や、価格を変更する場合などが典型である。
たとえば、ある都市で条例を変更した場合、その効果は都市内のすべての人に及ぶ。ある地域のすべてのスーパーで商品を10%値引きしたとき、その地域の中に値引きしない店舗は存在しない。効果を測る観点では、介入を個人や店舗の単位でランダムに割り当てるRCTが最適である。第2章・第3章の回帰分析や傾向スコアも、介入が個人や店舗の単位で選ばれているデータを前提にしている。しかし、介入が地域単位でしか決められない場合、これらの分析方法ではうまく対応できない。
介入を行った地域の中に非介入グループがないなら、他の地域のデータを非介入グループとして扱うことを考える。しかし後述するように、この方法では地域ごとの違いによるセレクションバイアスが生じる。他の地域がだめなら過去との比較を考えるが、この場合も「過去と今の差が介入だけである」という保証がない。
DIDは、介入が行われた地域の介入前後のデータに加えて、 他の地域の介入前後のデータ を使うことで、これらの問題を乗り越える方法である。大まかには、介入前後の差分を介入グループと非介入グループでそれぞれ計算し、さらにその差分同士の差をとる。2回の差分をとる手続きが、名前の由来である。
興味のある介入が特定の共変量、とくに地理的な情報と完全に相関するケースは、実店舗・マス広告・行政のように、管理運営が地理的な区画ごとに行われる場合によく見られる。経済学では、ある都市の政策の効果や、テロなどの事象が経済に与える影響の評価に使われてきた。Card (1990) は1980年にボートでマイアミに到着した移民が労働市場に与えた影響を分析している。Blake et al. (2015) は、eBayにおいてGoogleでの検索連動型広告の出稿を一部地域で取りやめる疑似的な実験を行い、DIDで分析した。その結果、eBayにとって検索連動型広告の売上への効果は限定的であることを示している。
Huluの推薦の文脈に置き換えると、「地域」にあたるのはデバイス種別、アプリのバージョン、契約経路(キャリア提携など)、そして「作品」である。たとえば新しい推薦モデルをAndroid TVのアプリだけに先行導入した場合、介入はデバイスの単位で完全に決まっている。同じデバイスの中に非介入ユーザはいない。
4.1.2 集計による効果検証とその欠点
地域ごとに複数の時期のデータが手に入った場合、二つの単純な集計による効果検証がよく行われる。
一つ目は、介入を受けた地域と受けなかった地域を比較する方法 である。しかしこの場合、地域と介入が完全に相関してしまう。地域A、B、C、Dがあり、Aだけでスーパーの価格変更を行った状況を考える。AとB・C・Dの平均を比べると、その差には本来の介入効果のほかに、地域固有の効果も含まれる。介入する地域を実験で選んでいても、何らかの意思決定で選んでいても、この問題は残る。データが店舗ごとに手に入ったとしても同じである。
二つ目は、同じ地域の値下げ前と値下げ後を比較する方法 で、いわゆる 前後比較 である(図4.1)。前後比較は同一の地域で比べているので、地域によるセレクションバイアスはなくなる。一見正しそうに見える。しかし、セレクションバイアスはサンプル間だけでなく、 同一サンプルのタイミング間 でも発生する。価格変更のあとに売上が変化したとしても、価格変更がなくとも同じぶんだけ売上が変化する状況であれば、その変化は価格によるものではなく、他の要因で自然に変わっただけである。同一サンプルの前後を比較した場合、その差には本来の効果のほかに、時間を通した自然な変化(トレンド)が含まれてしまう。
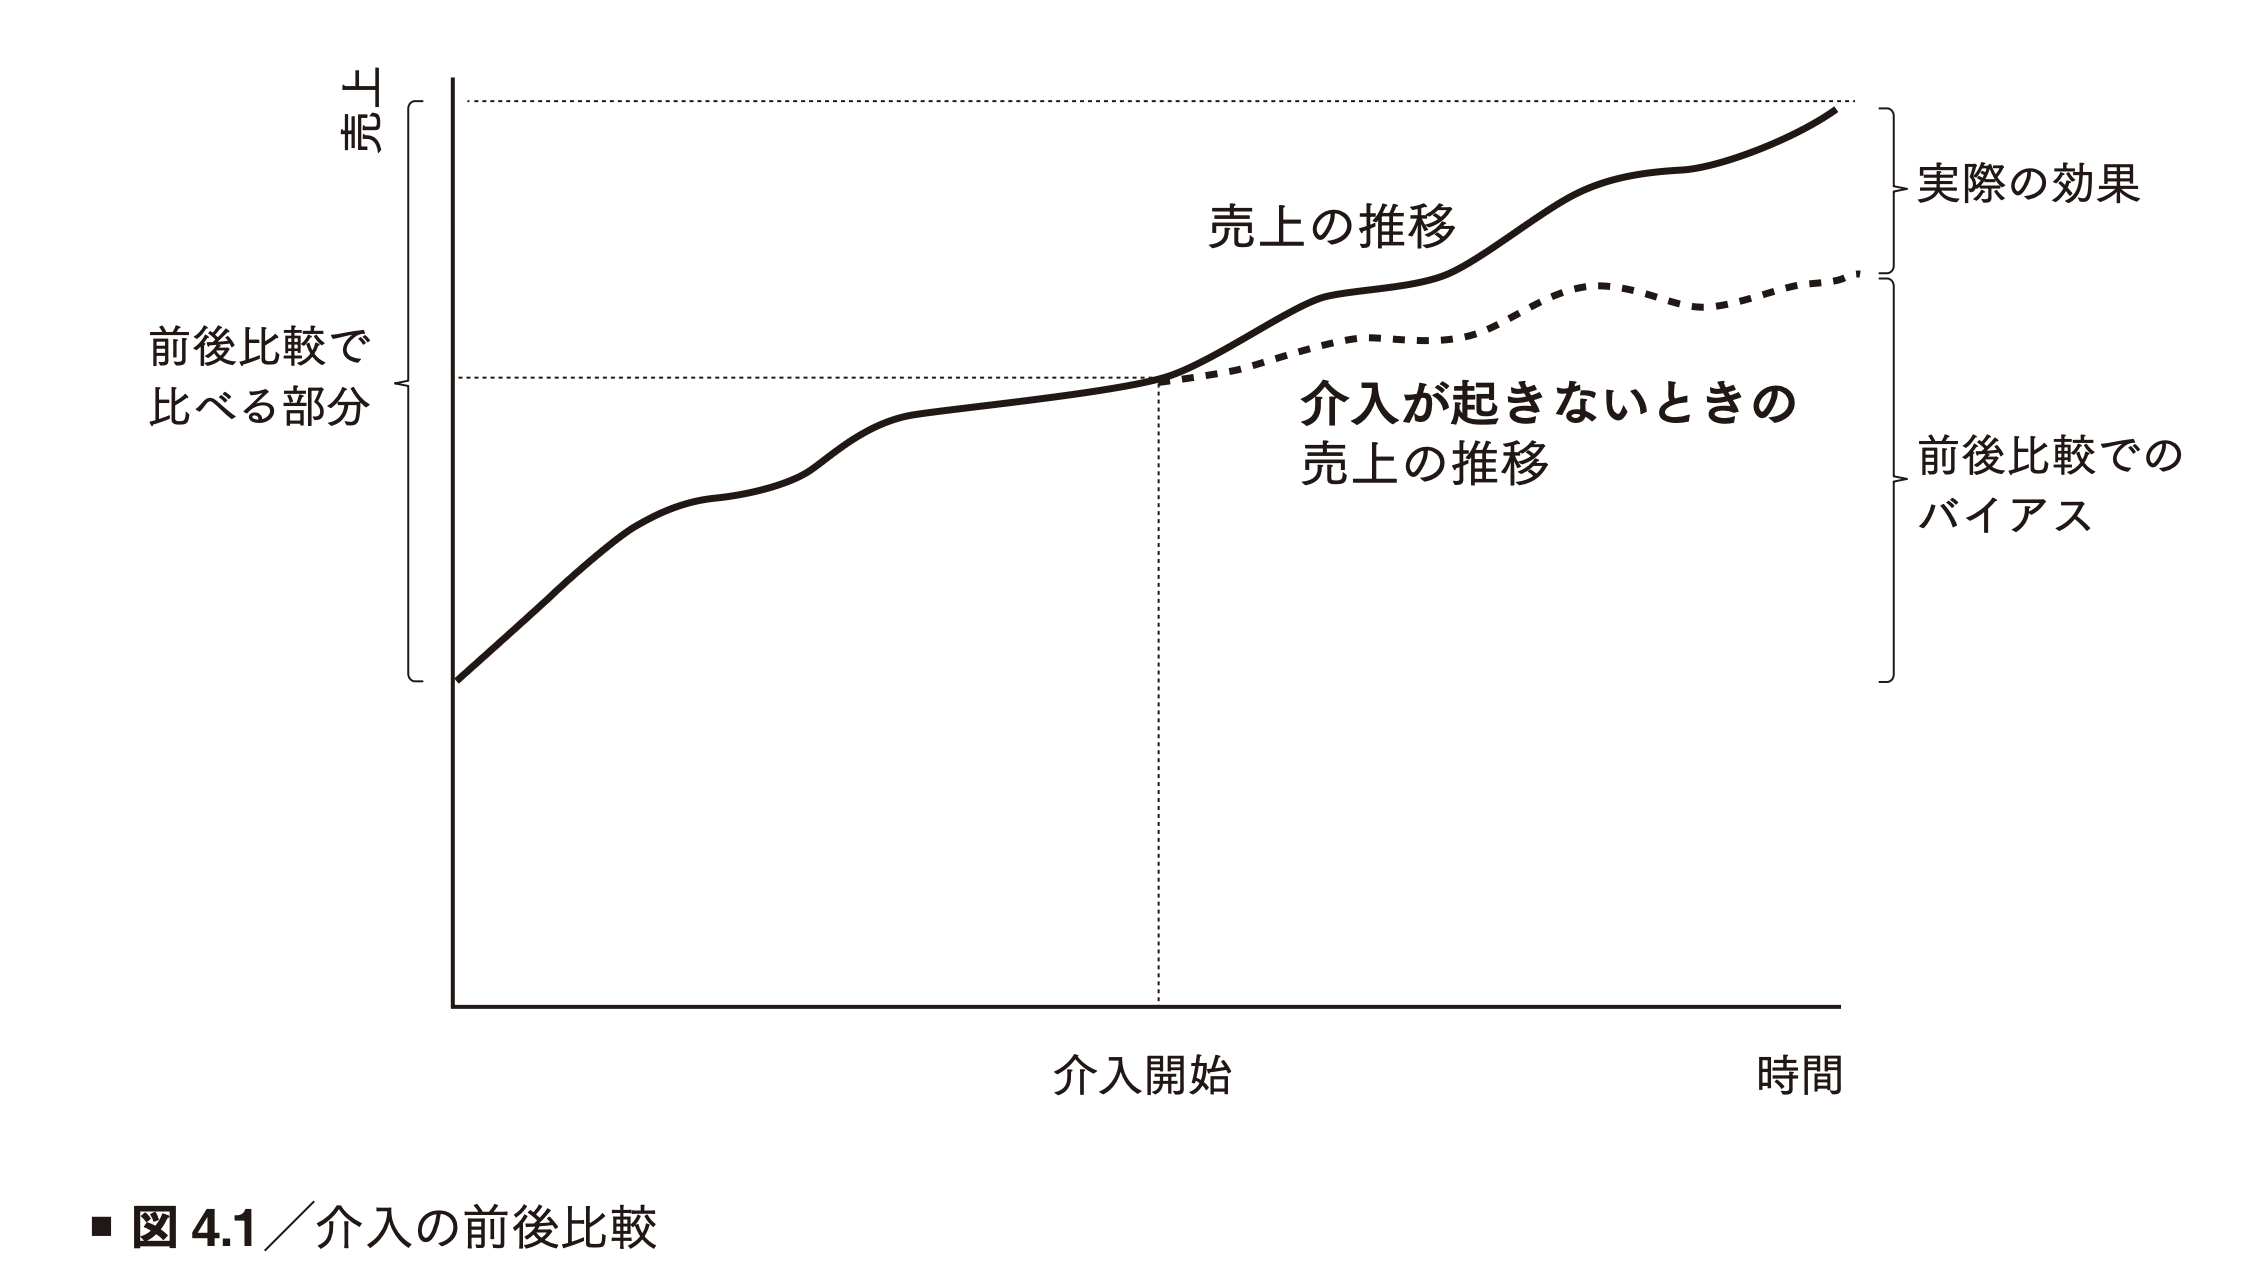
図4.1の実線は実際の売上の推移で、点線は「介入が起きなかった場合」の推移である。前後比較は、介入前の水準と介入後の実線の差を効果とみなす。しかし本来の効果は実線と点線の差であり、点線が介入前の水準から上に動いているぶんだけ、前後比較は効果を過大に見積もる。この差が「前後比較でのバイアス」である。
ワークド例:Huluの二つの素朴な比較
Fire TVだけに新しいホーム構成を先行導入したとして、「ホームのトレイ経由でその日に何かを再生したプロフィールの割合」(以下、トレイ経由視聴率)を週ごとに集計したとする。
| デバイス | 導入前の週 | 導入後の週 |
|---|---|---|
| Fire TV(介入あり) | 12.0% | 15.0% |
| Android TV(介入なし) | 10.0% | 11.5% |
グループ間比較では、導入後の週でFire TVとAndroid TVを比べて、 ポイントを効果とみなす。しかし導入前の週にもすでに ポイントの差がある。Fire TVのユーザはもともとホームからよく再生する人たちであり、この2.0ポイントは施策とは無関係の「デバイス固有の差」である。
前後比較では、Fire TVの導入前後を比べて ポイントを効果とみなす。しかし、介入を受けていないAndroid TVでも ポイント上がっている。導入後の週に人気作の配信が始まった、あるいは連休があった、といった「時間固有の変化」が、どちらのデバイスにも共通して起きている。
つまり、グループ間比較には「デバイス固有の差」が、前後比較には「時間固有の変化」が混ざっている。DIDは、この二つを同時に取り除く。
4.1.3 DIDのアイデアを用いた集計分析
同じ時期の他地域との比較にも、同じ地域の前後比較にもバイアスが生まれるなら、どう分析すればよいのか。
イギリスの医師John Snowは、19世紀中ごろにコレラの感染源を探る中でこの課題に直面し、DIDの基礎となるアイデアで分析を行った。そのアイデアは、 介入を受けるグループと受けないグループでそれぞれ前後比較を行い、その結果の差を見る というものである。コレラの感染源が空気にあるのか水源にあるのかを検証していたSnowは、死者数の多い地域で水の供給源が変わったことに着目し、水源の変化を介入として分析を試みた。
調査対象の地域は、Southwark and Vauxhall社とLambeth社という二つの会社によって水が供給されていた。1849年にはどちらの会社もテムズ川を水源としていたが、1852年にLambeth社は汚染が少ないと考えられる上流へ水源を移した。したがって、Southwark and Vauxhall社の供給地域では1849年も1854年も同じ水源が使われている一方、Lambeth社が供給する地域では1854年には別の水源に変わっている。もし感染源が水源にあるなら、Lambeth社が供給する地域では死者数が減るはずである。表4.1はSnow (1855) のTable 12から一部を抜粋したものである。
| 水道を提供する会社 | 死者数(1849) | 死者数(1854) |
|---|---|---|
| Southwark and Vauxhall | 2,261 | 2,458 |
| Lambeth | 162 | 37 |
| Southwark and Vauxhall & Lambeth(両社が供給) | 3,905 | 2,547 |
まずSouthwark and Vauxhall社の地域では、1849年から1854年にかけて死者数が増えている。水源が変わらなかった地域では、コレラが依然として猛威をふるっていたことが分かる。Lambeth社のみの地域は数が少ないので死者数自体は少ないが、162人から37人へと減少している。もし水源が変わらず、Southwark and Vauxhall社の地域と同じように死者が増えていたはずだとすれば、Lambeth社の地域では水源の変化によって死者が減ったことになる。両社が供給していた地域では、一部だけがLambeth社の水なので効果は限定的と想定されるが、それでも3,905人から2,547人へ大幅に減っており、水源の変化に効果があったことを示唆している。
このように、 「非介入グループの変化」と「介入グループが介入を受けなかった場合の変化」が一致するだろう という仮定を 平行トレンド仮定(Common Trend Assumption) と呼ぶ。詳細は4.1.6で扱う。
式で書く:観測値を三つの部品に分解する
この分析を式で明確にする。本ノートでは、教科書の 、 という記号を、より短い記号に置き換える。グループを で表し、介入グループを 、非介入グループを とする。時点を で表し、介入前を 、介入後を とする。観測されるアウトカム は、次の三つの部品の和で表せると考える。
- :グループ固有の効果。時間が経っても変わらない、そのグループの「地力」である。教科書の 、 に対応する。コレラの例では、地域間の所得格差や地理的な条件が反映される。
- :時間固有の効果。グループによらず、その時点のすべてのグループに共通して起きる変化である。教科書の 、 に対応する。イギリス全土での健康状態の改善や、ロンドン全体のコレラの蔓延度合いが反映される。
- :介入の効果。介入グループの介入後にだけ加わる。
すると、4つのセルの観測値は次のように書ける。
介入の効果 は、介入グループの介入後( )にだけ含まれている。ここから を取り出すには、次の2段階の引き算を行う。
第1段階は、それぞれのグループの中での前後比較 である。同じグループの中で引き算をするので、時間で変化しないグループ固有の効果 が消える。
介入グループの前後比較には、時間の効果 と介入の効果 が混ざったままである。だから前後比較だけでは、「ロンドン全体の衛生状態が改善しただけではないか」という疑念が消えない。一方、非介入グループの前後比較は、時間の効果 そのものになっている。
第2段階は、二つの前後比較の差 である。
非介入グループの前後比較が「時間の効果の純粋な測定値」になっていることを利用して、介入グループの前後比較からそれを差し引き、介入の効果 だけを抜き出している。これがDIDの仕組みのすべてである。
ワークド例:Huluの4つの数字で を取り出す
4.1.2の表に戻る。Fire TVを介入グループ 、Android TVを非介入グループ とし、単位はポイント(%)とする。
| 導入前 | 導入後 | 前後の差 | |
|---|---|---|---|
| Fire TV( ) | 12.0 | 15.0 | |
| Android TV( ) | 10.0 | 11.5 |
第1段階の前後比較は、Fire TVが 、Android TVが である。第2段階でその差をとる。
新ホーム構成の効果は、トレイ経由視聴率を1.5ポイント引き上げたと推定される。素朴なグループ間比較の3.5ポイントには「Fire TV固有の差」2.0ポイントが、前後比較の3.0ポイントには「時間の効果」1.5ポイントが混ざっていたことが、この計算から分かる。
この表がどのような部品から作られているかを逆算すると、 、 ( と置いた場合)、 、 である。実際に となり、表と一致する。
John Snowのデータでの集計結果
教科書は、Snowの論文からRでデータを作り直して集計している。本ノートでは同じ値をPython(Polars)で集計した。データは会社別・年別の死者数で、両社が供給する地域を介入グループ(
LSV = 1 )としている。
| company | LSV | year_1849 | year_1854 | gap | gap_rate |
|---|---|---|---|---|---|
| Southwark and Vauxhall | 0 | 2,261 | 2,458 | 197 | 0.0871 |
| Lambeth & Southwark and Vauxhall | 1 | 3,904 | 2,547 | −1,357 | −0.3476 |
gap
は各地域の1849年と1854年の死者数の差、つまり前後比較の結果である。
gap_rate
はその差を1849年の死者数で割った比率である。非介入グループであるSouthwark
and
Vauxhall社の地域では死者が197名(8.7%)増えている。これが時間の効果であり、介入がなかった場合にどの程度死者が増えたかを表す。介入グループである両社供給地域では、死者が1,357名(34.8%)減っている。DIDによる効果量は、これらの差である。
比率で計算すれば である。水源が変わった地域では死者数が大幅に減少したことが確認できる。
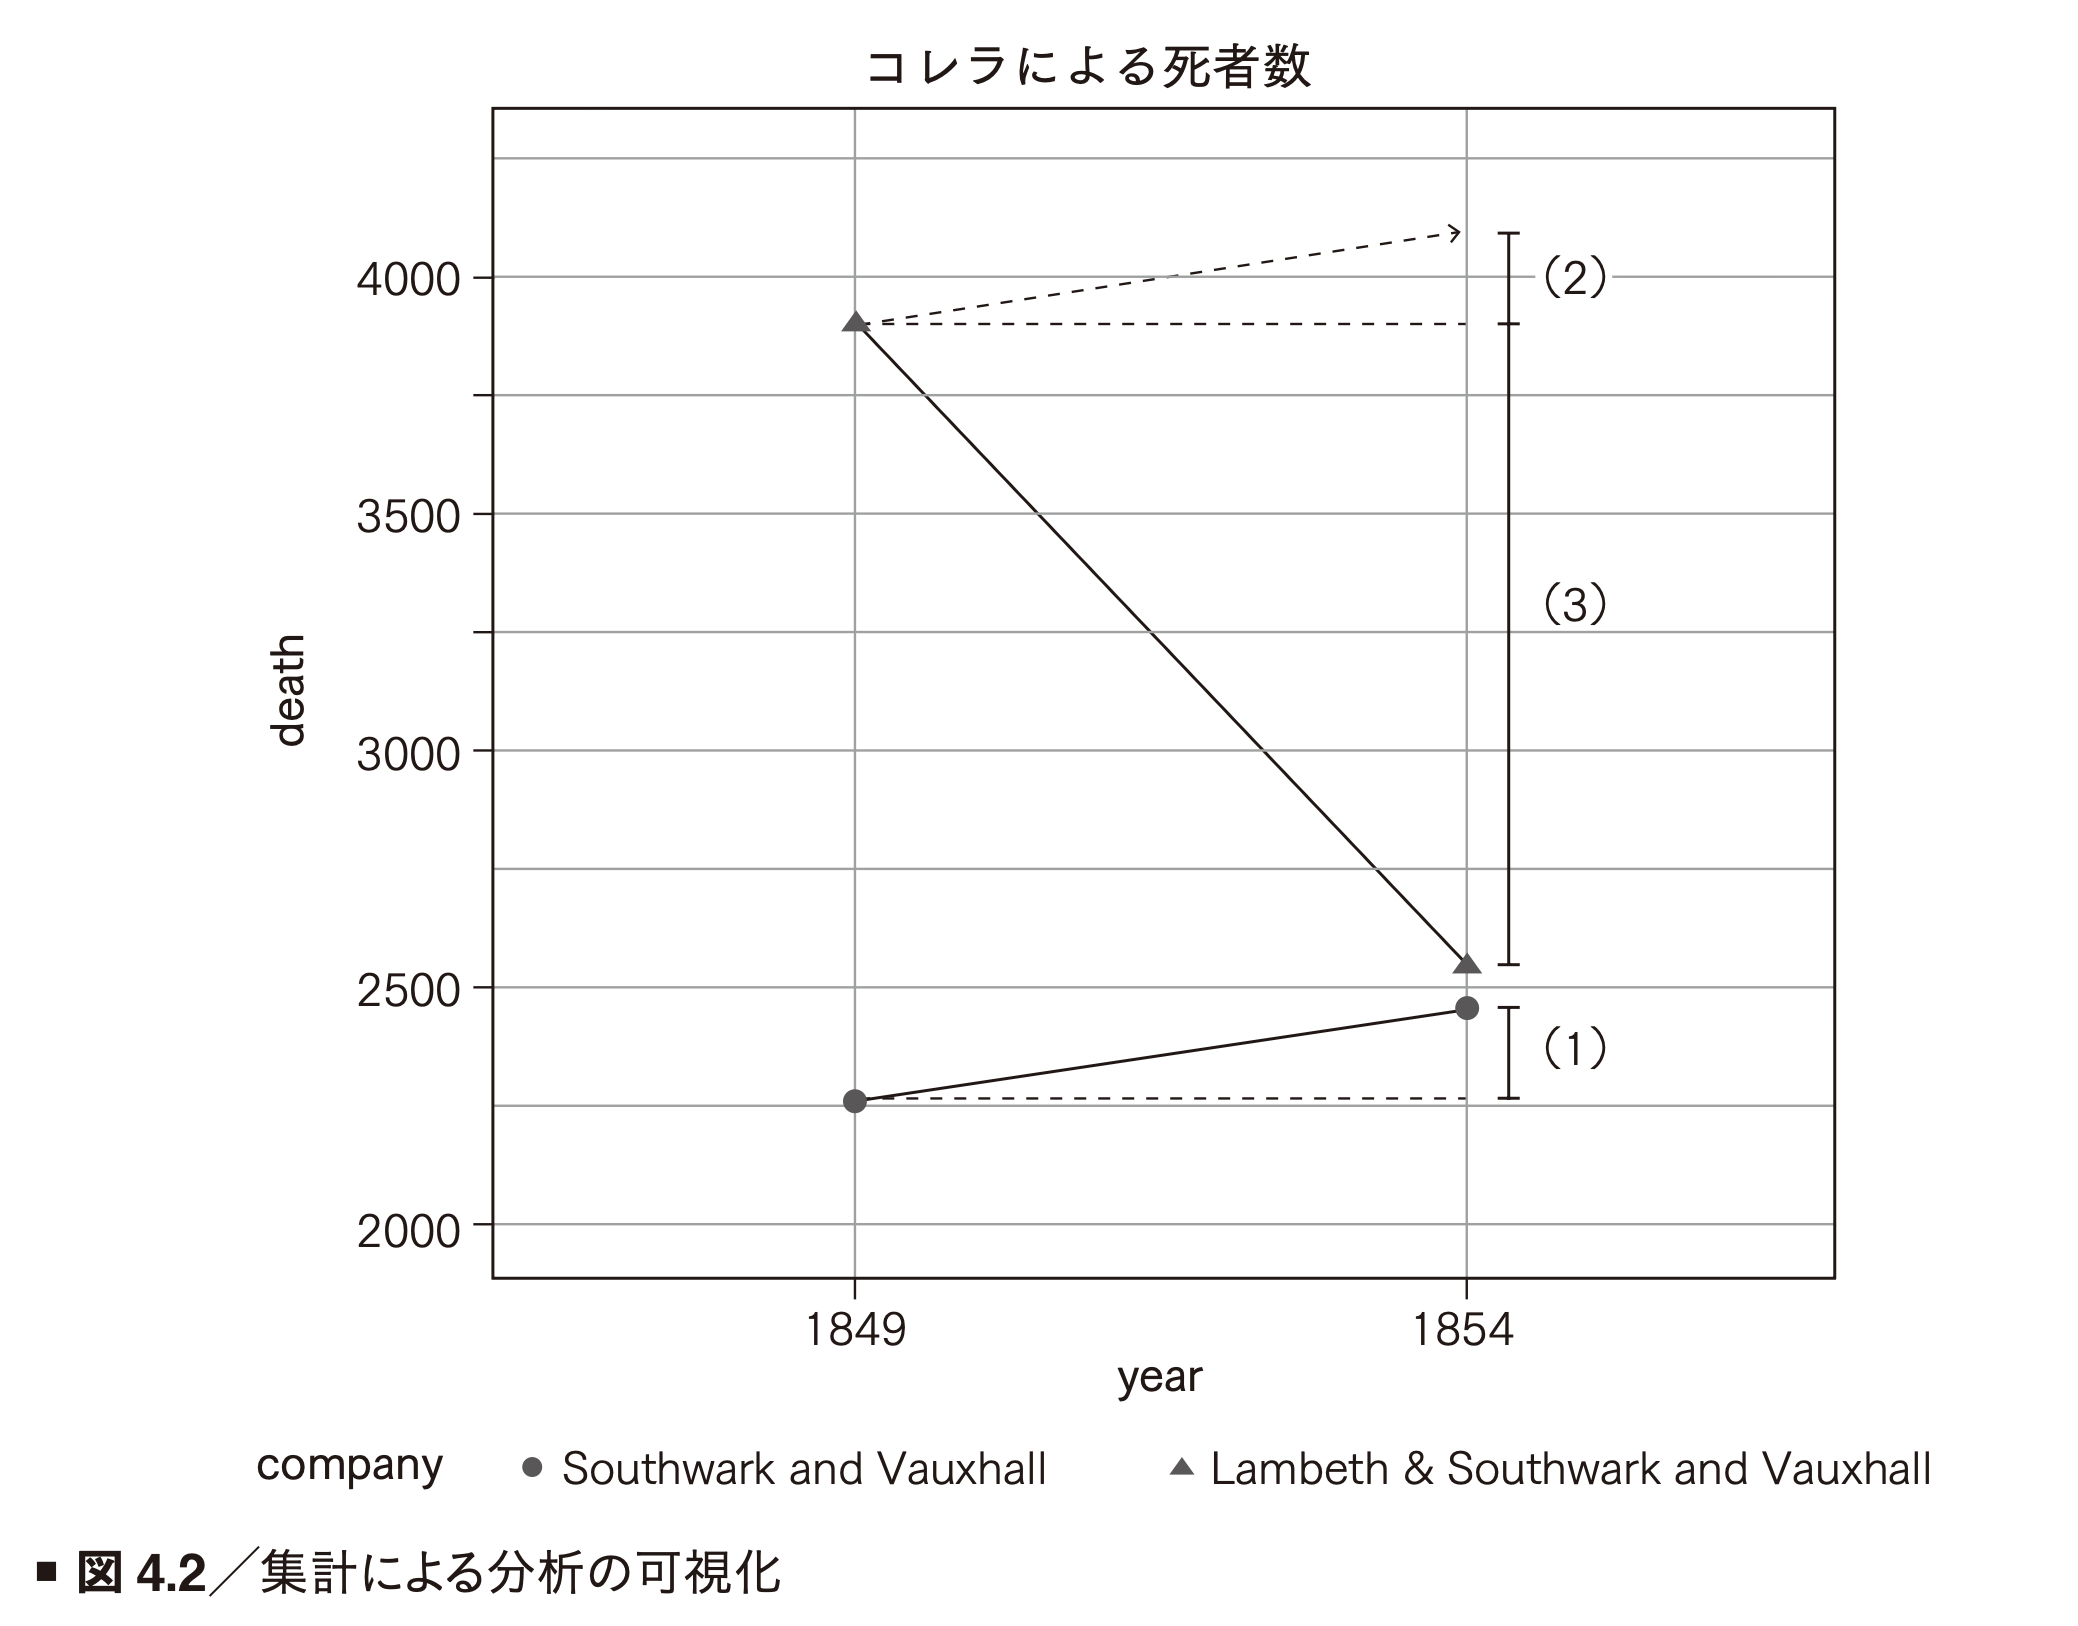
図4.2は、この集計をプロットしたものである。(1)は1849年から1854年にかけて非介入グループで起きた死者数の変化の大きさ(+197)である。平行トレンド仮定が成り立つなら、介入グループでも介入がなければ同じぶんだけ変化していたはずで、それが(2)の点線の矢印として描かれている。実際に観測された介入グループの変化は(3)の −1,357 である。よって効果は、(3)の実際の変化と(2)の「あったはずの変化」の差、すなわち となる。
実数で見るか比率で見るか
ここで、 −1,554 を1849年の介入グループの死者数3,904で割ると −39.8%
となり、 gap_rate の差から求めた −43.5%
とは一致しない。この差は、
時間の効果を実数の水準で考えるか、比率で考えるか
の違いから生まれる。
死者数で計算した場合、時間の効果は「どちらの地域でも197人増える」という仮定になる。比率で計算した場合は「どちらの地域でも1849年の死者数の8.7%増える」という仮定になる。どちらを選ぶかは、どちらが時間の効果をより適切に表しているかという分析者の解釈に依存する。この例では、二つの地域は含まれる区域の数も人口も違う。よって、時間による死者数の増加が地域間で同じ人数になるとは考えにくく、比率で表す方が適切である。
Huluの例でも同じ問題がある。Fire TVの視聴者数が100万人、Android TVが20万人だとして、「連休で再生数がどちらも5万回増えた」と考えるのは不自然である。「どちらも5%増えた」と考える方が自然であり、その場合はアウトカムの対数をとって分析する(4.1.4)。
4.1.4 回帰分析を利用したDID
前節までで、DIDは「4つの平均を使った2回の引き算」であることが分かった。引き算だけで効果が出るなら、なぜここで回帰分析が出てくるのか。教科書はいきなり回帰モデルの式から始めるが、その前に「集計のDIDには何が足りないのか」と「第2章で学んだ回帰と、ここでの回帰は同じものなのか」を確認しておく。ここを押さえると、回帰モデルの式が自然に読めるようになる。
なぜ回帰分析が出てくるのか:集計のDIDにできない三つのこと
4.1.3の集計によるDIDは、4つの数字から効果を1つ計算する手続きであった。この手続きには、実務で困る三つの弱点がある。
一つ目は、推定した効果がどれだけ信頼できるかが分からない ことである。John Snowの例では −1,554 という効果が出たが、この数字が偶然のばらつきで出たものか、本物の効果なのかは、4つの合計値だけを見ていても判断できない。第1章で学んだ通り、効果の推定値には必ず標準誤差を添えて、有意差検定ができる形にしたい。そのためには、地区ごとの死者数のように、 セルの中のばらつきが見える細かいデータ を使って、推定値と一緒にその不確かさを計算する仕組みが必要になる。
二つ目は、グループや期間が増えると引き算では手に負えなくなる ことである。2グループ × 2期間なら2回の引き算で済む。しかし4.3で扱うタバコの分析は、37州 × 23年のデータである。「介入前の年ごとの水準はどう扱うか」「州ごとの水準の違いはどう扱うか」を、引き算の組み合わせで表現するのは現実的でない。
三つ目は、共変量を加えられない ことである。4.1.6で見るように、平行トレンド仮定が疑わしいときには「トレンドの乖離を説明する変数」をモデルに加えて調整したい。単純な引き算にはそれを差し込む場所がない。
回帰分析は、この三つを一度に解決する。 「4つの平均を計算して引き算する」という手続きを、「アウトカムをダミー変数に回帰して、ある係数を読む」という手続きに書き換える と、標準誤差は回帰の副産物として出てくるし、グループや年が増えてもダミー変数を増やすだけで済むし、共変量は説明変数として横に並べるだけでよい。つまり、回帰分析で新しいことをするのではなく、 同じ計算を、拡張しやすい形式で行う のが目的である。
第2章の回帰とのつながり:介入変数と、二つの「共変量」
もう一つ大事なのは、ここで使う回帰が第2章の回帰と別物ではないという点である。第2章の効果検証の回帰は、次の形をしていた。
が介入を受けたかを表す変数で、 は「介入の割り当てとアウトカムの両方に関係する変数」(交絡因子)であった。 をモデルに入れる理由は、 の値が同じ人同士で比べることで、セレクションバイアスを取り除くためである。入れ忘れるとOVB(脱落変数バイアス)が生じる。
DIDの状況をこの枠組みに当てはめてみる。まず、介入を受けたかを表す変数 は何か。介入を受けたのは「介入グループに属し、かつ、介入後の時点で観測された」データだけである。よって、グループを表すダミー と、介入後を表すダミー を使って、 と書ける。
次に、交絡因子にあたるものは何か。4.1.2で確認した通り、素朴な比較に混ざるバイアスの正体は二つあった。 「どのグループに属するか」 は介入の割り当て(介入グループにいる人だけが介入を受ける)にもアウトカム(グループ固有の水準 )にも関係するので、交絡因子である。同じく 「どの時点か」 も介入の割り当て(介入後にだけ介入がある)にもアウトカム(時間の効果 )にも関係するので、交絡因子である。第2章の言葉で言えば、DIDとは 交絡因子が「グループ」と「時点」の二つである状況 にほかならない。
したがって、第2章と同じ発想で「交絡因子をモデルに入れて、同じ条件同士で比べる」ことにすると、モデルは次のようになる。
これが、この後で出てくる「もっとも単純なDIDの回帰モデル」である。 を入れるのは、グループ固有の水準の違いで比べないため(4.1.2の一つ目の欠点への対処)である。 を入れるのは、時間の効果で比べないため(4.1.2の二つ目の欠点への対処)である。そして が、両方を取り除いたあとに残る介入の効果である。第2章では「共変量を入れ忘れるとOVBが生じる」と学んだが、DIDではまさに、 を入れ忘れるとグループ間の差が、 を入れ忘れると時間の効果が、それぞれ効果の推定値に混ざり込む。
ワークド例:何を入れ忘れると、どの素朴な比較に戻るか
4.1.3のHuluの4つの数字(Fire TVが12.0から15.0、Android TVが10.0から11.5)で、説明変数の組み合わせを変えながら回帰してみる。 の係数だけを見る。
| モデルに入れた説明変数 | の係数 | この数字の正体 |
|---|---|---|
| のみ | 3.83 | 介入セル(15.0)と、残り3セルの平均(11.17)の差。何も調整していない比較 |
| と | 3.00 | Fire TVの前後比較( )。時間の効果が混ざったまま |
| と | 3.50 | 導入後のグループ間比較( )。Fire TV固有の差が混ざったまま |
| と と | 1.50 | DID。4.1.3で手計算した と一致 |
だけを入れた回帰は「同じグループの中で比べる」ことになるので、前後比較と同じ3.0が出る。 だけを入れた回帰は「同じ時点の中で比べる」ことになるので、グループ間比較と同じ3.5が出る。両方を入れて初めて、グループ固有の差と時間の効果の両方を取り除いた1.5が出る。 4.1.2の二つの素朴な比較は、それぞれ「交絡因子を一つ入れ忘れた回帰」だった のである。DIDの回帰モデルに と の両方が入っている理由は、これに尽きる。
G を入れ忘れる
Y = β0 + β2 P + β3 Z
同じ時点の中で比べる = グループ間比較。Fire TV 固有の差が β3 に混ざる(3.5)。
P を入れ忘れる
Y = β0 + β1 G + β3 Z
同じグループの中で比べる = 前後比較。時間の効果が β3 に混ざる(3.0)。
両方入れる
Y = β0 + β1 G + β2 P + β3 Z
グループと時点の両方を揃えて比べる = DID。β3 は介入の効果(1.5)。
回帰で扱うデータの形
DIDは回帰分析の枠組みに当てはめることができるが、ここで扱うデータは、通常の回帰分析のデータと構造が少し異なる。第2章では一人のユーザから一行のデータが得られた。DIDでは、 同一の対象から、別の期間に得られたデータ を縦に積む。John Snowのデータなら、同じ地区について1849年の行と1854年の行がある。Huluの例なら、同じデバイスについて導入前の週の行と導入後の週の行がある。この形のデータを パネルデータ と呼ぶ。DIDそのものは地域の数や期間の長さを限定しないので、地区が28個でも州が37個でも、期間が2回でも23回でも、同じ枠組みで扱える。
一行が「どのグループの、どの時点の観測か」を持っているので、そこからダミー変数 と を作り、その積 を介入変数として回帰する。目的変数 は死者数で、地域個別の効果と、すべての地域に共通する時間の効果に分解できると考える。
DIDの回帰モデル
以上をふまえて、もっとも単純なDIDの回帰モデルは次である。グループを表すダミー変数を
(介入グループなら1)、介入後の時点を表すダミー変数を
(介入後なら1)とする。教科書の記号では
が LSV 、 が
D1854 にあたる。
は二つのダミーの積で、 介入グループかつ介入後 のときだけ1になる。すなわち「実際に介入を受けた観測」を表す変数であり、この係数 が興味のあるパラメータである。
なぜ がDIDの推定値になるのか
この回帰の4つのセルの予測値を書き出すと、4.1.3の分解と一対一に対応していることが分かる。誤差項を無視して、各セルの と の値を代入する。
| セル | 回帰の予測値 | 4.1.3の分解 | |||
|---|---|---|---|---|---|
| 非介入・介入前 | 0 | 0 | 0 | ||
| 非介入・介入後 | 0 | 1 | 0 | ||
| 介入・介入前 | 1 | 0 | 0 | ||
| 介入・介入後 | 1 | 1 | 1 |
表を見比べると、 (グループ固有の効果の差)、 (時間の効果)、そして である。DIDの2回の引き算を回帰の係数で書くと、次のようになる。
右辺を整理すると確かに だけが残る。 回帰は、集計によるDIDを係数の形で書き直したもの にすぎない。
ワークド例:Huluの4つの数字を回帰に入れる
4.1.3のHuluの表を回帰に入れると、係数は次のように決まる。
| 項 | 推定値 | 意味 |
|---|---|---|
| (Intercept) | 0.100 | Android TVの導入前の水準 |
| treat | 0.020 | Fire TVがもともと持っている差 |
| post | 0.015 | 導入後の週に共通して起きた変化 |
| treat:post | 0.015 | 新ホーム構成の効果 |
4つのセルに4つのパラメータなので、回帰はデータをぴったり再現し、標準誤差は計算できない(後述のJohn Snowの会社別集計と同じ状況である)。標準誤差を得るには、より細かい単位(週×デバイス、あるいはプロフィール単位)のデータが必要になる。
PythonによるDID回帰の実装
教科書ではRの lm()
を使う。本ノートでは、第2章と同じくPolarsで表を作り、最小2乗法をNumPyで書いた関数
ols() を使う。 "LSV:D1854"
のようにコロンでつないだ列名を渡すと、二つの列の積(交互作用項)を作るようにしてある。実行用ファイルは
output/ch4_examples.py
にまとめており、リポジトリのルートで次を実行する。
uv run output/ch4_examples.pyJohn Snowのデータは、Snow (1855) のTable 12の地区別の死者数をコード内に持っている。
import numpy as np
import polars as pl


def load_john_snow() -> pl.DataFrame:
    """Snow (1855) Table 12 の地区別死者数。LSV=1 が両社供給地区(介入グループ)。"""
    sv1849 = [283, 157, 192, 249, 259, 226, 352, 97, 111, 8, 235, 92]
    sv1854 = [371, 161, 148, 362, 244, 237, 282, 59, 171, 9, 240, 174]
    lsv1849 = [256, 267, 312, 257, 318, 446, 143, 193, 243, 215, 544, 187, 153, 81, 113, 176]
    lsv1854 = [113, 174, 270, 93, 210, 388, 92, 58, 117, 49, 193, 303, 142, 48, 165, 132]

    def block(deaths: list[int], year: int, prefix: str, lsv: int) -> pl.DataFrame:
        return pl.DataFrame({
            "area": [f"{prefix}_{i + 1}" for i in range(len(deaths))],
            "year": [year] * len(deaths),
            "death": deaths,
            "LSV": [lsv] * len(deaths),
        })

    return pl.concat([
        block(sv1849, 1849, "sv", 0), block(sv1854, 1854, "sv", 0),
        block(lsv1849, 1849, "lsv", 1), block(lsv1854, 1854, "lsv", 1),
    ]).with_columns(D1854=(pl.col("year") == 1854).cast(pl.Int64))


js_df = load_john_snow()

# 会社別(LSV別)・年別に集計し、前後比較の差をとる
js_sum = js_df.group_by("LSV", "year").agg(pl.col("death").sum()).sort("LSV", "year")
js_grp = (
    js_sum.pivot(on="year", index="LSV", values="death")
    .rename({"1849": "year_1849", "1854": "year_1854"})
    .with_columns(
        gap=pl.col("year_1854") - pl.col("year_1849"),
        gap_rate=pl.col("year_1854") / pl.col("year_1849") - 1,
    )
)
回帰の関数は第2章のものにクラスター標準誤差(4.1.5)の機能を足した。
def ols(frame: pl.DataFrame, outcome: str, predictors: list[str],
        cluster: str | None = None) -> OLSResult:
    """最小2乗法。cluster を指定するとクラスター標準誤差を返す。"""
    x, names = design_matrix(frame, predictors)   # 文字列列はダミー展開、"a:b" は積
    y = frame.get_column(outcome).cast(pl.Float64).to_numpy()
    n, k = x.shape
    xtx_inv = np.linalg.pinv(x.T @ x)
    beta = xtx_inv @ x.T @ y
    resid = y - x @ beta
    if cluster is None:
        sigma2 = resid @ resid / (n - k)
        var = sigma2 * xtx_inv
    else:
        groups = frame.get_column(cluster).to_numpy()
        meat = np.zeros((k, k))
        for g in np.unique(groups):          # クラスターごとにスコアを合計してから外積
            idx = groups == g
            score = x[idx].T @ resid[idx]
            meat += np.outer(score, score)
        n_groups = len(np.unique(groups))
        correction = (n_groups / (n_groups - 1)) * ((n - 1) / (n - k))
        var = correction * xtx_inv @ meat @ xtx_inv
    return OLSResult(names, beta, np.sqrt(np.diag(var)), resid, n, k)
まず会社別に集計した4行のデータで回帰する。
js_sum = js_sum.with_columns(D1854=(pl.col("year") == 1854).cast(pl.Int64))
print(ols(js_sum, "death", ["LSV", "D1854", "LSV:D1854"]).tidy)| term | estimate | std_error |
|---|---|---|
| (Intercept) | 2261.0 | NaN |
| LSV | 1643.0 | NaN |
| D1854 | 197.0 | NaN |
| LSV:D1854 | −1554.0 | NaN |
データが4サンプルしかないため、パラメータの標準誤差は計算されない(自由度が0である)。興味のある
LSV:D1854 の値は −1554 で、集計の結果と一致する。
D1854 の197が非介入グループの前後の変化、 LSV
の1643が介入前のグループ間の差になっていることも、先の表と対応している。
地区別のデータと地区ダミー
Snow (1855) のTable
12には、会社別の集計だけでなく地区ごとのデータもある。集計済みのデータではなく地区別のデータ(12地区
+
16地区の2年分で56行)で分析してみる。このとき各地区の特徴をとらえるために、地区を示すダミー変数
area
をモデルに追加する。この操作は、第2章で共変量をモデルに追加したことと同じ意味を持つ。以下では
area 以外のパラメータを表示している。
show(ols(js_df, "death", ["LSV", "area", "D1854", "LSV:D1854"]), drop_prefix=("area",))| term | estimate | std_error | statistic | p_value |
|---|---|---|---|---|
| (Intercept) | 177.7 | 16.0 | 11.09 | 0.000 |
| LSV | 49.2 | 45.7 | 1.08 | 0.292 |
| D1854 | 16.4 | 25.9 | 0.63 | 0.531 |
| LSV:D1854 | −101.2 | 34.2 | −2.96 | 0.007 |
介入効果を表す LSV:D1854 は −101.2
で、水源の変化によって各地区で平均100人程度の死者が減ったことが示されている。切片と
LSV の値は教科書の出力(319と
−96.4)と異なるが、これはどの地区を基準カテゴリにするかが異なるためで、興味のある
LSV:D1854 の推定値と標準誤差は一致する。
比較のために、地区ダミーを入れずに同じ56行で回帰すると、
LSV:D1854 の推定値は同じ −101.2
のまま、標準誤差は57.4に大きくなる。
地区ダミーは推定値を変えず、標準誤差だけを小さくする。
これは4.1.6で述べる「DIDにおける共変量の役割」の一つである。地区ごとの死者数の水準の違い(大きい地区と小さい地区)を地区ダミーが吸収してくれるので、残った誤差が小さくなるためである。
対数をとった回帰:比率で効果をとらえる
集計の分析では、時間の効果を比率で表す方が妥当だと議論した。回帰で比率として扱うには、目的変数の対数をとる。
js_log = js_df.with_columns(log_death=pl.col("death").log())
show(ols(js_log, "log_death", ["LSV", "area", "D1854", "LSV:D1854"]), drop_prefix=("area",))| term | estimate | std_error | statistic | p_value |
|---|---|---|---|---|
| D1854 | 0.074 | 0.136 | 0.54 | 0.591 |
| LSV:D1854 | −0.566 | 0.180 | −3.15 | 0.004 |
LSV:D1854 は −0.566
である。対数の差は近似的に変化率を表すので、水源が変わった地区では1854年におよそ56%死者が減少したと読める。より正確には
であり、係数の絶対値が大きいときは近似がずれる(第2章の2.4.3を参照)。
D1854
の0.074は非介入地区の変化率(+7.4%)で、集計の8.7%と近い値である。
4.1.5 DIDにおける標準誤差
通常の回帰分析では、大まかには一つの観測対象から一つのデータが得られることを想定している。一方でDIDは、同一の対象からいくつかの期間に取得したデータを利用する。このような場合、 自己相関(auto-correlation, serial correlation) を持つデータになる可能性がある。自己相関とは、ある時点で取得された値が、その近辺の時点の同じ変数の値と相関する状態をいう。
たとえば、あるコンビニの売上を毎日観測した場合、店舗近くの人通りや品ぞろえは大きく変わらないので、ある日とその前後の日の売上は非常に似た値になる。この売上データは自己相関を持っている可能性が高い。
自己相関を持つデータで回帰分析を行うと、誤差項の値が同一店舗内で似通ったものになる。これは、 「独立な観測がたくさんある」という回帰の前提よりも、実質的な情報量が少ない ということである。回帰の標準誤差は観測が独立であることを前提に計算されるので、結果として標準誤差が過小に算出される。有意差検定の観点では、統計的に有意な結果が過剰に得られてしまう。回帰分析が想定していないデータ構造に対して、強引に回帰を使ったために起きる問題である。
直観:100日分のデータは「100個の情報」ではない
Huluの例で考える。Fire TVとAndroid TVのトレイ経由視聴率を100日分ずつ集計して、200行のデータでDID回帰をしたとする。回帰は「200個の独立な観測がある」と考えて標準誤差を計算する。しかし、Fire TVの視聴率が今日高ければ明日も高いのが普通で、Fire TVの100日分は、実質的には「Fire TVという一つの対象を眺めている」に近い。デバイスごとの水準のゆらぎ(たとえばアプリのバージョンによる差)は100日間ずっと同じ方向に働くので、日数を増やしても消えない。それを「200個の独立な誤差」として扱えば、誤差の散らばりを過小評価し、標準誤差が小さくなりすぎる。
このような場合は、 クラスター標準誤差(clustered standard error) を使う。クラスター標準誤差は、サンプルごとではなく、指定した観測対象ごと(たとえば店舗ごと)に誤差を観測していると考えて計算する。ある店舗のデータであれば、毎月の誤差を別々に考えるのではなく、その店舗のすべての期間の誤差をまとめて一つの塊として扱う。同じクラスター内の誤差の相関を、どのような形であっても許容する計算になっている。
Rでは miceadds::lm.cluster() で計算できる。本ノートの
ols() 関数は cluster="area"
を指定するとクラスター標準誤差を返す。John
Snowの地区別データで地区をクラスターにすると、 LSV:D1854
の標準誤差は34.2から45.2に大きくなる。
DIDにおける標準誤差とクラスター標準誤差に関する議論は、Angrist and Pischke (2014) やBertrand et al. (2004) を参照するとよい。Bertrand et al. (2004) は、実際の州別パネルデータに「架空の介入」をランダムに与えてDIDを行い、通常の標準誤差では5%水準で有意になるはずのない架空の効果が、45%もの割合で有意と判定されたことを示している。
なお、クラスター標準誤差にも限界がある。クラスターの数が少ない(目安として30〜40未満)と、クラスター標準誤差自体が不安定になる。とくに 介入されたクラスターが1つしかない 場合(カリフォルニア州だけ、Fire TVだけ)は、クラスター標準誤差は信頼できない。この問題への対処は「教科書にない追加手法」の節で述べる。
4.1.6 平行トレンド仮定(Common Trend Assumption)と共変量
本章のこれまでの分析では、「もしLambeth社が水源を変更しなかったなら、両社供給地域でもSouthwark and Vauxhall社の地域と同じように死者が増えていたはずだ」という仮定を置いている。
介入グループと非介入グループの目的変数の時間を通じた変化、いわゆるトレンドが同一であるという仮定を 平行トレンド仮定(Common Trend Assumption) と呼ぶ。これはDIDの分析結果を正しいと考えるために必要な、もっとも重要な仮定である(図4.3)。この仮定が成り立たない場合、推定された効果は本来の効果にトレンドの乖離分を加えたものになる。これは、回帰分析で重要な共変量が脱落した場合に発生するOVB(脱落変数バイアス)と同じ問題である。
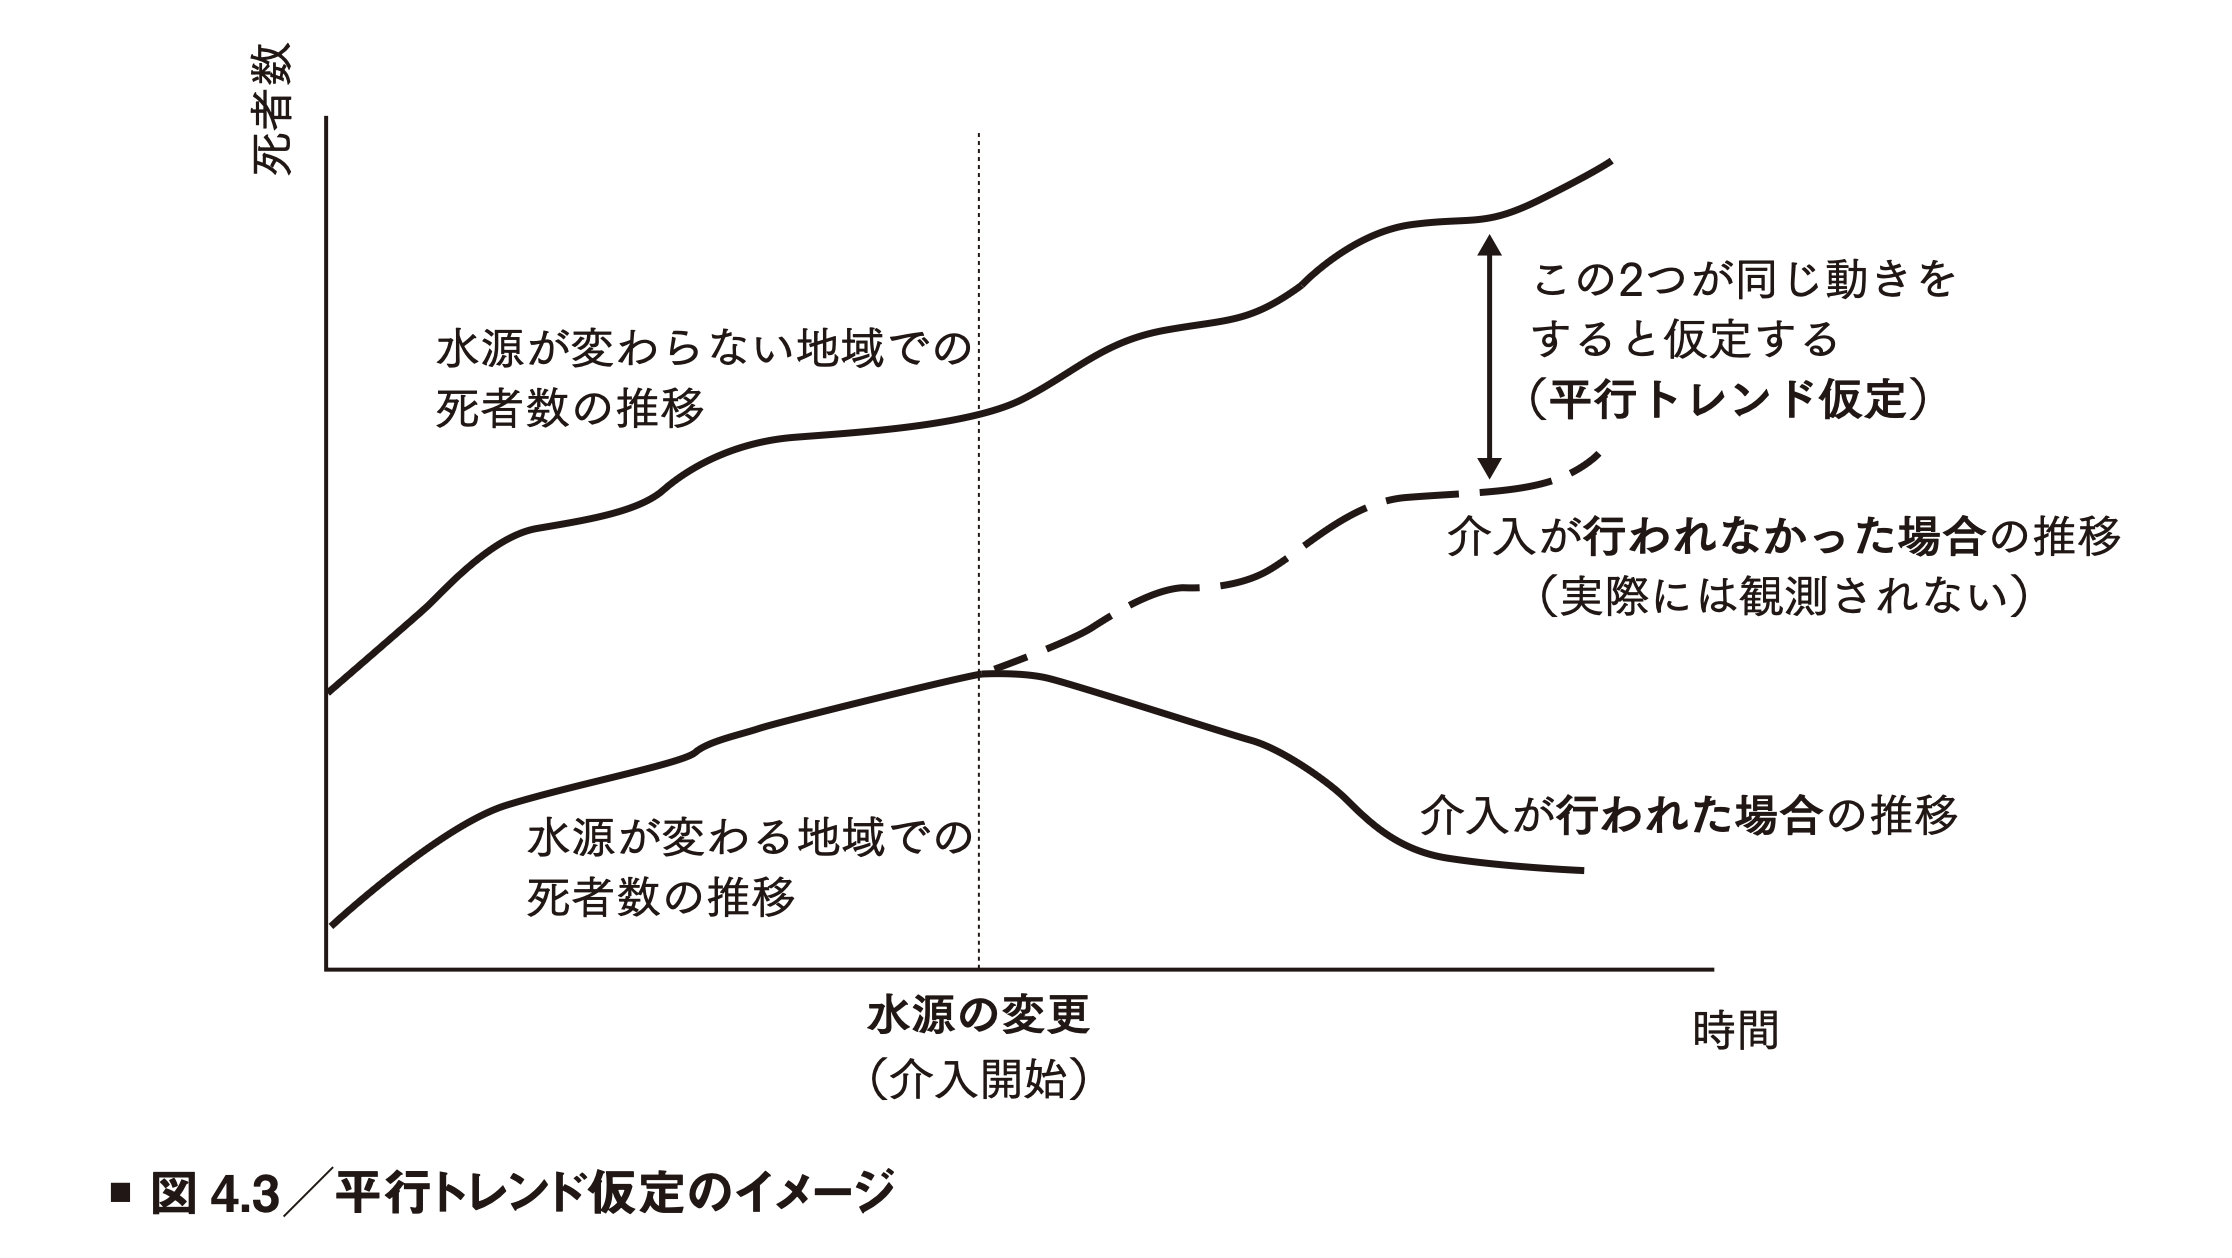
図4.3では、水源が変わらない地域の死者数(上の実線)と、水源が変わる地域の死者数(下の実線)が描かれている。介入開始後、介入グループには「介入が行われた場合の推移」(実線、下がっていく)と「介入が行われなかった場合の推移」(破線、実際には観測されない)の二つがある。平行トレンド仮定は、この破線が非介入グループの実線と 同じ動き をすると仮定するものである。効果は、破線と介入グループの実線の差として測られる。
この仮定は原理的に検証できない
すでに気づいたかもしれないが、この仮定は実際には観測されない結果に対するものである。理想的には、介入グループが介入されなかった場合を観測し、非介入グループのトレンドと比べて確かめたい。しかしそれは反実仮想であり、データからの直接の確認はできない。
介入までの期間が長いデータなら、 介入前の期間でトレンドが似ているか を確認することで、仮定の妥当性を間接的に確かめられる。介入前に二つのグループが平行に動いていれば、介入後も(介入がなければ)平行に動いたと考えるのは自然である。しかし、この方法は介入前の期間が複数必要になるうえ、多くの場合に明確な傾向は得られない。よって多くの分析では、平行トレンド仮定を満たすかの判断は、 分析者がデータを生み出した地域や現象をどう解釈しているか に依存する。
Huluの例で、Fire TVとAndroid TVのトレイ経由視聴率が導入前の12週間で平行に動いていれば心強い。逆に、導入直前にAndroid TVだけアプリの大型アップデートがあってトレンドが折れていれば、Android TVは比較相手として不適切である。
トレンドが同一でないときの二つの対策
仮にトレンドが同一でない場合、二つの対策がある。
一つ目は、仮定を満たさないと考えられるデータを取り除く方法 である。コレラの例のように地域ごとにデータがあるなら、介入地域の近隣の地域を選ぶことがよくある。これは暗黙的に、広範囲のデータから近隣だけを選択していることになる。ただし、地理的・構造的に似ているものを選べばよいわけではなく、それぞれの特殊な事情によってトレンドの乖離が起きていないかをよく考える必要がある。介入より前のデータを使って、トレンドが同一になるようなサンプルを自動的に検出する 合成コントロール(Synthetic Control) という方法も提案されている(4.3.4と追加手法の節で扱う)。
二つ目は、トレンドの乖離を説明する変数を共変量としてモデルに加える方法 である。トレンドの乖離はモデルに含まれなかった共変量によるものなので、OVBと同じ問題であることは先述した。乖離を説明する共変量を導入できれば、そのぶんのバイアスを減らせる。たとえばコレラのデータで、水源の変わらなかったいくつかの地域に衛生環境を向上させる施設が建設されると、平行トレンド仮定は満たされなくなる。施設が新設された地域では死者が減るので、非介入グループの「時間の効果」が本来より小さく見え、推定される介入効果(負の値)は過小、つまり効果が弱く見えてしまう。しかし施設の新設が共変量としてモデルに入れば、施設の効果は介入効果のパラメータから取り除かれ、バイアスの少ない結果が得られる。
介入前のトレンドが似ているグループだけを非介入グループにする。近隣地域を選ぶ、あるいは合成コントロールで自動選択する。
Hulu例: Android TVではなく、介入前12週の動きが最も近いデバイスを選ぶ。
トレンドの乖離を生む変数(施設の新設、アプリ更新の有無)をモデルに入れ、その効果を介入効果から分離する。
Hulu例: デバイス別のアプリ大型更新フラグや、配信本数を共変量にする。
DIDにおける共変量のもう一つの役割
DIDにおける共変量には、このほかに、目的変数への説明力を上げて推定される効果の標準誤差を小さくするという、回帰分析と同じ役割もある。各サンプルで値を持ち、時間によって変化しない変数を導入することになる。先ほどのコレラの分析で地区ダミーを入れたことがこれに該当する。地区ダミーを入れても入れなくても推定される効果量は −101.2 で同じだが、入れた場合には標準誤差が57.4から34.2に小さくなった。
4.2 CausalImpact
ここではDIDと同様のアイデアに基づいた CausalImpact という分析手法を説明する。CausalImpactの内部で使われているベイズ構造時系列モデル(Bayesian Structural Time Series Model)は本書の範囲では難解なので、基本的な考え方と使い方に焦点を当てる。
4.2.1 DIDの欠点
集計済みのデータしか持てない分析者にとって、DIDは最後の頼みの綱とも言える手法だが、二つの欠点がある。
一つは、効果を調べたい変数が複数の場所や時期で得られている必要がある ことである。スーパーの売上への価格変更の効果を考える際、売上データは介入地域だけでなく、介入のなかった別の地域でも手に入れる必要がある。しかし介入対象のデータしかないことはよくある。たとえばすべての地域に広告を配信した場合、手に入るのは広告の介入を受けた売上データだけである。Huluで全ユーザに訴求を行った場合も同じで、「訴求を受けなかったユーザの視聴数」は存在しない。
もう一つは、どのデータを分析に用いるかが分析者の仮説に依存する ことである。DIDは平行トレンド仮定を必要とする。つまり分析者は、この仮定が満たされるように非介入グループを構成するか、共変量を調整する必要がある。しかし4.1.6で見たように、仮定が実際に満たされているかは分からないので、近隣地域を使ったり、知り得る情報から共変量を選んだりすることになる。
4.2.2 CausalImpactのアイデア
CausalImpactは、複数の期間のデータを必要とする一方で、上の二つの欠点を補える分析方法である。
DIDのアイデアを言い直すと、 介入が行われたサンプルの「介入が行われなかった場合」の結果を、非介入グループのデータで補う というものであった。この見方を一歩進めると、本来この反実仮想の結果を何らかの方法で予測できるなら、 どのようなデータから予測しても構わない ということになる。もしうまく予測できるなら、実際に観測された値と予測値の差が介入の効果である。
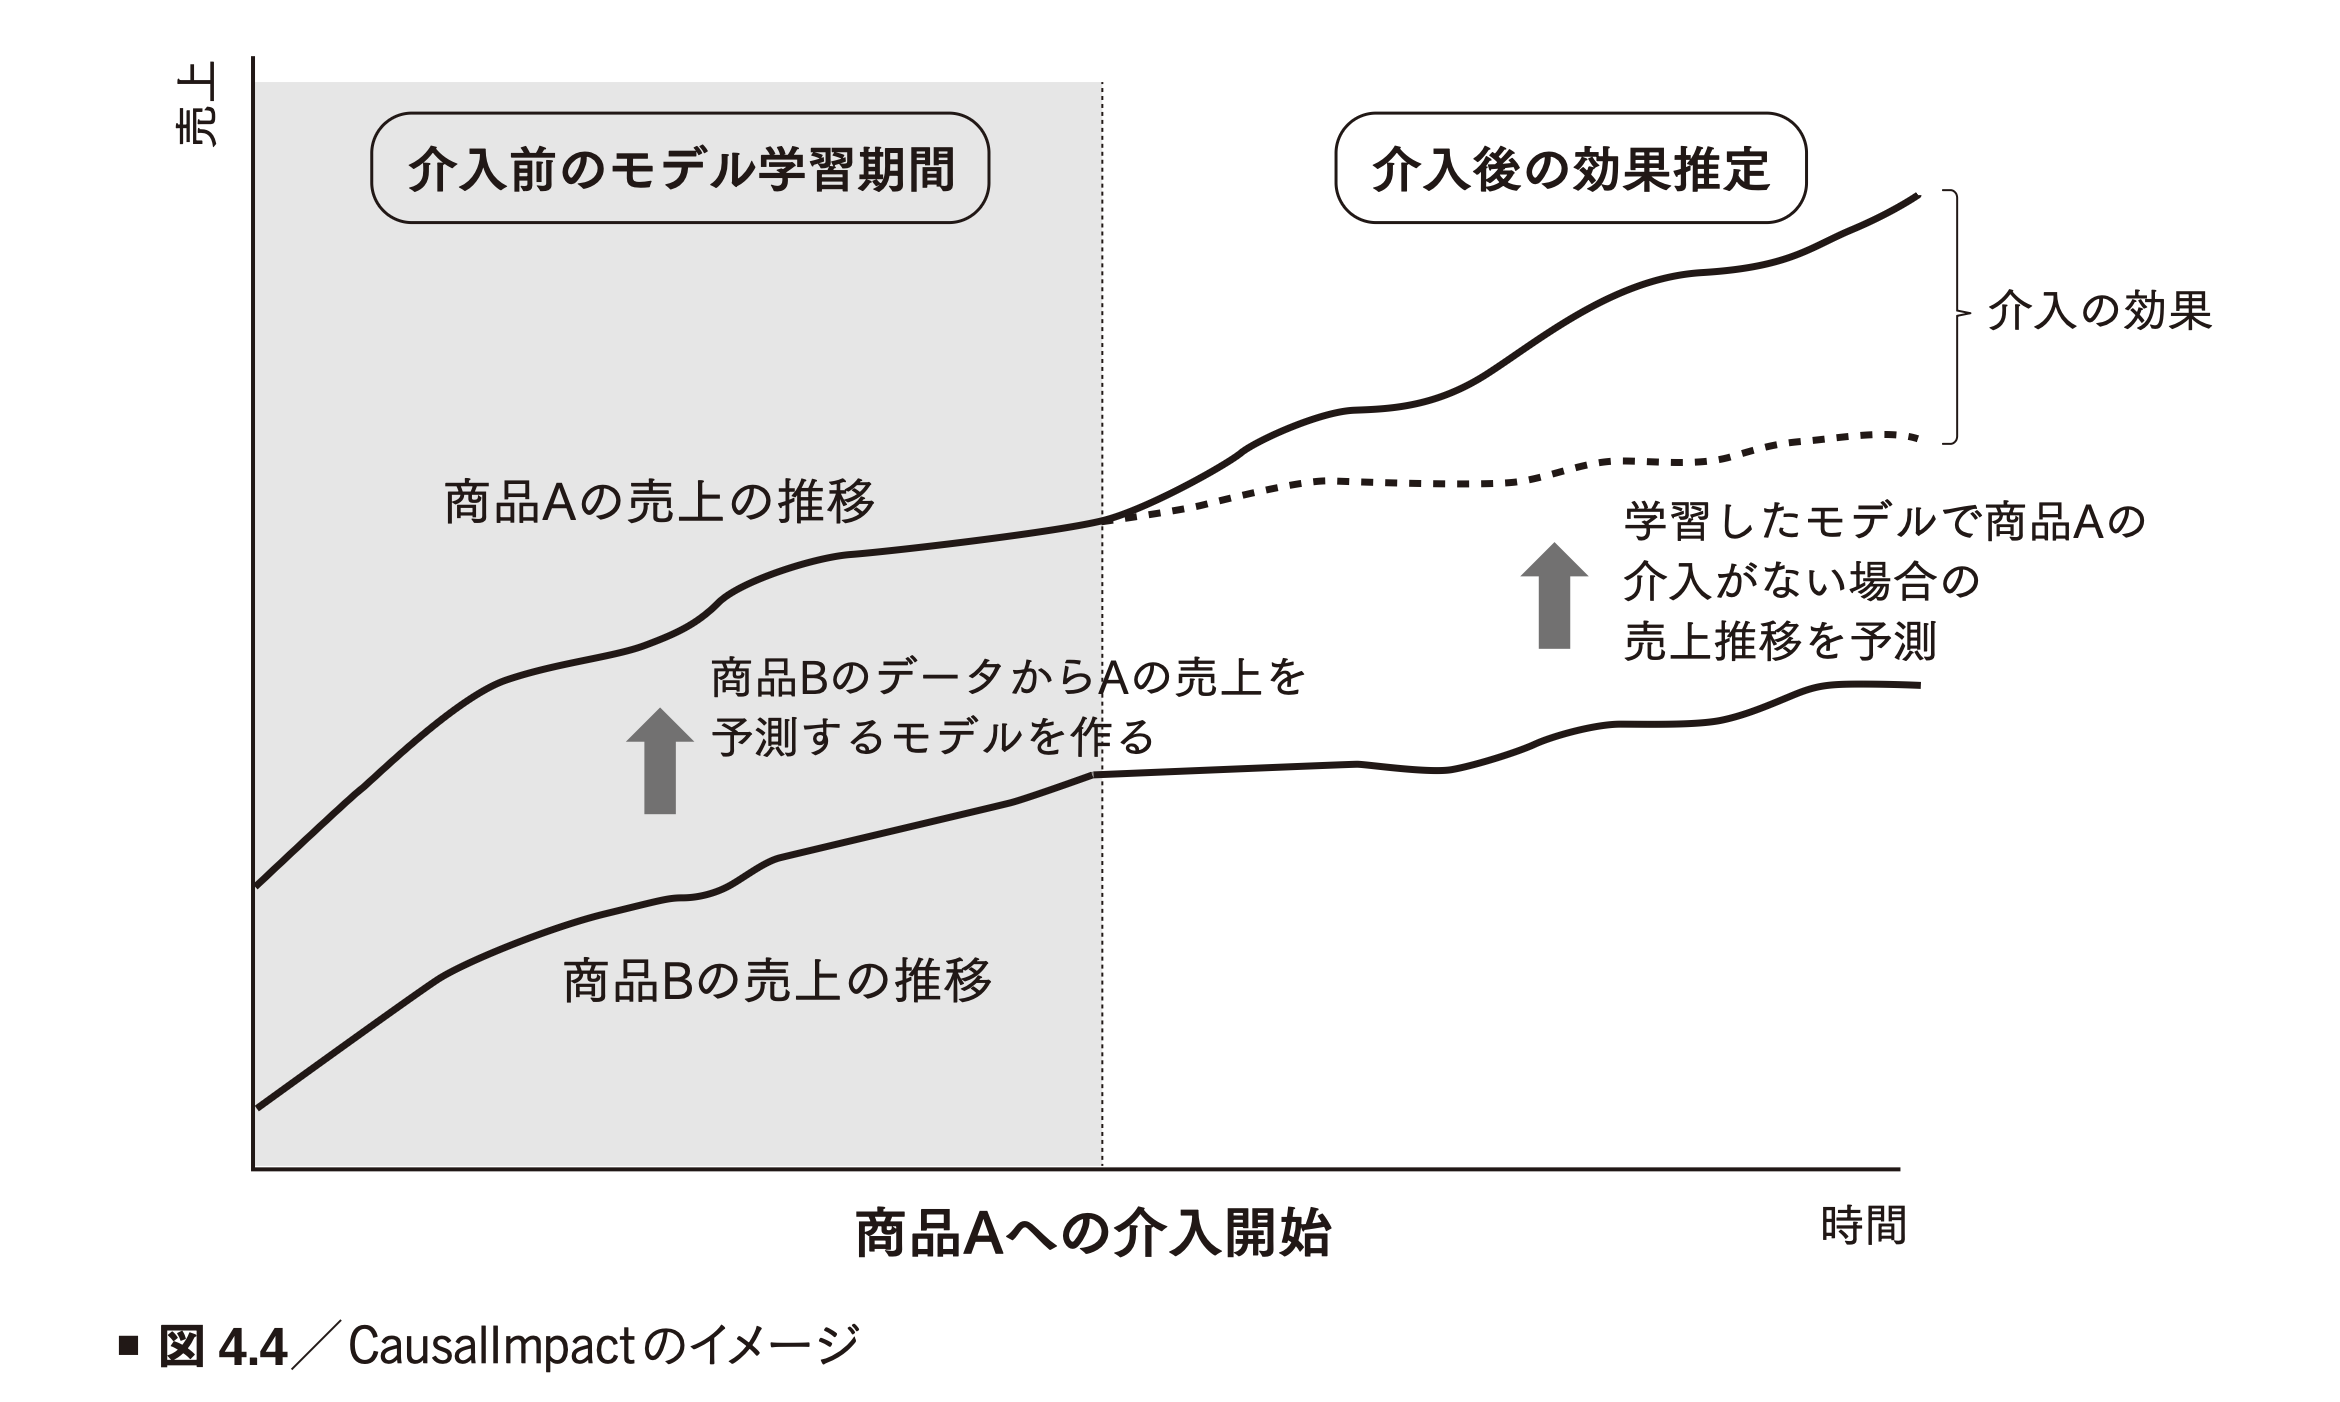
CausalImpactは、さまざまな種類の変数 を利用して目的変数 を予測するモデルを、 介入が行われる前の期間だけで 作る(図4.4)。図4.4では、商品Aの売上を商品Bの売上から予測するモデルを介入前に学習し、介入後は商品Bのデータをそのモデルに入れて「商品Aに介入がなかった場合の売上」を予測している。実線(実測)と破線(予測)の差が介入の効果である。
たとえば、ある店舗で価格を変えた効果を推定する際には、 として売上を用いる一方で、 として価格を変えた商品名の検索回数などを利用できる。検索回数は、その商品に興味のあるユーザ数や認知度に応じて変動するので、商品の潜在的な売上と強い相関を持つ。したがって、価格を変えなかった場合の売上とも強い相関を持つ。 の種類には限りがないので、複数のキーワードの検索回数やWebページのアクセス回数といった情報も使える。
さらにCausalImpactは、介入前のデータを利用して、どの変数が の予測に役立つかを判別し、使うデータを自動的に決めながらモデルを学習してくれる(内部ではスパイク・スラブ事前分布という仕組みで、多数の候補から少数の変数を選ぶ)。学習されたモデルは、 を入力すると介入前の状態の を予測する。よって介入後の を入力すれば、介入が行われなかった場合の の予測が出力され、この予測値と実際の の差が効果として得られる。
モデルの中身を簡単に
CausalImpactの内部モデルの骨格だけを書くと、次の二つの式である。
1行目は、 が「ゆっくり動く水準 」と「他の系列 からの回帰による説明」と「その日の誤差 」の和であると言っている。2行目は、水準 が前日の水準にランダムなゆらぎ を足したものとして推移する(ランダムウォーク)と言っている。この「ローカルレベル」の部分があるおかげで、回帰で説明しきれない緩やかな変化も追いかけられる。実際のCausalImpactはこれに季節成分やトレンド成分を足し、パラメータをベイズ推定して、事後分布のサンプルから予測の区間を出す。
DIDとの対応をつけると、DIDは「 が非介入グループのアウトカム1本だけで、係数 に固定し、 が定数」という、CausalImpactの極端に単純な特殊ケースと見ることができる。
Y(介入対象)と X(介入を受けない関連系列)を介入前の期間だけ集める。
水準 + 回帰の構造時系列モデル。役立つ X を自動選択する。
介入後の X を入れて「介入がなかった場合の Y」を予測する。
実測 − 予測 が各時点の効果。累積すれば総効果。
CausalImpactでも平行トレンド仮定は重要である
CausalImpactを利用する場合にも、平行トレンド仮定に相当する条件は重要である。 が介入の影響を受ける変数であってはならない。 その場合、予測値も介入の効果を受けて変動するので、最終的な効果の推定値も影響を受ける。また、 から影響を受ける変数も使えない。介入が に影響を与え、その影響を が受けるという経路ができるからである。よって、選んだデータのうちどれを使うかは自動化されても、 そもそもどのデータを候補にするか については分析者の仮定が必要である。
CausalImpactの最大の障壁は、DIDと同じく有用なデータを見つけることにある。DIDでは の差を時間と地域でとることで効果を推定していたが、CausalImpactでは介入地域の をうまく予測できる変数が必要で、他地域の は必ずしも必要ではない。したがって利用できるデータの種類はCausalImpactの方が多く、どのデータを使うかという点で分析者のアイデアが非常に重要になる。
売上と強い相関がありつつも介入の影響を受けない変数として、検索数が挙げられる。Google Trendsから得られるデータは、このような分析で非常に大きな価値を持つ。価格変更を介入と考えた場合、その商品名の検索数は有用である。広告のように検索数にも影響が出る介入では、別の国における検索回数なども利用できる。
Huluでの の候補と、使ってはいけない
『SPY×FAMILY』の新シーズンを全ユーザにホーム最上段で訴求した効果を、日次の「この作品を再生したプロフィール数」 で測りたいとする。介入前の期間で をよく予測し、かつ訴求の影響を受けない の候補は次のようなものである。
- 訴求していない他のアニメ作品の日次視聴プロフィール数 。曜日や連休、サービス全体の活性度を反映する。ただし、訴求によって視聴がこの作品に「奪われる」(カニバリゼーション)なら、 が介入の影響を受けるので不適切になる。似たジャンルより、視聴者層の重なりが小さい作品の方が安全である。
- サービス全体の日次アクティブプロフィール数 。訴求一つで全体の活性度が動くことは考えにくいので、多くの場合に使える。
- 地上波放送の視聴率やGoogle Trendsの検索量 。ただし、訴求がプッシュ通知を含み、通知が検索行動を誘発するなら、介入の影響を受ける。
一方、「この作品の詳細ページの閲覧数」を にしてはいけない。訴求はまさに詳細ページの閲覧を増やすので、予測値が介入に引っ張られ、効果が消えてしまう。第2章のPost treatment biasと同じ構造である。
4.3 大規模禁煙キャンペーンがもたらすタバコの売上への影響
本節では、カリフォルニア州で行われた大規模な禁煙キャンペーン Proposition 99 がタバコの消費にどの程度影響したかを推定する。これはAbadie et al. (2010) の分析を参考にしたものである。
Proposition 99は近代で初めての大規模な禁煙キャンペーンで、1988年から実施された。タバコ1箱に25セントの税金をかけ、その税収を健康やタバコの被害に関する教育、メディア上の禁煙キャンペーンの予算に充てた。そのほかにも室内の空気環境を改善する条例の制定など多岐にわたる活動が行われ、年間1億ドル程度の予算が使われた。このキャンペーンは当時では類を見ないほど大規模で初の試みだったため、同様の試みは1993年まで他の州では実施されなかった。
カリフォルニア州全体でこの介入が行われているため、非介入グループを州の中から用意することはできない。よってDIDのような分析で、介入がなかった場合のカリフォルニア州の状態を推測する必要がある。
4.3.1 データの準備
教科書はRの Ecdat パッケージの Cigar
データセットを使う。本ノートでは同じデータをRdatasetsの公開CSVから取得し、
data/Cigar.csv
に保存して使う。分析に使うのは全米各州における人口1人あたりのタバコの売上(箱数)である。カリフォルニア州(
state == 5 )の売上を
とし、それ以外の州のデータを
とする。本来の分析は1970〜2000年のデータを使うが、入手できるデータの関係から期間は1970〜1992年である(教科書では1993年までと書かれているが、
Cigar データは1992年までしかない)。
また本来の分析と同じく、1988年以降にタバコへ一定水準以上の増税を行った州は分析から除外する。このような州を含めると、カリフォルニア州以外でも別の介入が行われている状態になり、「介入がなかった場合のカリフォルニア州」との平行トレンド仮定が満たされなくなる。
SKIP_STATE = [3, 9, 10, 22, 21, 23, 31, 33, 48]  # 1988年以降に大幅増税した州など
CA = 5

cigar = (
    pl.read_csv("data/Cigar.csv")
    .filter(~pl.col("state").is_in(SKIP_STATE), pl.col("year") >= 70)
    .with_columns(
        area=pl.when(pl.col("state") == CA).then(pl.lit("CA")).otherwise(pl.lit("Rest of US")),
        post=(pl.col("year") > 87).cast(pl.Int64),
        ca=(pl.col("state") == CA).cast(pl.Int64),
        year_dummy=pl.format("D_{}", pl.col("year")),
    )
)


def weighted_sales(frame: pl.DataFrame, by: list[str]) -> pl.DataFrame:
    """人口(16歳以上)で重み付けした1人あたり売上。R の sum(sales*pop16)/sum(pop16)。"""
    return (
        frame.group_by(by)
        .agg(sales=(pl.col("sales") * pl.col("pop16")).sum() / pl.col("pop16").sum())
        .sort(by)
    )
「Rest of US」の売上は、州ごとの1人あたり売上を単純平均するのではなく、16歳以上人口で重み付けして平均している。人口の多い州の売上が全体をより強く代表するようにするためである。
4.3.2 DIDの実装
まず前後比較をする。介入が始まった1988年より前か後かで、1人あたり売上を比較する。
before_after = weighted_sales(
    cigar.with_columns(period=pl.when(pl.col("post") == 1).then(pl.lit("after")).otherwise(pl.lit("before"))),
    ["area", "period"],
).pivot(on="period", index="area", values="sales").with_columns(change=pl.col("after") - pl.col("before"))| area | before(1970〜87) | after(1988〜92) | change |
|---|---|---|---|
| CA | 116.7 | 77.1 | −39.5 |
| Rest of US | 126.8 | 106.9 | −20.0 |
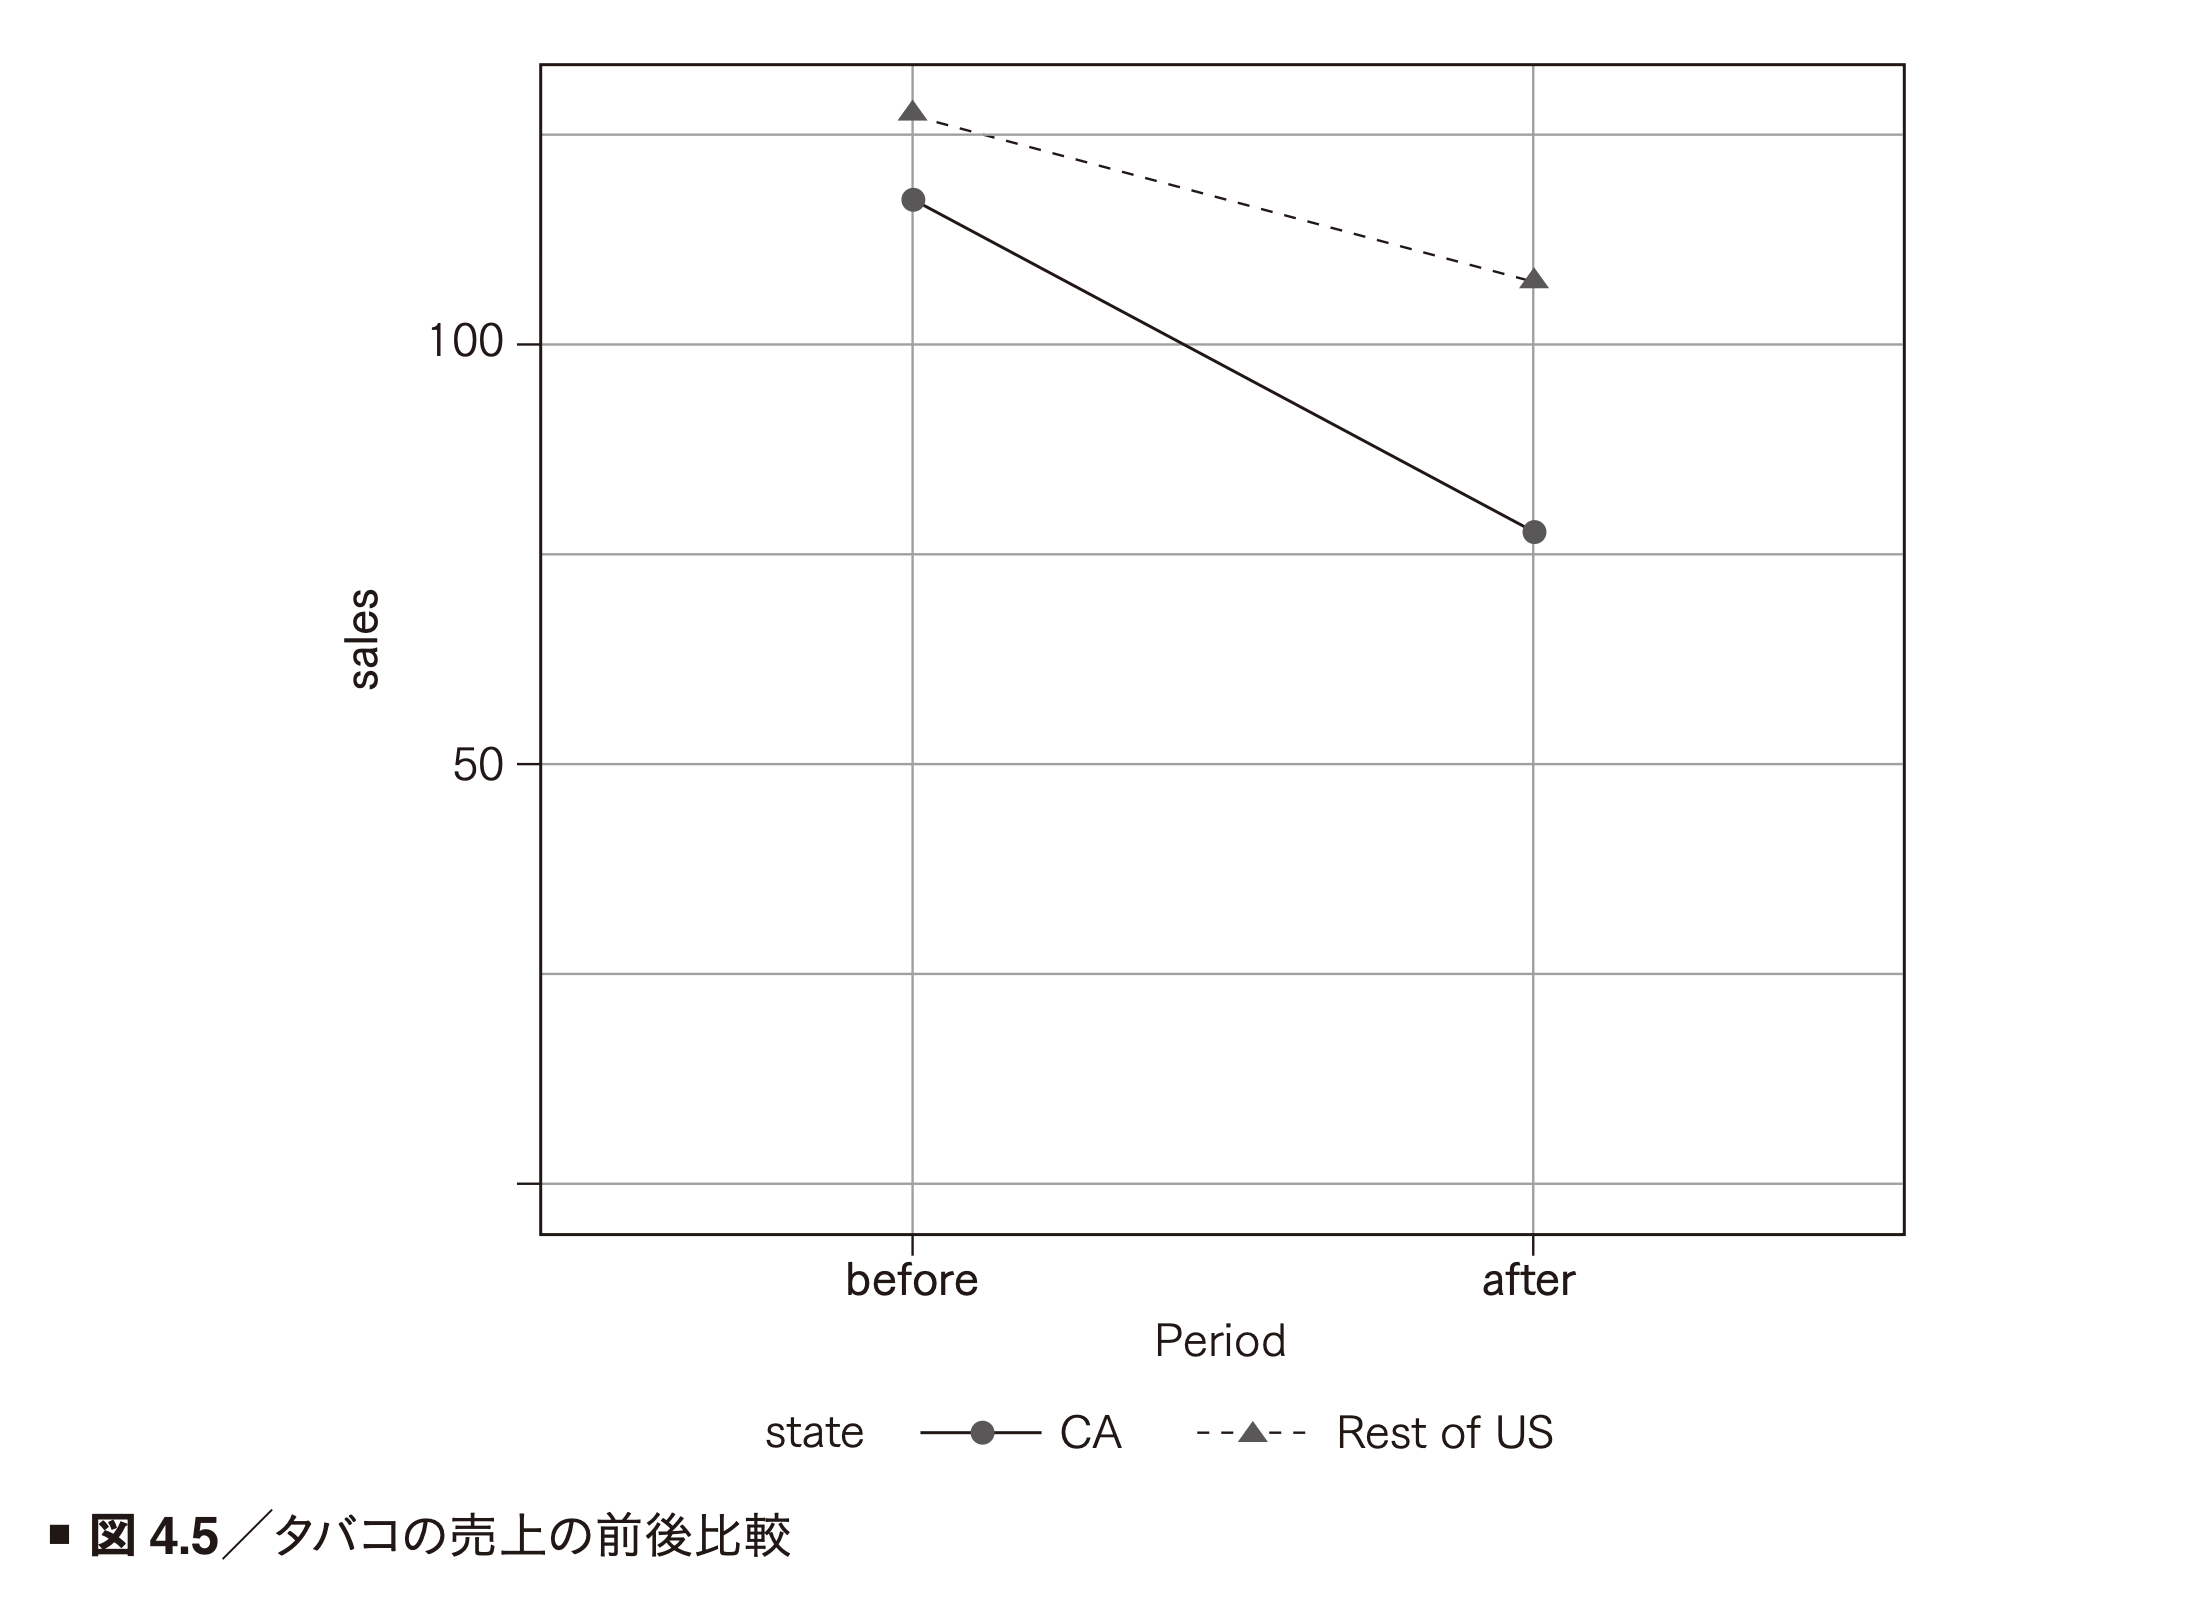
図4.5はこの表をプロットしたものである。カリフォルニア州では40箱程度売上が減少しているが、他の州でも20箱程度減少している。このことから、大まかには 箱程度の減少がProposition 99の影響だと考えられる。
回帰によるDID:年ダミーを加える
次に、カリフォルニア州とそれ以外の州の売上を使ったDIDを回帰で行う。介入前後の2時点ではなく、23年分の多期間データなので、時間の効果を「前後」の1本のダミーで表すだけでなく、 年ごとの固有の効果 を年ダミーで表す。
はデータがカリフォルニア州なら1、 は介入後の期間なら1となる変数である。 はサンプル が 年のデータなら1になるダミーで、その係数 が年ごとの共通の水準を表す。年ダミーを入れると「1988年以降」を表す は年ダミーの和で表現できてしまうため、 単独の値には意味がなくなる(ソフトウェアがどの年を基準に落とすかで値が変わる)。興味があるのは だけである。
did_sum = weighted_sales(cigar, ["post", "year", "year_dummy", "ca"])
show(ols(did_sum, "sales", ["ca", "post", "ca:post", "year_dummy"]), drop_prefix=("year_dummy",))| term | estimate | std_error | statistic | p_value |
|---|---|---|---|---|
| (Intercept) | 123.6 | 4.63 | 26.7 | 0.000 |
| ca | −9.09 | 2.12 | −4.28 | 0.000 |
| post | −13.9 | 4.53 | −3.06 | 0.006 |
| ca:post | −20.5 | 4.56 | −4.51 | 0.000 |
ca:post の効果量は −20.5 なので、Proposition
99は1人あたりのタバコの売上を20箱程度減少させたことになる。
ca の −9.09
は、介入前からカリフォルニア州の売上が他州より9箱ほど低かったという「州固有の差」である。
介入の効果や時間の効果が比率で影響する可能性を考え、目的変数に対数をとった分析も行う。
did_sum_log = did_sum.with_columns(log_sales=pl.col("sales").log())
show(ols(did_sum_log, "log_sales", ["ca", "post", "ca:post", "year_dummy"]), drop_prefix=("year_dummy",))| term | estimate | std_error | statistic | p_value |
|---|---|---|---|---|
| ca | −0.077 | 0.020 | −3.87 | 0.001 |
| ca:post | −0.253 | 0.043 | −5.96 | 0.000 |
ca:post は −0.253 なので、Proposition
99は売上を25%程度減少させたと読める(正確には
)。
州別データとクラスター標準誤差
教科書のRスクリプトは、州ごとのデータ(37州 × 23年 =
851行)に州ダミーを加えたモデルも推定し、州をクラスターとしたクラスター標準誤差を計算している。本ノートの
ols() で同じことを行う。
did_state = weighted_sales(cigar, ["post", "ca", "year", "year_dummy", "state"]).with_columns(
    state=pl.col("state").cast(pl.String)
)
plain = ols(did_state, "sales", ["ca", "state", "post", "ca:post", "year_dummy"])
clustered = ols(did_state, "sales", ["ca", "state", "post", "ca:post", "year_dummy"], cluster="state")| 標準誤差の種類 | ca:post の推定値 | 標準誤差 |
|---|---|---|
| 通常(独立を仮定) | −17.5 | 5.32 |
| 州でクラスター化 | −17.5 | 2.76 |
推定値は、集計データのときと重み付けの仕方が違うので −17.5 になっている。注目したいのは標準誤差で、この例ではクラスター化した方が 小さく なっている。4.1.5では「自己相関があると通常の標準誤差は過小になる」と述べたが、ここではその逆になっているように見える。これは、介入されたクラスターがカリフォルニア州の1つしかないためである。クラスター標準誤差は「クラスター間のばらつき」から誤差を見積もるが、介入群のクラスターが1つでは介入効果のばらつきをまったく測れず、計算結果は信頼できない。 介入されたクラスターが極端に少ないとき、クラスター標準誤差は「使えば安全」な道具ではない。 この状況での代替手段は、追加手法の節で紹介するプラセボ検定である。
平行トレンド仮定は満たされているか
しかし、カリフォルニア州以外のデータは平行トレンド仮定を満たしているだろうか。これを確認するために、年ごとの売上をプロットする(図4.6)。
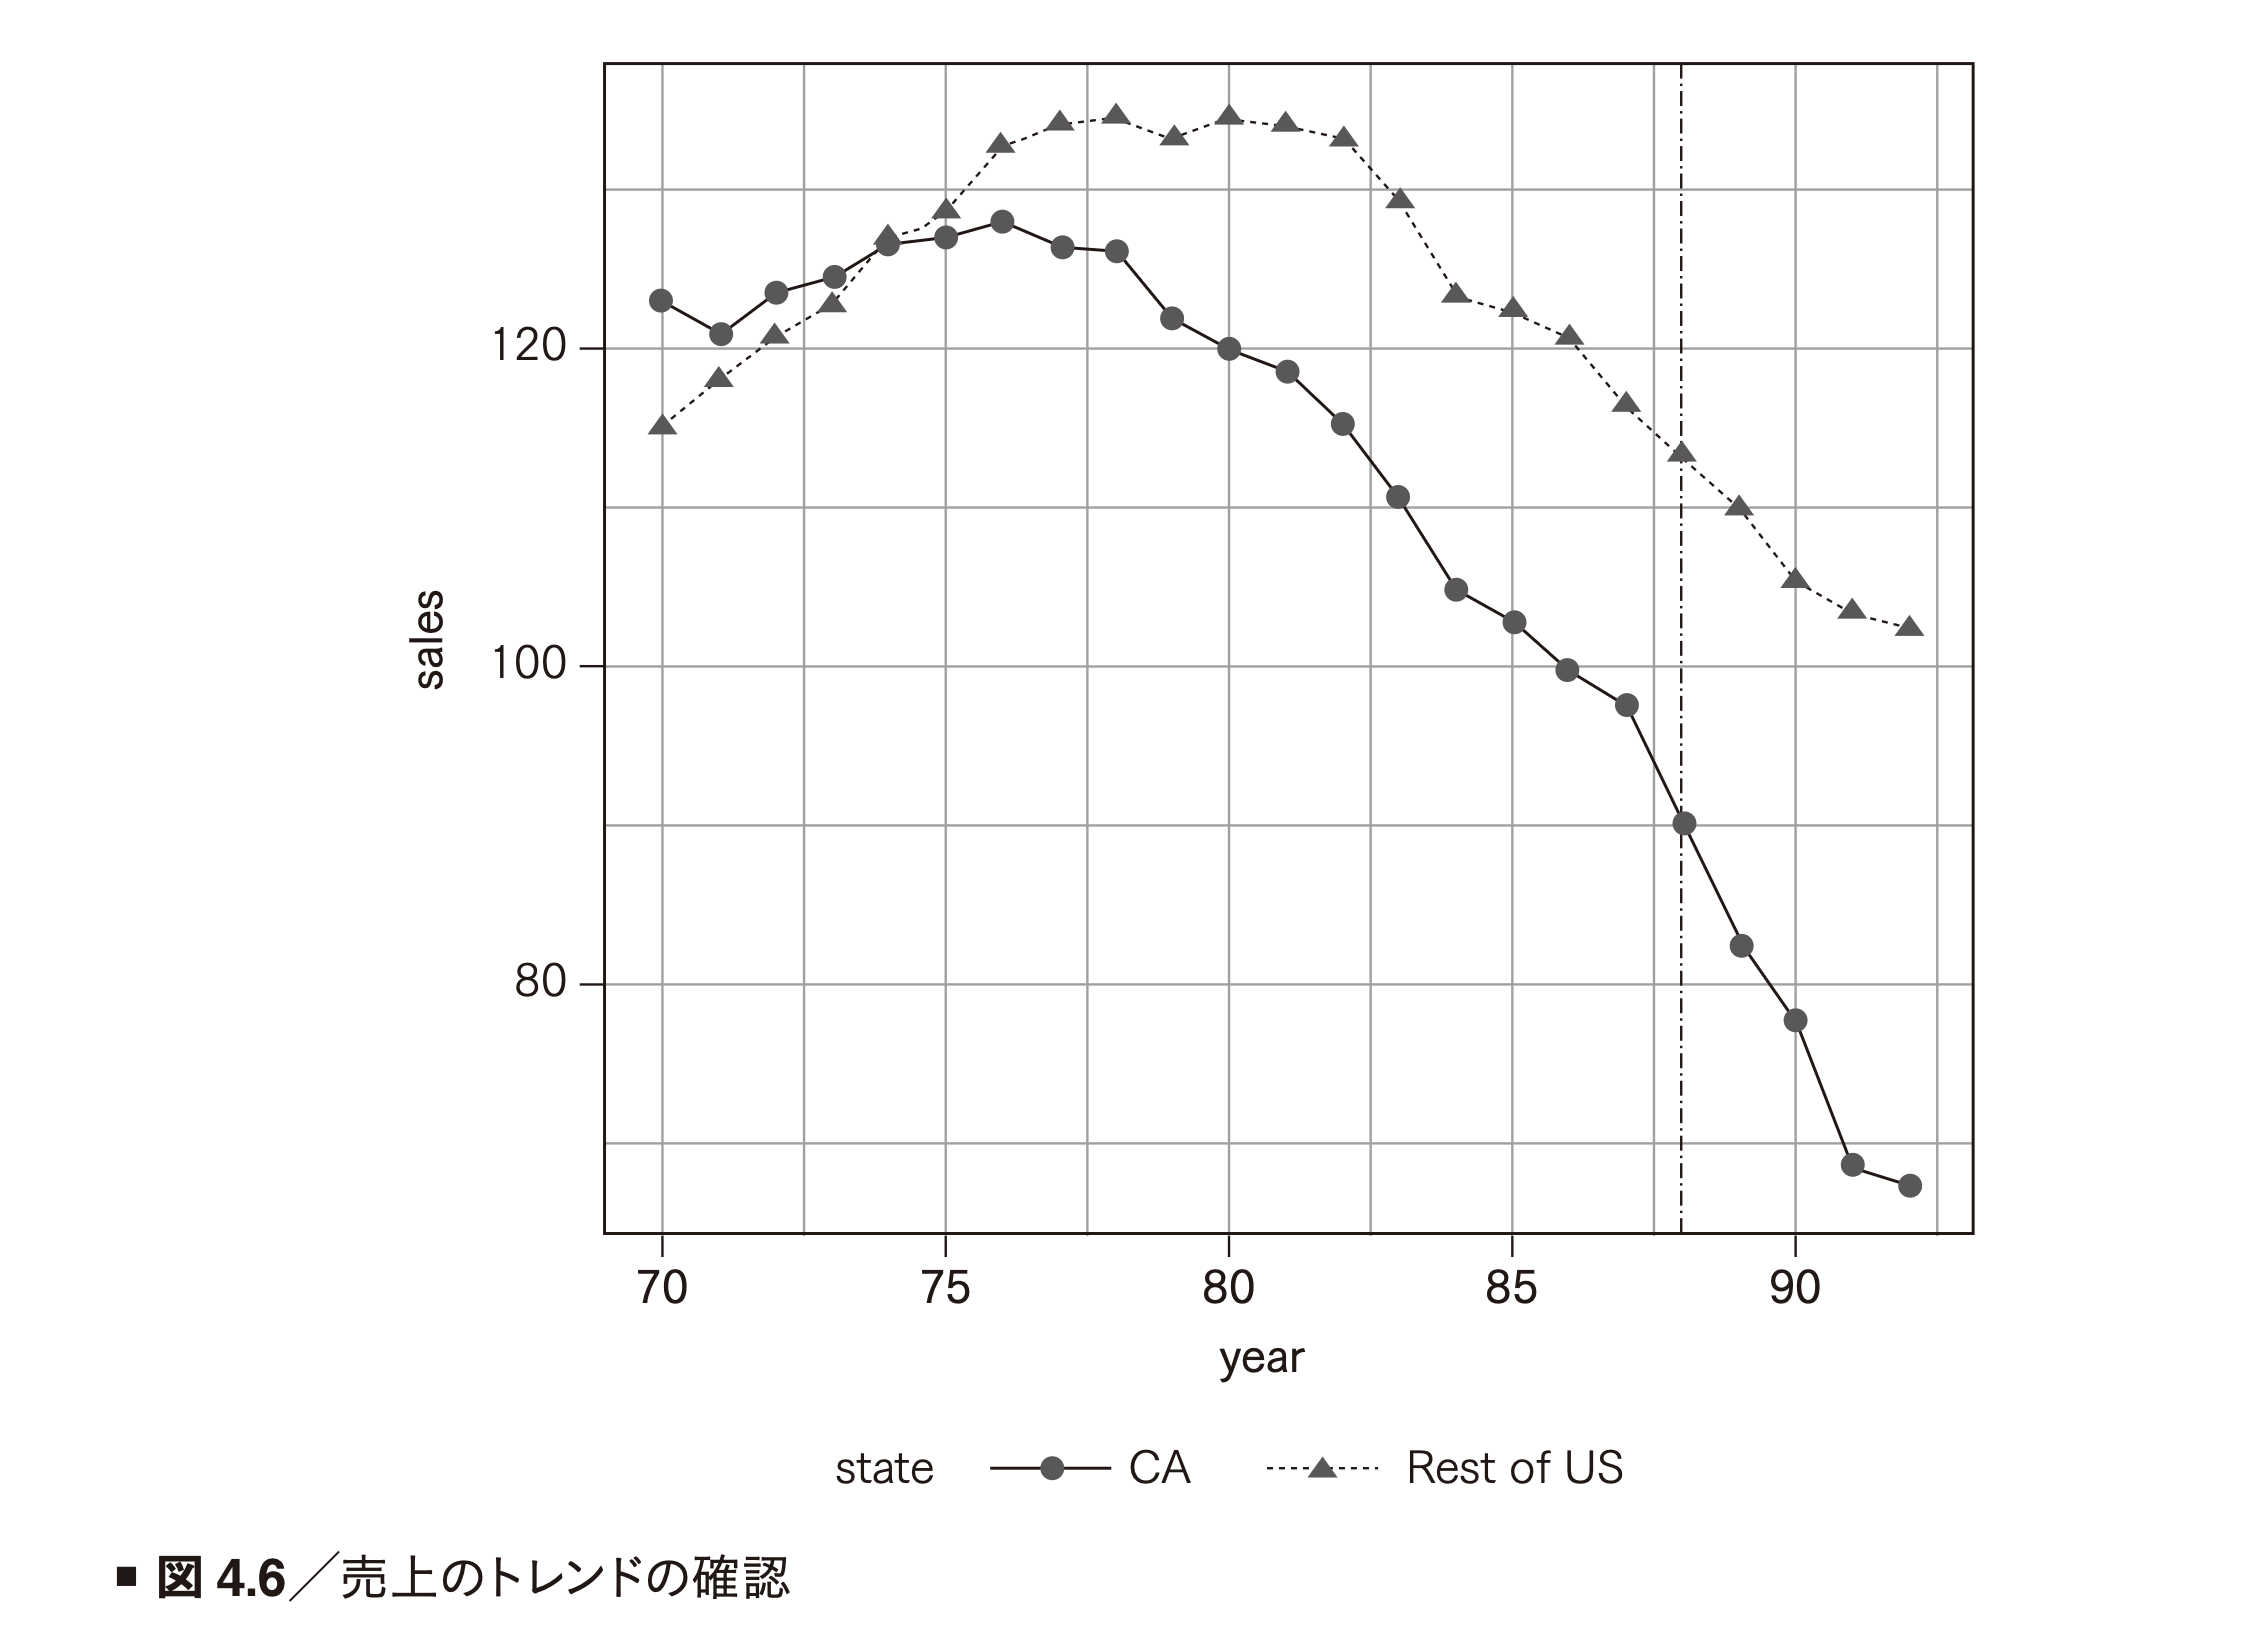
介入前のトレンドは、カリフォルニア州とそれ以外で特に平行に動いているわけではない。1970年代前半は両者がほぼ同じ水準だったが、1970年代後半から他州の売上が伸びる一方でカリフォルニア州は横ばいから減少に転じ、差が開いていっている。数値で確かめると、両者の差(CA − Rest of US)は次のように推移している。
| 年 | 1970 | 1975 | 1980 | 1985 | 1987 | 1988 | 1990 | 1992 |
|---|---|---|---|---|---|---|---|---|
| CA − Rest | +8.0 | −1.5 | −14.2 | −19.7 | −19.0 | −23.3 | −27.5 | −34.9 |
介入前の18年間で差が +8.0 から −19.0 まで一方向に広がっている。つまり、 介入がなくても差は広がり続けていた可能性が高い 。介入後の差の拡大の一部は、この既存のトレンドの延長かもしれない。DIDの −20.5 という推定値は、その分だけ効果を過大に見積もっている疑いがある。この確認の作業(イベントスタディと呼ばれる)は、追加手法の節で改めて扱う。
4.3.3 CausalImpactの実装
CausalImpactを試す。CausalImpactには、目的変数 、予測に使う変数 、介入期間を表す情報を入力する。このとき は、これまで登場したような共変量ではなく、平行トレンド仮定に相当する条件を満たす(介入の影響を受けず、 をよく予測する)変数である。目的変数はカリフォルニア州の売上で、予測変数には他の州の売上を使う。
教科書ではRの CausalImpact
パッケージを使う。Pythonでは、Googleの実装をTensorFlow
Probabilityに移植した tfcausalimpact
パッケージが同等の機能を持つ。ただしTensorFlowへの依存が重いため、本ノートでは同じ構造のモデル(ローカルレベル
+ 回帰)を statsmodels
の状態空間モデルで書き、考え方を再現する。
from statsmodels.tsa.statespace.structural import UnobservedComponents

wide = cigar.select("state", "year", "sales").pivot(on="state", index="year", values="sales").sort("year")
years = wide.get_column("year").to_numpy()
y = wide.get_column(str(CA)).to_numpy().astype(float)           # カリフォルニア州の売上
others = [c for c in wide.columns if c not in ("year", str(CA))]
x_all = wide.select(others).to_numpy().astype(float)              # 他の州の売上(列 = 州)
pre, post = years < 88, years >= 88

# R 版のスパイク・スラブによる変数選択の代わりに、介入前の相関が高い 3 州を使う
corr = np.array([np.corrcoef(y[pre], x_all[pre, j])[0, 1] for j in range(x_all.shape[1])])
top = np.argsort(-corr)[:3]
x = x_all[:, top]

# 介入前だけで「ローカルレベル + 回帰」モデルを学習し、介入後の X を入れて反実仮想を予測する
fit = UnobservedComponents(y[pre], level="llevel", exog=x[pre]).fit(disp=False)
forecast = fit.get_forecast(steps=int(post.sum()), exog=x[post])
pred = forecast.predicted_mean
effect = y[post] - pred                     # pointwise effect
cumulative = np.cumsum(effect)              # cumulative effect
結果は次のようになった。
| year | actual | predicted | lower95 | upper95 | pointwise_effect | cumulative_effect |
|---|---|---|---|---|---|---|
| 1988 | 90.1 | 94.8 | 92.1 | 97.5 | −4.7 | −4.7 |
| 1989 | 82.4 | 93.7 | 89.8 | 97.5 | −11.3 | −15.9 |
| 1990 | 77.8 | 93.1 | 88.4 | 97.7 | −15.3 | −31.2 |
| 1991 | 68.7 | 88.1 | 82.7 | 93.5 | −19.4 | −50.5 |
| 1992 | 67.5 | 88.3 | 82.3 | 94.3 | −20.8 | −71.3 |
| Average | Cumulative | |
|---|---|---|
| Actual | 77.3 | 386 |
| Prediction | 91.6 | 458 |
| Absolute effect | −14.3 | −71 |
| Relative effect | −15.6% | −15.6% |
教科書のRによる CausalImpact の出力は、平均の効果が
−14(標準偏差7.5、95%信用区間 [−36, −0.79])、累積が −70、比率で −15%
であった。本ノートの簡易版でも平均 −14.3、累積 −71、比率 −15.6%
と、点推定はほぼ一致している。一方で区間はRの出力よりかなり狭い。これは、本ノートの実装が最尤推定でパラメータを一点に決めてしまい、パラメータの不確かさを無視しているためである。R版はベイズ推定でパラメータの不確かさも含めて事後サンプルから区間を出すので、正直に広い区間になる。
区間の妥当性まで含めて結果を使うなら、
tfcausalimpact
のようなベイズ実装を使うべきである。
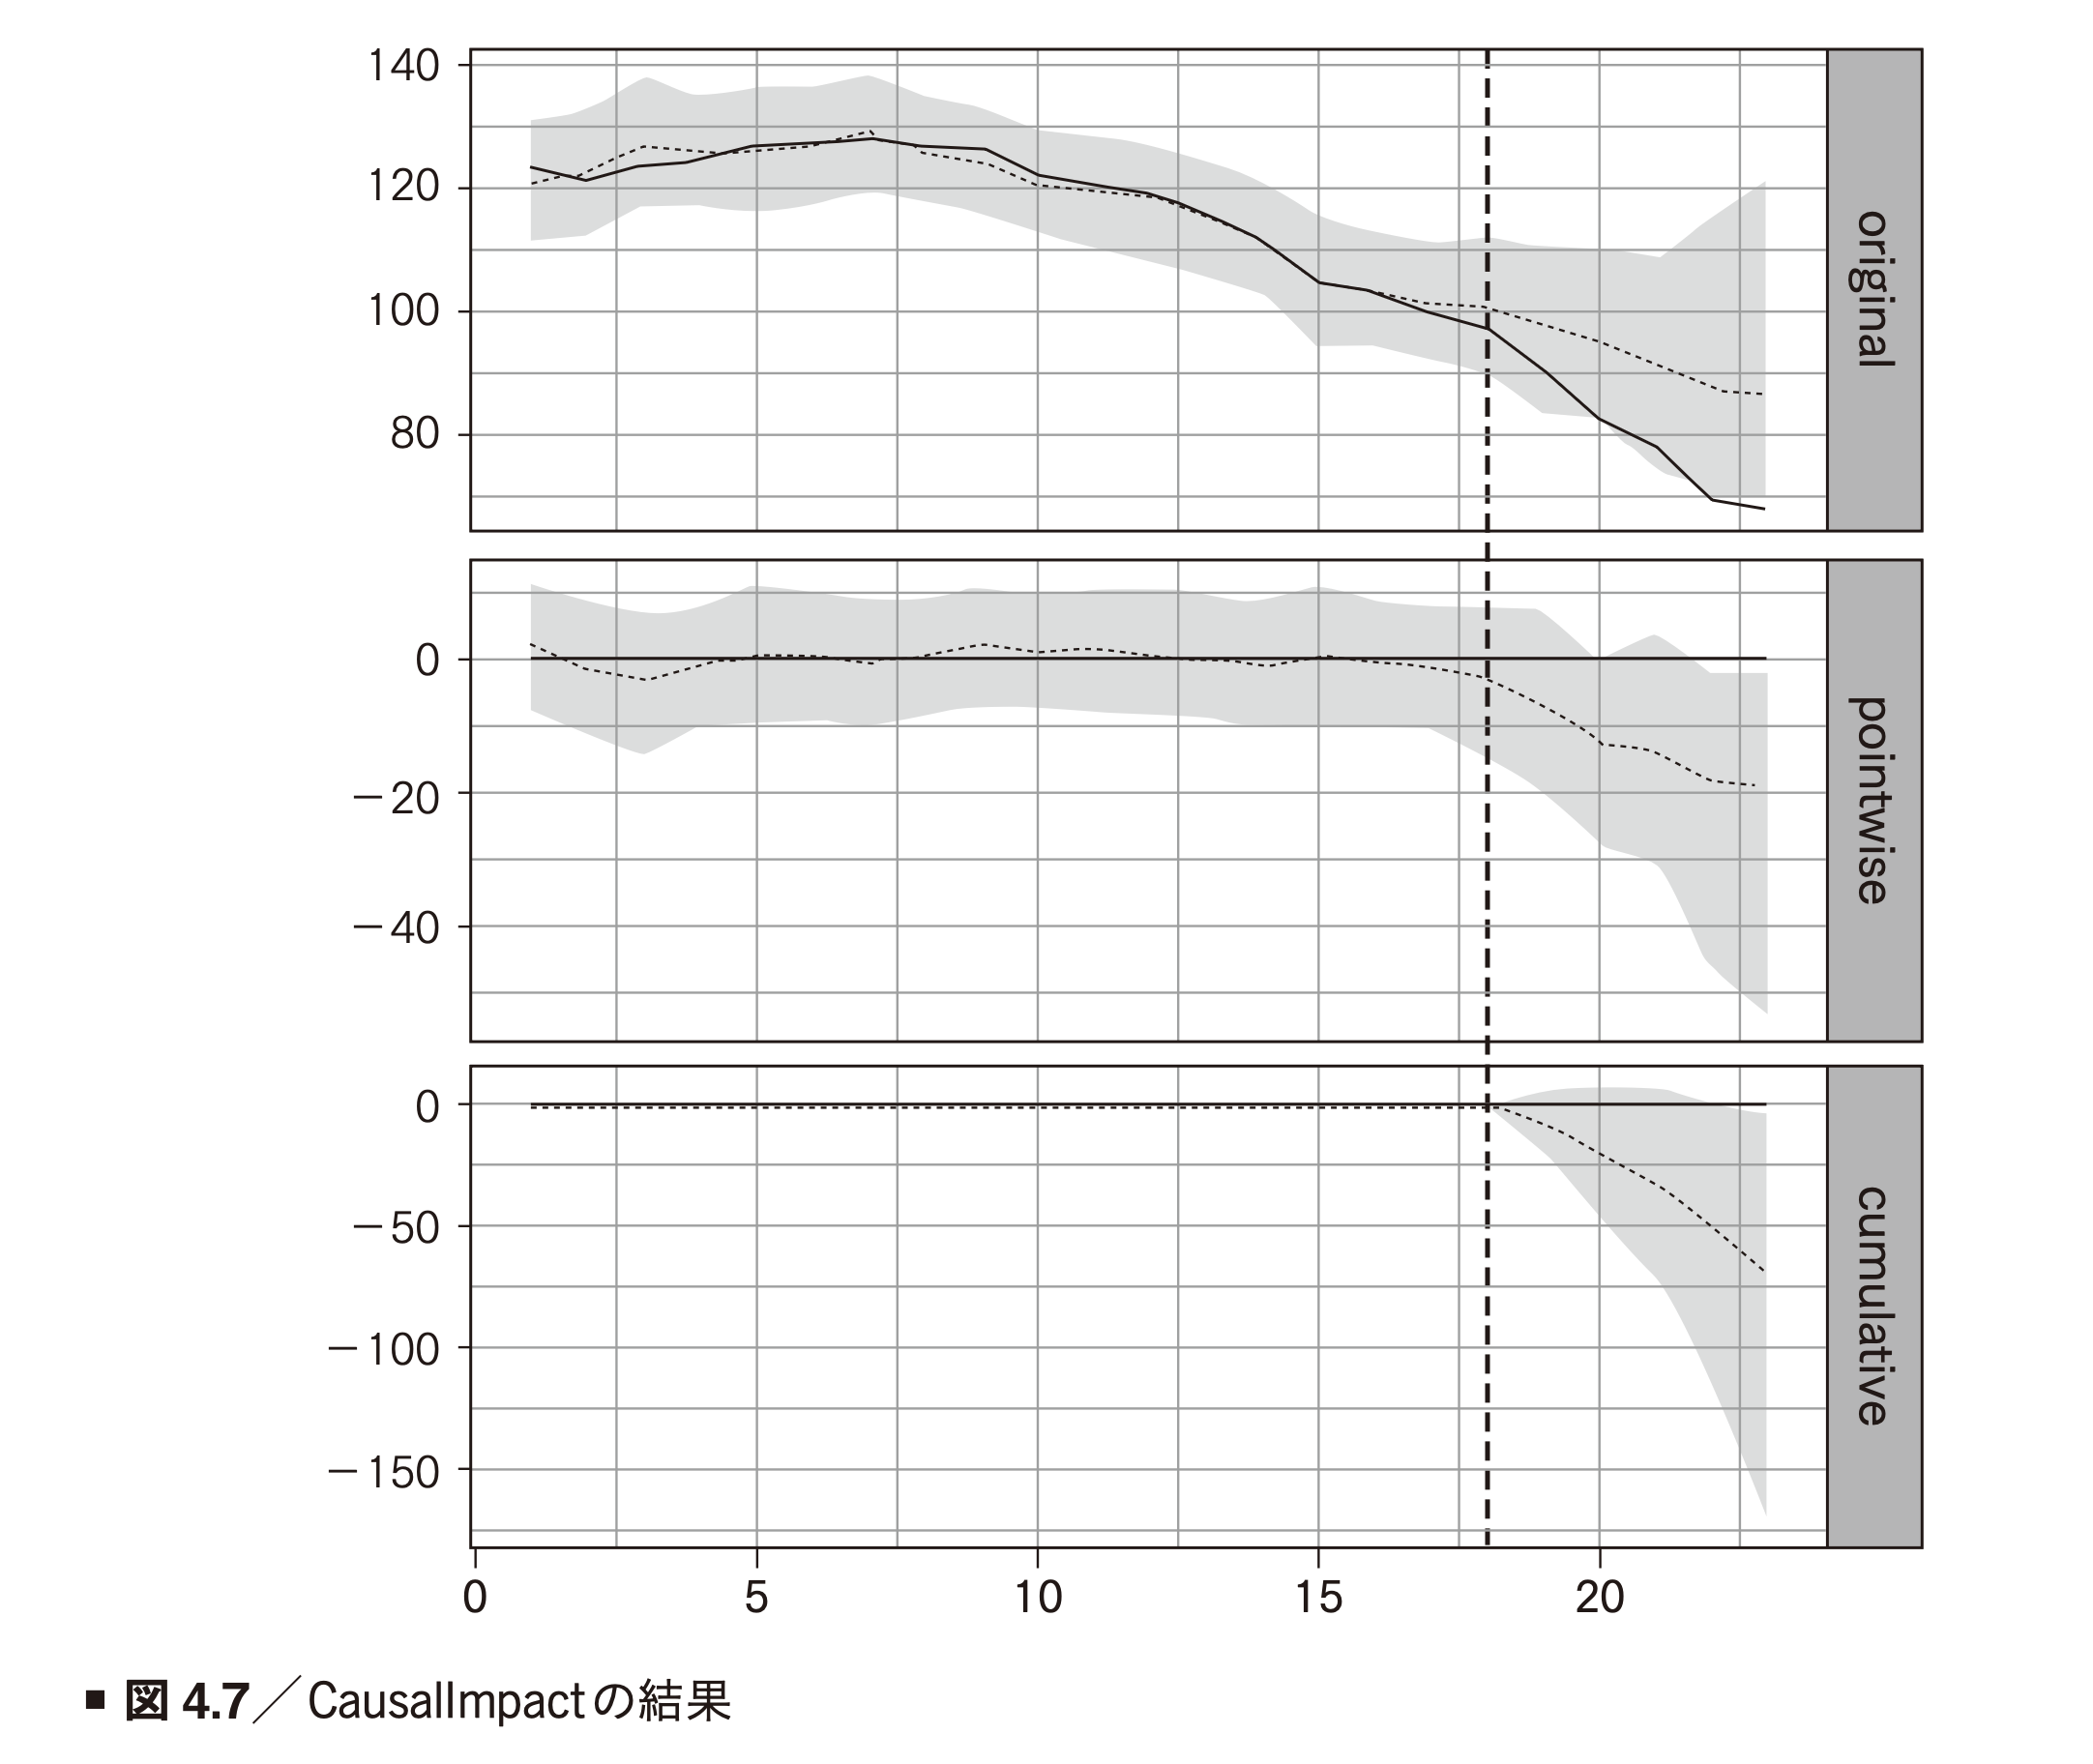
図4.7はRの plot(impact)
の出力で、上から「original」「pointwise」「cumulative」の3つのグラフからなる。
- original は、カリフォルニア州のタバコ売上(実線)と、その予測値(破線)を横軸に時間をとって描いたものである。灰色の帯は予測の信用区間である。介入開始を示す縦の破線の前では実線と破線がほぼ重なっており、介入後に乖離が生まれていることが分かる。
- pointwise は、originalの実測値と予測値の差を各時点で描いたもので、 各時点における介入の効果 を示す。介入前は0付近をうろつき、介入後に徐々に負の方向へ大きくなっている。
- cumulative は、pointwiseの値を介入開始以降で積み上げたものである。Proposition 99は売上を減らすので、下に向かって増えていく。
pointwiseのグラフから分かる通り、CausalImpactの特徴は 各時点で効果を推定できる 点にある。DIDでは介入開始後の平均の効果しか分からない。段階的に強化されるような介入であっても、その効果の推移を見ることができる。
Rの出力では、Absolute effectが効果を実際の箱数で表しており、左側(Average)に平均的な効果、右側(Cumulative)に積み上げの効果が示される。それぞれのカッコ内は標準偏差である。95%の信用区間に0が含まれるか否かを考えることは、有意差検定に類似した情報を与える。教科書の出力では区間 [−36, −0.79] に0を含んでいないため、効果が0である可能性は低いと判断している。比率での効果はRelative effectとして報告され、解釈はAbsolute effectと同じである。
4.3.4 分析結果の比較
この分析の元となったAbadie et al. (2010) は、 合成コントロール(Synthetic Control) という手法を使っている。合成コントロールでは、まず各州の経済や人口の状況が介入前にカリフォルニア州と類似している州をアルゴリズムで抽出する。抽出された州は介入前にカリフォルニア州と似たトレンドを持っているので、平行トレンド仮定を満たしていると考えられる。そして抽出された州のデータを重み付き平均して、「合成されたカリフォルニア州」の売上を予測する。
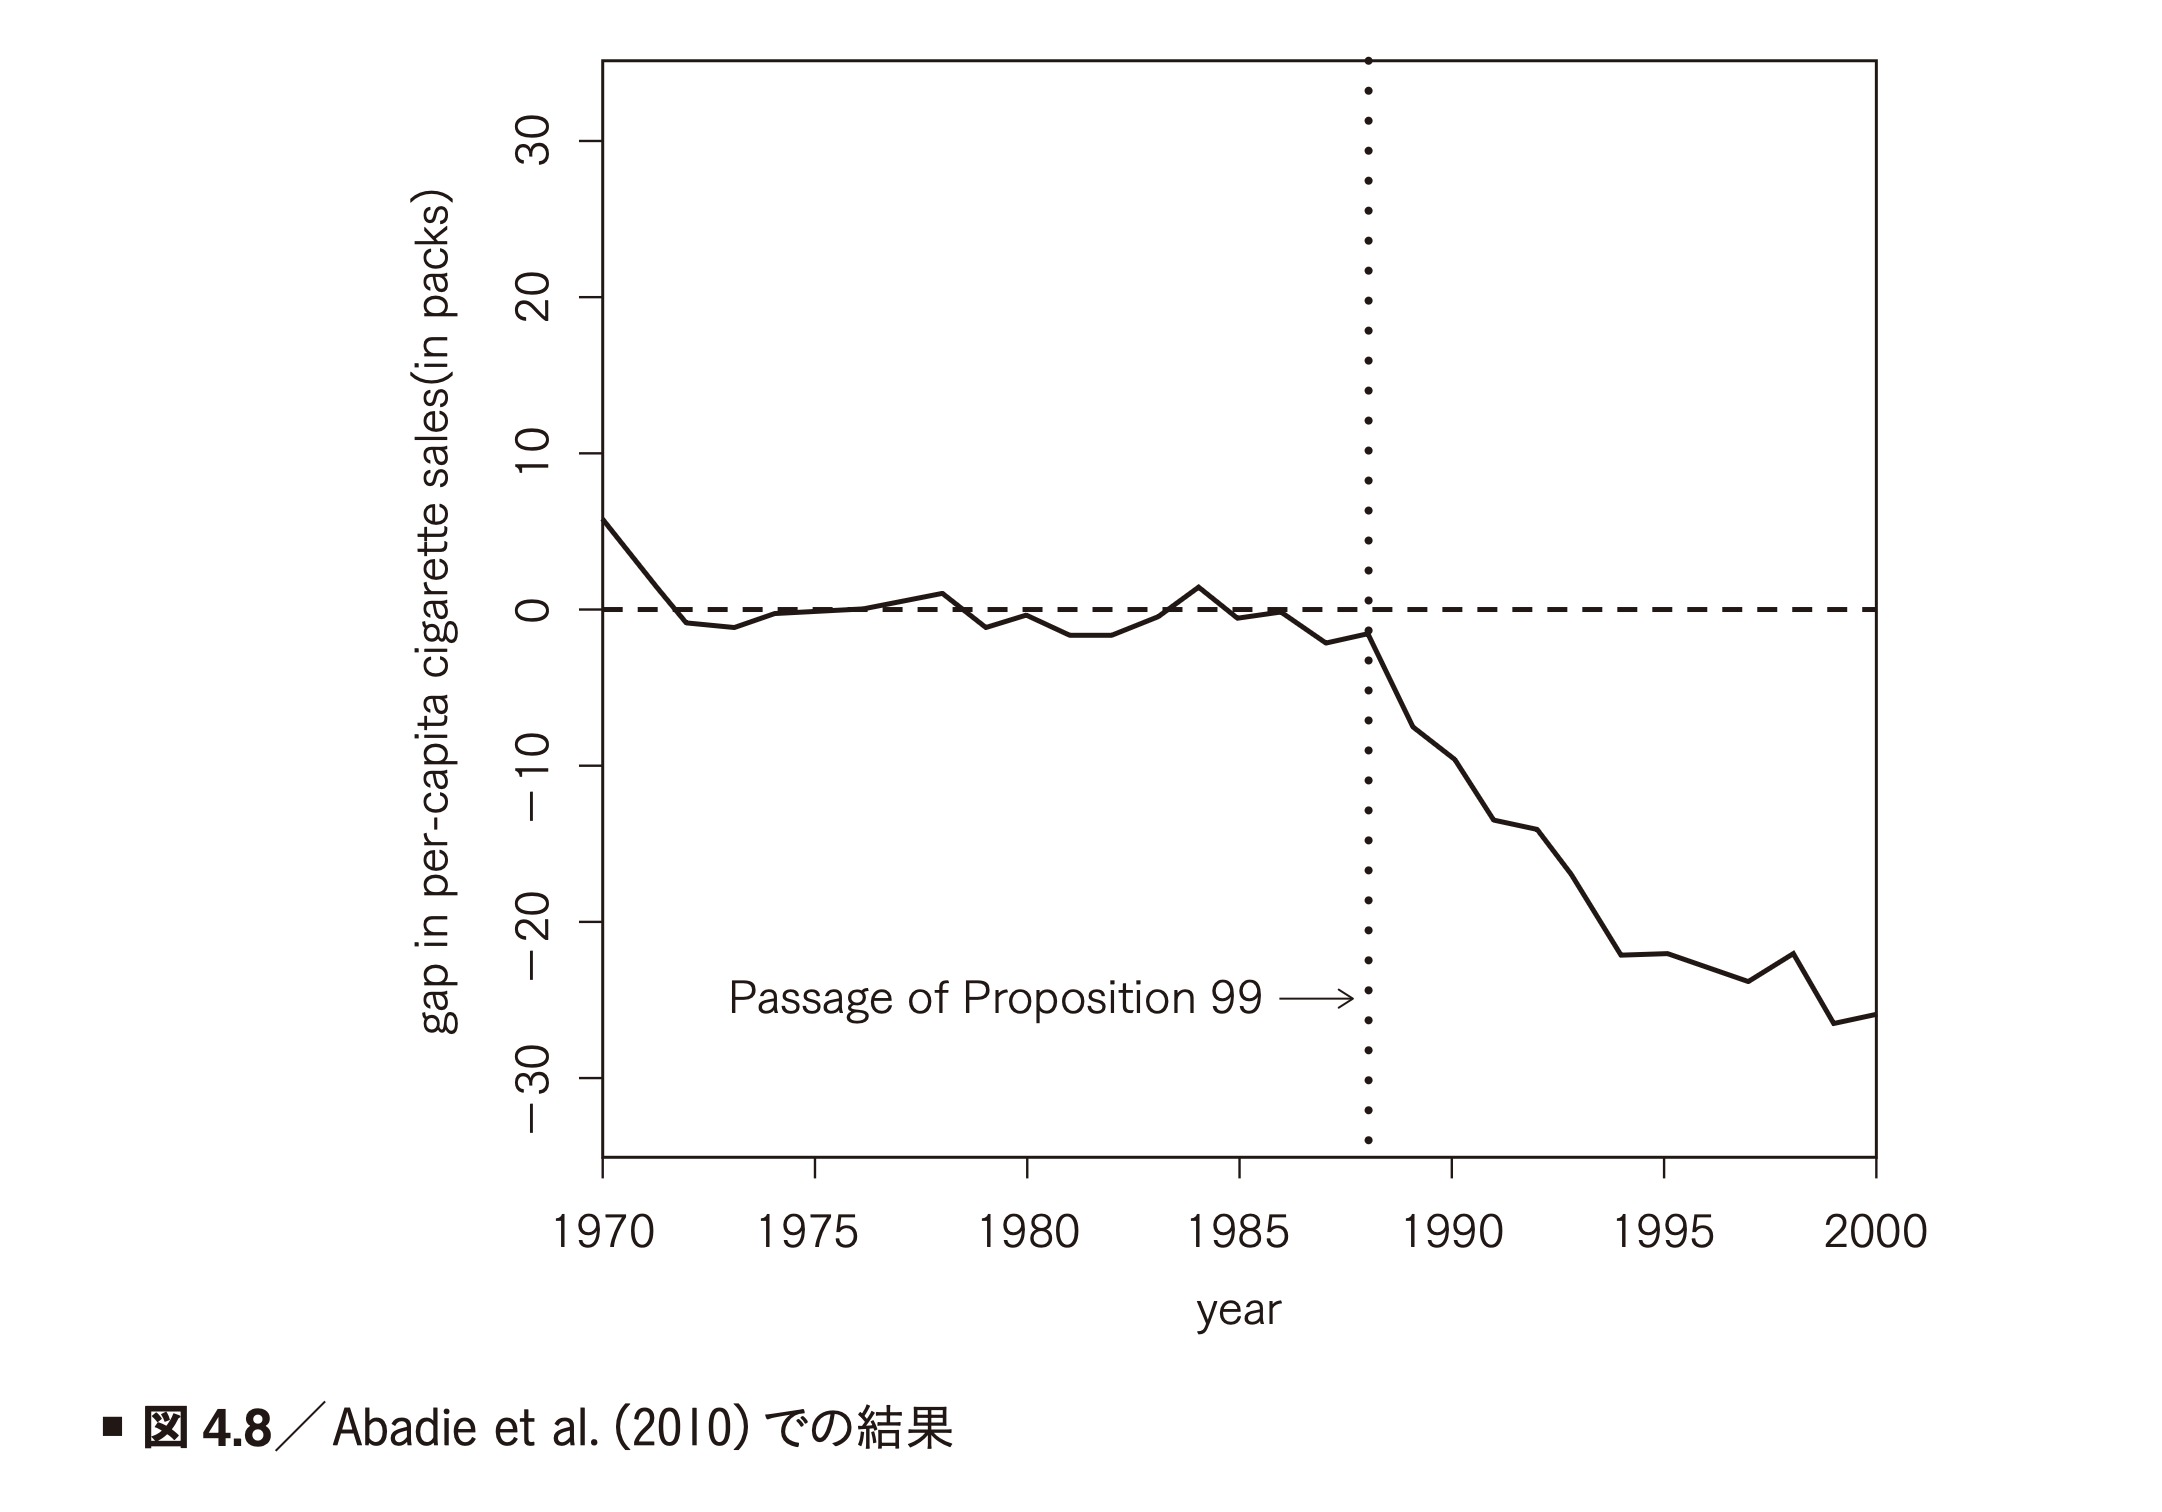
図4.8はAbadie et al. (2010) からの引用で、CausalImpactのpointwiseに対応するグラフである。縦軸は実際のカリフォルニア州と合成コントロールの差(効果量)、横軸は年である。介入を開始した1988年から徐々に売上が低下し、1992年で15箱程度、その後1995年ごろまで効果が強くなり、およそ20箱程度の減少となっている。介入前の期間で差がほぼ0に張り付いていることが、合成コントロールが介入前のカリフォルニア州をよく再現している証拠である。
これに対してDIDの結果は、1988〜1992年の平均的な効果が20箱程度の減少となっており、やや過大に評価されている。これは4.3.2で確認した通り、平行トレンド仮定がうまく満たされていないデータを使っているためだと考えられる。一方でCausalImpactの結果は、徐々に効果が強くなり1992年で18箱前後の減少(本ノートの再現では20.8箱)となっており、推定された効果の傾向にはある程度の類似が認められる。
合成コントロールをPythonで試す
合成コントロールの中心は、非負で合計が1になる重み を求める最適化である。
重みは、介入前の期間で が実際の にもっとも近くなるように選ぶ。Abadie et al. (2010) は売上だけでなく、所得・価格・年齢構成などの共変量も一致させているが、ここでは介入前の売上だけを合わせる簡易版を実装する。
from scipy import optimize

def loss(w: np.ndarray) -> float:
    return float(np.sum((y[pre] - x_all[pre] @ w) ** 2))

n_donor = x_all.shape[1]
result = optimize.minimize(
    loss, x0=np.full(n_donor, 1.0 / n_donor), method="SLSQP",
    bounds=[(0.0, 1.0)] * n_donor,
    constraints=[{"type": "eq", "fun": lambda w: np.sum(w) - 1.0}],
)
synth = x_all @ result.x
gap = y - synth| state | weight |
|---|---|
| 45 | 0.343 |
| 27 | 0.255 |
| 29 | 0.242 |
| 7 | 0.146 |
| 30 | 0.014 |
36の候補州のうち、実質的に重みを持つのは5州だけである。重みが疎になるのは、非負制約と合計1の制約の性質によるもので、「どの州を混ぜたか」が説明しやすいという利点になる。
| 年 | 1975 | 1980 | 1985 | 1987 | 1988 | 1989 | 1990 | 1991 | 1992 |
|---|---|---|---|---|---|---|---|---|---|
| CA | 127.1 | 120.2 | 102.8 | 97.5 | 90.1 | 82.4 | 77.8 | 68.7 | 67.5 |
| 合成CA | 127.1 | 120.5 | 103.8 | 101.0 | 93.3 | 92.1 | 88.7 | 82.2 | 81.8 |
| 差 | 0.0 | −0.3 | −1.0 | −3.5 | −3.2 | −9.7 | −10.9 | −13.5 | −14.3 |
介入前の再現誤差(RMSPE)は1.6箱で、DIDの比較相手であった「他州の平均」とは比べものにならないほどカリフォルニア州の動きを追えている。介入後の差は1992年に −14.3 箱、介入後5年の平均は −10.3 箱である。Abadie et al. (2010) の図4.8(1992年で −15 前後)とおおむね整合しており、DIDの −20.5 が過大であったことが改めて分かる。
三つの手法の結果を並べる。
| 手法 | 比較相手の作り方 | 1988〜92年の平均効果 |
|---|---|---|
| DID(回帰、年ダミー) | 他州の人口重み付き平均 | −20.5 箱 |
| CausalImpact(本ノートの簡易版) | 介入前の相関が高い3州で予測 | −14.3 箱 |
| 合成コントロール(簡易版) | 5州の非負重み付き平均 | −10.3 箱 |
比較相手は分析者が選ぶ。係数 1 の固定、平均効果のみ。
必要: 非介入グループの前後データ
介入前に予測モデルを学習。X は何でもよく、自動で選ぶ。各時点の効果と区間が出る。
必要: 介入前の十分な期間と、介入の影響を受けない X
非負・合計 1 の重みで比較相手を合成。重みが疎で説明しやすい。
必要: 多数の候補ユニットの前後データ
4.4 不完全な実験を補佐する
DIDやCausalImpactは、実験が限定的にしか行えない環境で非常に重宝される検証方法である。実験の承諾が得られても、地域単位にしか介入できなかったり、実験できる地域が限られたりすることはよくある。これらの手法はそのような場合でも効果の分析を可能にする。さらに、 A/Bテストでの検証が本質的に不可能、あるいは非常に難しい場合 にも利用できることがある。
教科書の例はネット広告のオークションである。メディアが広告収益を最大化するには最低入札額(フロアプライス)の設定が重要だと知られている。複数回のオークションで、2種類のフロアプライス設定ルールAとBをランダムに選び、どちらが売上を高くするか検証したいとする。本当に知りたいのは、 入札者がルールAに最適化した場合とルールBに最適化した場合の比較 である。
しかし、実験を行っていることを入札者が知らなければ、入札者にはルールAとBが混ざった別のルールCが適用されているように見える。その結果、入札者はルールCに対して最適な入札を行うようになる。これでは、得られたデータで平均を比べても本来比較したい状況ではなくなっており、単純なRCTは最適な検証方法ではない。このような状況でも、DIDは平行トレンド仮定を満たすデータがあれば効果を検証できる。フロアプライスを変動させる広告枠とそうでない広告枠を設定し、データが得られたところでDIDを実行すればよい。
Huluでの同じ構造:介入が「他の腕」に漏れる
推薦システムでも、ユーザ単位のA/Bテストが「本来比較したい状況」を作れないことがある。
- 人気度に基づく特徴量の共有 。「いま人気」トレイのランキングが全ユーザの再生ログから計算されている場合、半分のユーザに新しいロジックを配信すると、その視聴が人気度に流れ込み、旧ロジックのユーザのランキングも変わる。両腕が互いに影響し合うので、「新ロジックを全員に配信した世界」と「旧ロジックを全員に配信した世界」の比較にはならない。
- 在庫や供給側の制約 。TVODの割引施策では、半分のユーザにだけ割引を出すと、割引を受けなかった側の購入も(口コミなどを通じて)変わり得る。
- 世帯内の複数プロフィール 。同じテレビを家族で使う場合、プロフィール単位の割り当ては相互に漏れる。
こうした「干渉」があるときは、介入の単位を 時間 (ある週は新ロジック、次の週は旧ロジックというスイッチバック)や デバイス・地域 に切り替え、DIDやCausalImpactで分析する方が、比較したい世界に近づける。
4.4.1 DIDのアイデアを用いた分析が使えないとき
DIDやCausalImpactでは、効果を分析したい介入が 他の介入や施策と同時に導入される 場合、その効果を分析できない。ある広告の効果を知りたいときに、広告の開始と同時に商品の値下げを行っているような状態を考える。このときDIDやCausalImpactで正の効果が推定されても、その結果は広告の効果と値下げの効果が混ざったものになる。価格が頻繁に変動する場合には、価格を共変量としてモデルに入れることでこの問題を解決できる。実際、このようなデータが手に入ることは珍しくない。
何かの介入を行う際に、その開始のタイミングを揃えることがよくある。マーケティングでは、商品の入れ替え、Webページの刷新、広告が同一のタイミングで始まる。こうしたケースでは、どれか一つの効果を推定することはほぼ不可能である。このような広告と他の施策とのタイミングの重なりが生むバイアスは、マーケティングの分析者の間で アクティビティバイアス(Activity Bias) と呼ばれている。
配信開始日 −7日
新シーズンの予告映像をホームに掲出
配信開始日
配信開始 + 全ユーザへプッシュ通知 + 新推薦モデルの投入 + 地上波放送開始
配信開始日 +1日〜
視聴数が急増。しかし何の効果かは分離できない
Huluの推薦開発でこれがもっとも起きやすいのは、 新作の配信開始日 である。配信開始、プッシュ通知、ホームでの訴求、地上波での放送、SNSでの話題化がすべて同じ日に集中する。ここで新しい推薦モデルの投入も同じ日に重ねると、モデルの効果は永久に分離できなくなる。対策は分析手法ではなく 運用 にある。推薦モデルの投入日は配信イベントから意図的にずらす、あるいは施策ごとに開始日を1〜2週間ずらすだけで、DIDやCausalImpactが使えるデータになる。
教科書にない追加手法:第4章を実務で強化する
第4章の手法は考え方が単純な一方で、実務で使うには「仮定をどう確かめるか」「標準誤差をどう出すか」「介入時期がばらばらのときはどうするか」といった問題に直面する。ここでは、これらに答える手法を紹介する。
1. イベントスタディと事前トレンドの確認
平行トレンド仮定を「見る」もっとも標準的な方法が イベントスタディ である。介入前後の各時点について、介入グループと非介入グループの差を、介入直前の時点を基準として推定する。回帰では、年ダミーと介入グループの交互作用項を(基準年を除いて)すべて入れる。
は介入の開始時点で、 は介入から 期後(負なら前)における差の変化である。介入前の ( )がすべて0付近なら、平行トレンドが介入前に成り立っていたことの証拠になる。介入後の は、時点ごとの効果になる。
Proposition 99のデータで、1987年を基準にしたCAと他州の差の変化を計算すると次のようになる(追加手法のためスクリプトに含めてある)。
| 年 | 1970 | 1975 | 1980 | 1983 | 1985 | 1987 | 1989 | 1991 | 1992 |
|---|---|---|---|---|---|---|---|---|---|
| 差の変化(1987年基準) | +27.0 | +17.5 | +4.8 | +0.5 | −0.6 | 0.0 | −8.6 | −15.8 | −15.9 |
1983年以降は0付近で安定しているが、1970年代は大きく正であり、介入前を通して平行だったとは言えない。これは、DIDの比較期間を1983年以降に絞る、あるいは合成コントロールを使うといった判断の根拠になる。
事前トレンドの検定には限界もある。Roth (2022) は、「事前トレンドが有意でない」ことは「平行トレンドが成り立つ」ことを意味せず、検定の検出力が低いだけであることが多いと指摘している。Rambachan and Roth (2023) の HonestDiD は、「介入後のトレンドの乖離は、介入前に観測された乖離の 倍以内」という形の仮定を明示的に置き、その下で効果の区間を出す。平行トレンドを「成り立つか否か」ではなく「どれだけ破れても結論が変わらないか」という感度分析として扱う考え方である。
2. 介入時期がばらばらのとき:Staggered DID
実務では、介入の開始時期がユニットごとに異なることが多い。たとえば新しい推薦モデルを、Fire TVに4月、Android TVに5月、iOSに6月と順次展開する場合である。この場合、すべての交互作用項を一つの で表す 二方向固定効果(TWFE)回帰 をそのまま使うと、Goodman-Bacon (2021) が示したように、「すでに介入されたユニット」が「あとから介入されるユニット」の比較相手として使われてしまう。効果が時間とともに変化する場合、この比較は誤った符号すら生む。
対策として、Callaway and Sant’Anna (2021)
は、介入開始時期のコホートごと・時点ごとの効果
を「まだ介入されていないユニット」だけを比較相手にして推定し、それらを集計する方法を提案した。Sun
and Abraham (2021)
も同様に、コホートごとの交互作用項を使う推定量を提案している。Pythonでは
pyfixest パッケージや differences
パッケージがこれらを実装している。
順次展開の効果をDIDで測るなら、単純なTWFE回帰ではなく、これらの推定量を使うべきである。
3. 合成コントロールの発展:Synthetic DID と Augmented SC
4.3.4で試した合成コントロールにはいくつかの弱点がある。介入前の再現が完全でないと効果にバイアスが残ること、統計的な推論が難しいこと、介入ユニットが候補ユニットの「凸包」の外にあると再現できないことである。
- Augmented Synthetic Control(Ben-Michael, Feller, and Rothstein, 2021)は、合成コントロールの介入前の再現誤差を、リッジ回帰などの結果モデルで補正する。介入前の再現が悪いときにバイアスを減らせる。
- Synthetic DID(Arkhangelsky et al.,
2021)は、合成コントロールの「ユニット方向の重み」に加えて「時点方向の重み」を導入し、DIDのように水準の差を許容しながら重み付きの差分の差分を計算する。合成コントロールとDIDの両方を特殊ケースとして含み、どちらよりも頑健な推定ができることが示されている。Rの
synthdidパッケージが標準実装で、Pythonではpysynconが合成コントロール系の手法を提供している。
4. 介入ユニットが1つのときの推論:プラセボ検定
4.3.2で見たように、介入されたクラスターが1つ(カリフォルニア州だけ)のとき、クラスター標準誤差は信頼できない。Abadie et al. (2010) が用いた代替手段が プラセボ検定(permutation test) である。
考え方は単純で、「介入されていない各州を、順番に介入されたと見なして同じ分析を行い、本物の効果がその分布の中でどれだけ極端かを見る」というものである。効果の大きさの指標には、介入後の再現誤差と介入前の再現誤差の比(RMSPE比)を使う。介入前は再現がうまくいき、介入後だけ乖離が大きい州ほど、この比が大きくなる。
スクリプトでは36の候補州すべてで合成コントロールを繰り返し、RMSPE比を並べた。
| 順位 | 州コード | RMSPE比 |
|---|---|---|
| 1 | 26 | 21.9 |
| 2 | 47 | 12.2 |
| 3 | 44 | 10.5 |
| 4 | 39 | 7.1 |
| 5 | 5(カリフォルニア) | 6.9 |
| 6 | 20 | 5.8 |
カリフォルニア州は37州中5位で、プラセボ p 値はおよそ である。Abadie et al. (2010) の本来の分析では、共変量も使ってより良い再現をし、かつ2000年までの長い介入後期間を使っているため、カリフォルニア州が最上位(p 値 )になっている。本ノートの簡易版では介入後が5年しかなく、効果が最大になる1995年以降を含んでいないため、順位が下がっている。 結果が違うこと自体が重要な教訓である。 合成コントロールの結論は、候補ユニットの選び方、一致させる変数、介入後の期間の長さに敏感であり、これらを変えた結果を併記するのが誠実な報告である。
DIDでクラスターが少ない場合には、 wild cluster bootstrap(Cameron, Gelbach, and Miller, 2008)も使われる。クラスターごとに残差の符号をランダムに反転させて疑似データを作り、統計量の分布を得る方法で、クラスター数が5〜10程度でも比較的うまく働くことが知られている。Conley and Taber (2011) は、介入クラスターが少数で非介入クラスターが多数ある場合に、非介入クラスターの残差の分布から介入効果の区間を作る方法を提案している。
5. 地域・時間単位の実験を設計する:Geo実験とスイッチバック
第4章の手法は「すでに起きた地域単位の介入」を事後分析するものだが、 最初から地域や時間の単位で実験を設計する 方法も発展している。
- Geo実験(Vaver and Koehler, 2011)は、地域をランダムに介入群と非介入群に割り当て、DIDや合成コントロールで効果を測る。Metaの GeoLift はこの設計を支援するオープンソースパッケージで、介入前データから「どの地域を介入群にすれば検出力が最大になるか」を選び、Augmented Synthetic Controlで分析する。
- スイッチバック実験 は、時間をブロック(たとえば1時間や1日)に分け、ブロックごとにランダムに介入と非介入を切り替える。フードデリバリーや配車サービスのように、ユーザ単位では干渉が避けられないマーケットプレイスで標準的に使われている。4.4で述べた「人気度の共有」のような干渉があるHuluの推薦施策でも、デバイス単位・日単位のスイッチバックは有効な選択肢である。分析にはブロック内の自己相関を考慮した推定(Bojinov, Simchi-Levi, and Zhao, 2023)が必要になる。
6. Pythonのライブラリ
本ノートでは学習のために回帰と最適化を自分で書いたが、実務では次のライブラリが使える。
| 用途 | パッケージ | 備考 |
|---|---|---|
| 固定効果回帰、クラスター標準誤差、イベントスタディ | pyfixest |
Rの fixest のPython移植。Sun-Abraham推定量も持つ |
| パネル回帰 | linearmodels |
PanelOLS に固定効果とクラスター標準誤差 |
| Staggered DID(Callaway-Sant’Anna) | differences |
|
| CausalImpact | tfcausalimpact |
R版と同じベイズ構造時系列モデル。TensorFlow Probabilityに依存 |
| 合成コントロール、Augmented SC、Synthetic DID | pysyncon |
|
| 状態空間モデル | statsmodels |
本ノートで使用。 UnobservedComponents |
Huluの推薦施策をDID・CausalImpactで評価する設計
最後に、第4章の内容をHuluの実務に落とし込むときの設計を、二つの状況に分けてまとめる。
プロフィール単位でランダム → 第1章のRCT。素直に平均を比べる。
プロフィール単位だがルールで決まった → 第2章の回帰、第3章の傾向スコア。
デバイス・地域単位で、比較相手のデバイスがある → DID。介入前のトレンドを確認し、干渉と同時施策を点検する。
全ユーザ一斉で、比較相手がない → CausalImpact。介入の影響を受けない予測変数を集める。
順次展開で時期がばらばら → Staggered DID(Callaway-Sant'Anna)。
設計例1:Fire TVだけに先行導入した新ホーム構成(DID)
この設計例を、profile_id ×
時間のログから実際にパネルを組んで分析する手順(群の固定、0埋め、イベントスタディ、固定効果回帰、プラセボ検定、報告の書き方)は、実践編ノート
ch4_hulu_device_rollout_did.md
に架空データつきでまとめている。ここでは要点だけを示す。
アウトカム
。日次・デバイス別の「ホームのトレイ経由で再生したプロフィールの割合」または「1プロフィールあたり視聴シリーズ数」。前者はGA4のクリックログと
content_viewing の結合から、後者は
personalize.daily_personalize_viewing_kpi の
series_cnt をデバイスで切って作れる。
content_viewing の device_low_category で
fire_tv と android_tv を区別する。
比較相手 。介入前12週間のアウトカムの推移がFire TVともっとも平行なデバイスを選ぶ。候補はAndroid TV、Apple TV、ゲーム機など、同じ「テレビ画面」のデバイスである。スマートフォンは利用文脈が違い、トレンドの平行性が疑わしい。
モデル
。日次・デバイス別のパネルに対して、デバイス固定効果と日付固定効果を入れたDID回帰を行う。式は4.3.2の年ダミー付きモデルと同じで、
ca をFire TVダミー、年ダミーを日付ダミーに置き換える。
点検事項 。
- 介入前のイベントスタディで、 が0付近か。
- 同時施策の有無。Fire TVアプリのバージョンアップ、Fire TV向けキャンペーンなどが同時期になかったか。
- 干渉。世帯内でFire TVとスマホを併用するプロフィールが多いなら、スマホの視聴も新ホームの影響を受け得る。比較相手はテレビ系デバイスに限る理由の一つである。
- 標準誤差。デバイスは数個しかないので、クラスター標準誤差は信頼できない。他のデバイスを順に「介入された」と見なすプラセボ検定を併用する。
設計例2:全ユーザへの新シーズン訴求(CausalImpact)
アウトカム
。日次の「対象作品を25%以上視聴したプロフィール数」(
unique_viewed_series の登録基準に合わせる)。
予測変数 。介入前90日以上の期間で、次の系列を候補にする。訴求の影響を受けない(あるいは受けにくい)ことが条件である。
- サービス全体の日次アクティブプロフィール数。
- 対象作品と視聴者層の重なりが小さい他ジャンル作品群の日次視聴プロフィール数。同ジャンルの作品はカニバリゼーションで介入の影響を受ける可能性がある。
- 曜日・祝日のダミー。
やってはいけないこと 。対象作品の詳細ページ閲覧数や検索数を予測変数に入れること。これらは訴求の直接の結果であり、入れると効果が消える。
出力の読み方 。pointwiseの効果で「訴求の効果が何日間持続したか」を確認する。訴求の翌日にピークがあり1週間で0に戻るのか、新シーズンの評判で効果が持続するのかは、次の施策の頻度設計に直結する。累積効果を「訴求によって増えた視聴プロフィール数」として報告する。
限界の明示 。訴求と同日に地上波放送や配信開始があれば、その効果と分離できない(アクティビティバイアス)。報告書には同日に起きたイベントを必ず列挙する。
理解を確かめる小問
問1:前後比較で効果があったように見えた。DIDを使うと何が変わるか
前後比較の差には、介入の効果と「介入がなくても起きたはずの変化」(時間の効果)が混ざっている。DIDは非介入グループの前後の変化を時間の効果の推定値として使い、それを差し引く。介入がなくても両グループが同じだけ変化する(平行トレンド)という仮定のもとで、残るのは介入の効果だけになる。
問2:DID回帰で post
の係数が有意でなかった。介入の効果はなかったと言えるか
言えない。 post
の係数は「非介入グループにおける介入後の変化」、すなわち時間の効果であり、介入の効果ではない。介入の効果は交互作用項
treat:post の係数である。年ダミーを入れたモデルでは、
post
の値はそもそも基準年の選び方で変わり、単独では意味を持たない。
問3:Fire TVの日次データを100日分使ったのに、なぜ標準誤差を通常の方法で計算してはいけないのか
同じデバイスの連続する日のアウトカムは互いに似ており(自己相関)、100日分は100個の独立な情報ではない。通常の標準誤差は独立を仮定するので、実際よりも小さく計算され、有意な結果が出すぎる。デバイスをクラスターとした標準誤差を使うのが原則だが、デバイスが数個しかなく介入デバイスが1つなら、クラスター標準誤差も信頼できない。その場合はプラセボ検定を使う。
問4:CausalImpactの予測変数に「対象作品の詳細ページ閲覧数」を使うと何が起きるか
訴求は詳細ページの閲覧を増やすので、この変数は介入の影響を受ける。介入後の予測値も訴求の影響で高くなり、実測との差である効果は過小に、極端な場合は0に推定される。第2章のPost treatment biasと同じ構造であり、介入の影響を受けない変数だけを候補にする。
問5:合成コントロールとDIDの推定値が大きく違った。どちらを信じるべきか
まず介入前の再現を比べる。DIDの比較相手(他州の平均)が介入前に平行でなく、合成コントロールが介入前をよく再現しているなら、合成コントロールの方が平行トレンドの根拠が強い。ただし合成コントロールも、候補ユニットの選び方や介入後の期間の長さに敏感である。両方の結果と、イベントスタディによる介入前の確認、プラセボ検定の順位を併記して報告するのが望ましい。
参考文献
- 安井翔太『効果検証入門:正しい比較のための因果推論/計量経済学の基礎』技術評論社、2020年。第4章。
- Snow, J. (1855). On the Mode of Communication of Cholera. Table 12。データの出典。
- Card, D. (1990). The impact of the Mariel boatlift on the Miami labor market. Industrial and Labor Relations Review, 43(2), 245–257.
- Blake, T., Nosko, C., & Tadelis, S. (2015). Consumer heterogeneity and paid search effectiveness: A large-scale field experiment. Econometrica, 83(1), 155–174.
- Bertrand, M., Duflo, E., & Mullainathan, S. (2004). How much should we trust differences-in-differences estimates? Quarterly Journal of Economics, 119(1), 249–275.
- Angrist, J. D., & Pischke, J.-S. (2014). Mastering ’Metrics. Princeton University Press. 第5章(DID)。
- Brodersen, K. H., Gallusser, F., Koehler, J., Remy, N., & Scott, S. L. (2015). Inferring causal impact using Bayesian structural time-series models. Annals of Applied Statistics, 9(1), 247–274. CausalImpactの原論文。
- Abadie, A., Diamond, A., & Hainmueller, J. (2010). Synthetic control methods for comparative case studies: Estimating the effect of California’s tobacco control program. Journal of the American Statistical Association, 105(490), 493–505.
- Goodman-Bacon, A. (2021). Difference-in-differences with variation in treatment timing. Journal of Econometrics, 225(2), 254–277.
- Callaway, B., & Sant’Anna, P. H. C. (2021). Difference-in-differences with multiple time periods. Journal of Econometrics, 225(2), 200–230.
- Sun, L., & Abraham, S. (2021). Estimating dynamic treatment effects in event studies with heterogeneous treatment effects. Journal of Econometrics, 225(2), 175–199.
- Roth, J. (2022). Pretest with caution: Event-study estimates after testing for parallel trends. American Economic Review: Insights, 4(3), 305–322.
- Rambachan, A., & Roth, J. (2023). A more credible approach to parallel trends. Review of Economic Studies, 90(5), 2555–2591.
- Arkhangelsky, D., Athey, S., Hirshberg, D. A., Imbens, G. W., & Wager, S. (2021). Synthetic difference-in-differences. American Economic Review, 111(12), 4088–4118.
- Ben-Michael, E., Feller, A., & Rothstein, J. (2021). The augmented synthetic control method. Journal of the American Statistical Association, 116(536), 1789–1803.
- Cameron, A. C., Gelbach, J. B., & Miller, D. L. (2008). Bootstrap-based improvements for inference with clustered errors. Review of Economics and Statistics, 90(3), 414–427.
- Conley, T. G., & Taber, C. R. (2011). Inference with “difference in differences” with a small number of policy changes. Review of Economics and Statistics, 93(1), 113–125.
- Vaver, J., & Koehler, J. (2011). Measuring ad effectiveness using geo experiments. Google Inc. 技術レポート。
- Bojinov, I., Simchi-Levi, D., & Zhao, J. (2023). Design and analysis of switchback experiments. Management Science, 69(7), 3759–3777.
- Ecdat パッケージの
Cigarデータセット(Baltagi, B. H. (2001). Econometric Analysis of Panel Data)。Rdatasets(vincentarelbundock.github.io/Rdatasets)から取得。 - ghmagazine/cibook(GitHub)。教科書のRスクリプト
R/ch4_did.R。John Snowデータの値の出典。