第3章 傾向スコアを用いた分析 ― Huluの視聴ログで「比較できる集団」を作る
Huluで新しいアニメ推薦を始めたところ、推薦対象になった人のほうが、対象にならなかった人よりよく視聴していたとする。この結果を見ると、「新しい推薦が役に立った」と考えたくなる。しかし、もともとアニメをよく見る人を優先して推薦対象にしていたなら、推薦がなくても同じような差があったかもしれない。
そこで必要になるのが、推薦対象の選ばれ方を考慮した比較である。この章では、各人の「推薦対象になりやすさ」を確率で表し、それを使って比較を調整する。この確率を 傾向スコア という。
調整の方法は、大きく二つある。一つは、推薦対象になりやすさが近い人同士を選んで比べる方法であり、マッチングという。もう一つは、集計するときに一人ひとりに異なる重みを付け、両群の人の構成をそろえる方法であり、IPWという。まずは、この二つが何を変えているのかを、人数と視聴率の計算から理解していく。
本ノートは教科書の3.1〜3.4に沿って説明する。後半ではPythonで実データを分析し、さらに、結果の予測も組み合わせるAIPWなどの発展的な方法を紹介する。Huluの例に使う人数・確率・施策は、理解のために作ったものである。実サービスで確認された効果を示しているわけではない。
0. 読み始める前に:記号と「誰の効果か」
0.1 1行を1プロフィールと考える
まず、分析に使う表を思い浮かべておこう。ある日時に、新しい推薦を利用できる条件を満たしていたプロフィールを集める。そして、各プロフィールについて、それ以前の28日間の視聴履歴と、その後7日間の視聴の有無を1行にまとめる。
ここでは、新しい推薦方針に割り当てることを「介入」と呼ぶ。新方針に割り当てた人が介入群、従来方針のままの人が非介入群、または対照群である。以降のHulu例で「推薦あり・なし」と簡略に書く場合も、特に断りがなければ、この新方針への割り当てを指す。また、どちらの群に入るかをランダムに決めて比べる実験を、RCTと呼ぶ。
介入より前の視聴履歴は、もともとの視聴習慣を比べるために使う。一方、介入より後の視聴は、推薦によって変化したかを調べる結果として使う。この二つを区別するために、次の記号を用いる。
| 記号 | 意味 | Huluでの例 |
|---|---|---|
| 分析する個体 | 対象プロフィール | |
| 介入。1ならあり、0ならなし | 新しい推薦トレイを配信する方針に割り当てたか | |
| 介入前の共変量 | 過去28日の視聴日数、アニメ視聴割合、最終視聴からの日数 | |
| 観測した結果 | 割り当て後7日以内に対象シリーズを視聴したか | |
| 介入した場合の潜在結果 | 新トレイ方針だった場合の視聴の有無 | |
| 介入しなかった場合の潜在結果 | 従来方針だった場合の視聴の有無 | |
| 傾向スコア | 同じ介入前の特徴を持つ人に新方針が割り当てられる確率 |
表にある と は、同じ人に対する二つの「もしも」である。例えば、ある人が新方針に割り当てられて『名探偵コナン』を視聴したなら、 は分かる。しかし、その人を従来方針のままにしても視聴したのかは分からない。実際には起きなかった側の結果を、反実仮想という。
実際のデータに記録される は、二つのうち、割り当てられた側の結果だけである。この関係を式で書くと、次のようになる。
を代入すると、右辺は となる。反対に、 を代入すると だけが残る。したがって、この式は「観測されるのは、実際に受けた介入に対応する結果である」と表している。
同じ人から両方の結果を得られないため、個人の効果を直接引き算することはできない。そこで、別の人の結果を比較相手として利用し、集団としての平均効果を推定する。その比較相手の選び方や重み付けに、傾向スコアを使うのである。
なお、視聴を1、未視聴を0とすると、平均はそのまま視聴率になる。例えば、100人のうち13人が視聴した場合、平均は 、つまり13%である。視聴率が10%から13%になった場合、その差を 3パーセントポイント と表す。本ノートでは、視聴率の差に使う「ポイント」はこの意味である。
0.2 ATEとATTは異なる問いに答える
平均効果を求める前に、「誰について平均するのか」を決める必要がある。例えば、新方針を全対象者に広げたいときと、すでに新方針を割り当てた人への効果を知りたいときとでは、知りたい平均が異なる。
全対象者について平均した効果をATEという。例えば「今回の対象者全員を新方針にした場合と、全員を従来方針にした場合で、視聴率はどれだけ違うか」という問いに対応する。効果を知りたい集団全体を母集団、そのうち実際にデータを観測した人たちを標本という。観測した標本から、知りたい集団の平均を推定することになる。
は、括弧の中の量について平均を考える記号であり、期待値と呼ぶ。この式では、一人ひとりの効果 を対象者全体で平均している。対象者を「アニメ推薦を利用できるプロフィール」と定めたなら、ATEもその人たちの効果であり、Hulu全会員の効果とは限らない。
一方、実際に新方針を割り当てた人だけについて平均した効果をATTという。「今回、新方針を割り当てた人たちは、もし従来方針のままだったらどうだったか」という問いに対応する。
縦線の後ろにある は、「実際に介入された人に限る」という条件である。例えば、アニメ好きへ優先的に新方針を配信したなら、ATTを計算する集団にはアニメ好きが多く含まれる。
例えば、対象者の半分ずつがライト層とヘビー層で、効果がそれぞれ10ポイントと20ポイントなら、ATEは次の値となる。
一方、実際の介入者の構成がライト層1/3、ヘビー層2/3なら、ATTは次の値となる。
このように、全体にはライト層が半分いるが、介入者の中では3分の1しかいない。効果の大きいヘビー層の割合が高いため、ATTのほうが大きくなる。したがって、ATEの15ポイントとATTの約16.67ポイントは矛盾しない。どの人たちの効果を平均したかが違うのである。
1. 傾向スコアのしくみ(3.1)
1.1 なぜ共変量を1つの確率にまとめるのか
もともとの視聴習慣をそろえて比べる方法として、まず思い付くのは、介入前の特徴が同じ人を探すことである。例えば「過去28日の視聴日数が5日、アニメ視聴割合が40%、主なデバイスがテレビ」という条件が同じ人同士を比較する。ここで照合する介入前の特徴を、共変量という。
しかし、そろえたい特徴が増えるほど、すべての条件が一致する相手は見つかりにくくなる。視聴時間を秒単位で合わせ、年齢や会員期間も合わせようとすると、比較相手がほとんどいなくなることもある。
そこで、特徴を一つずつ完全に一致させる代わりに、それらの特徴を持つ人が介入される確率を使う。この確率が傾向スコアであり、次のように定義する。
右辺の は確率を表す。縦線の右側の は「介入前の特徴が である人に限る」という条件であり、左側の は「その人が介入される」という出来事である。したがって、式全体は「その特徴の人が介入される確率」と読める。ここでは、実際の割り当ての仕組みから決まる確率を真の傾向スコアと呼び、モデルが予測した値とは区別する。
「アニメ好きで視聴頻度が低い人」と「アニメへの関心は普通だが視聴頻度が高い人」が、どちらも60%の確率で推薦対象になることはあり得る。このとき、二人の特徴は異なる。それでも、このような人を大勢集めると、推薦する群と推薦しない群で、含まれる人のタイプの割合が同じになるという性質がある。これが「共変量の分布が釣り合う」という意味である。
ここでいう 共変量 は、アニメへの関心や過去の視聴頻度など、介入前の特徴のことである。また、 分布 は、「どのような特徴の人が、どれくらいの割合で含まれているか」を表す。したがって、この性質は「推薦する群にも、推薦しない群にも、同じような割合でアニメ好きや高頻度の視聴者が含まれる」と読み替えられる。ただし、これは 真の傾向スコアが同じ人たちの中で比較した場合 の話である。
具体例:どのタイプも60%の確率で推薦対象になる場合
傾向スコアが0.6の人だけを1,000人集めたところ、次の2タイプがいたとする。説明を単純にするため、ここで考える共変量の組み合わせは、この2タイプだけとする。
| タイプ | 介入前の特徴 | 集めた人数 | 全体に占める割合 |
|---|---|---|---|
| A | アニメ好きで、視聴頻度が低い | 300人 | 30% |
| B | アニメへの関心は普通だが、視聴頻度が高い | 700人 | 70% |
| 合計 | 1,000人 | 100% |
タイプAもBも、推薦対象になる確率は60%である。そのため、平均的には、どちらのタイプからも60%が推薦される群に入り、残り40%が推薦されない群に入る。人数を計算すると、次のようになる。
| タイプ | 推薦される群の人数(期待値) | 推薦されない群の人数(期待値) |
|---|---|---|
| A | 人 | 人 |
| B | 人 | 人 |
| 合計 | 600人 | 400人 |
推薦される群には、Aが180人、Bが420人いるので、その構成割合は次のようになる。
一方、推薦されない群には、Aが120人、Bが280人いるので、こちらの構成割合も同じになる。
つまり、両群の人数は600人と400人で異なっていても、 どちらの群も「Aが30%、Bが70%」という同じ構成になる 。これが、この例で「共変量の分布が釣り合っている」状態である。AとBの人数を半々にすることでも、推薦する人と推薦しない人を同じ人数にすることでもない。
なぜこのようになるのだろうか。タイプAだけが推薦群へ多く入りやすい、といった違いがないからである。AからもBからも同じ60%を取り出すので、取り出した群には元の30対70という割合が保たれる。残した40%の群にも、同じ割合が保たれる。
一人ずつの特徴が違っていても、集団の構成は同じにできる
この例では、推薦群から一人、非推薦群から一人を選ぶと、片方がAで、もう片方がBということはある。したがって、二人を並べたときに、視聴頻度やアニメへの関心が一致するとは限らない。それでも、群全体を見ると、AとBが同じ割合で含まれている。
その結果、群の平均視聴率を比較するときに、「推薦群にだけ、もともとアニメ好きな人が多かった」という構成の違いが入り込まなくなる。個々人をまったく同じ特徴にすることと、集団に含まれる人の構成をそろえることを区別すると理解しやすい。
以上の性質を記号で表したものが、次の式である。
この式は、「傾向スコアが同じ人たちに限れば、介入されたかどうかによって、共変量の分布は変わらない」と読む。上の例なら「推薦された人を見ても、推薦されなかった人を見ても、Aの割合は30%、Bの割合は70%である」という内容に対応する。より一般には、平均値だけでなく、共変量の組み合わせ全体の分布についての性質である。
ただし、表の人数は期待値であり、1回の割り当てで必ず180人や420人になるわけではない。実際には偶然のばらつきによって構成割合もずれる。また、実務では真の傾向スコアが分からず、モデルで推定した値を使うことが多い。推定値が同じでも真の割り当て確率が同じとは限らないので、調整後に各共変量の分布が近づいたかを確認する必要がある。
さらに、ここでそろうのは、傾向スコアの定義に使った共変量 の分布である。記録されていない特徴の違いまでなくなるとは限らない。そこから視聴率の差を因果効果として解釈するために必要な仮定は、次節で説明する。
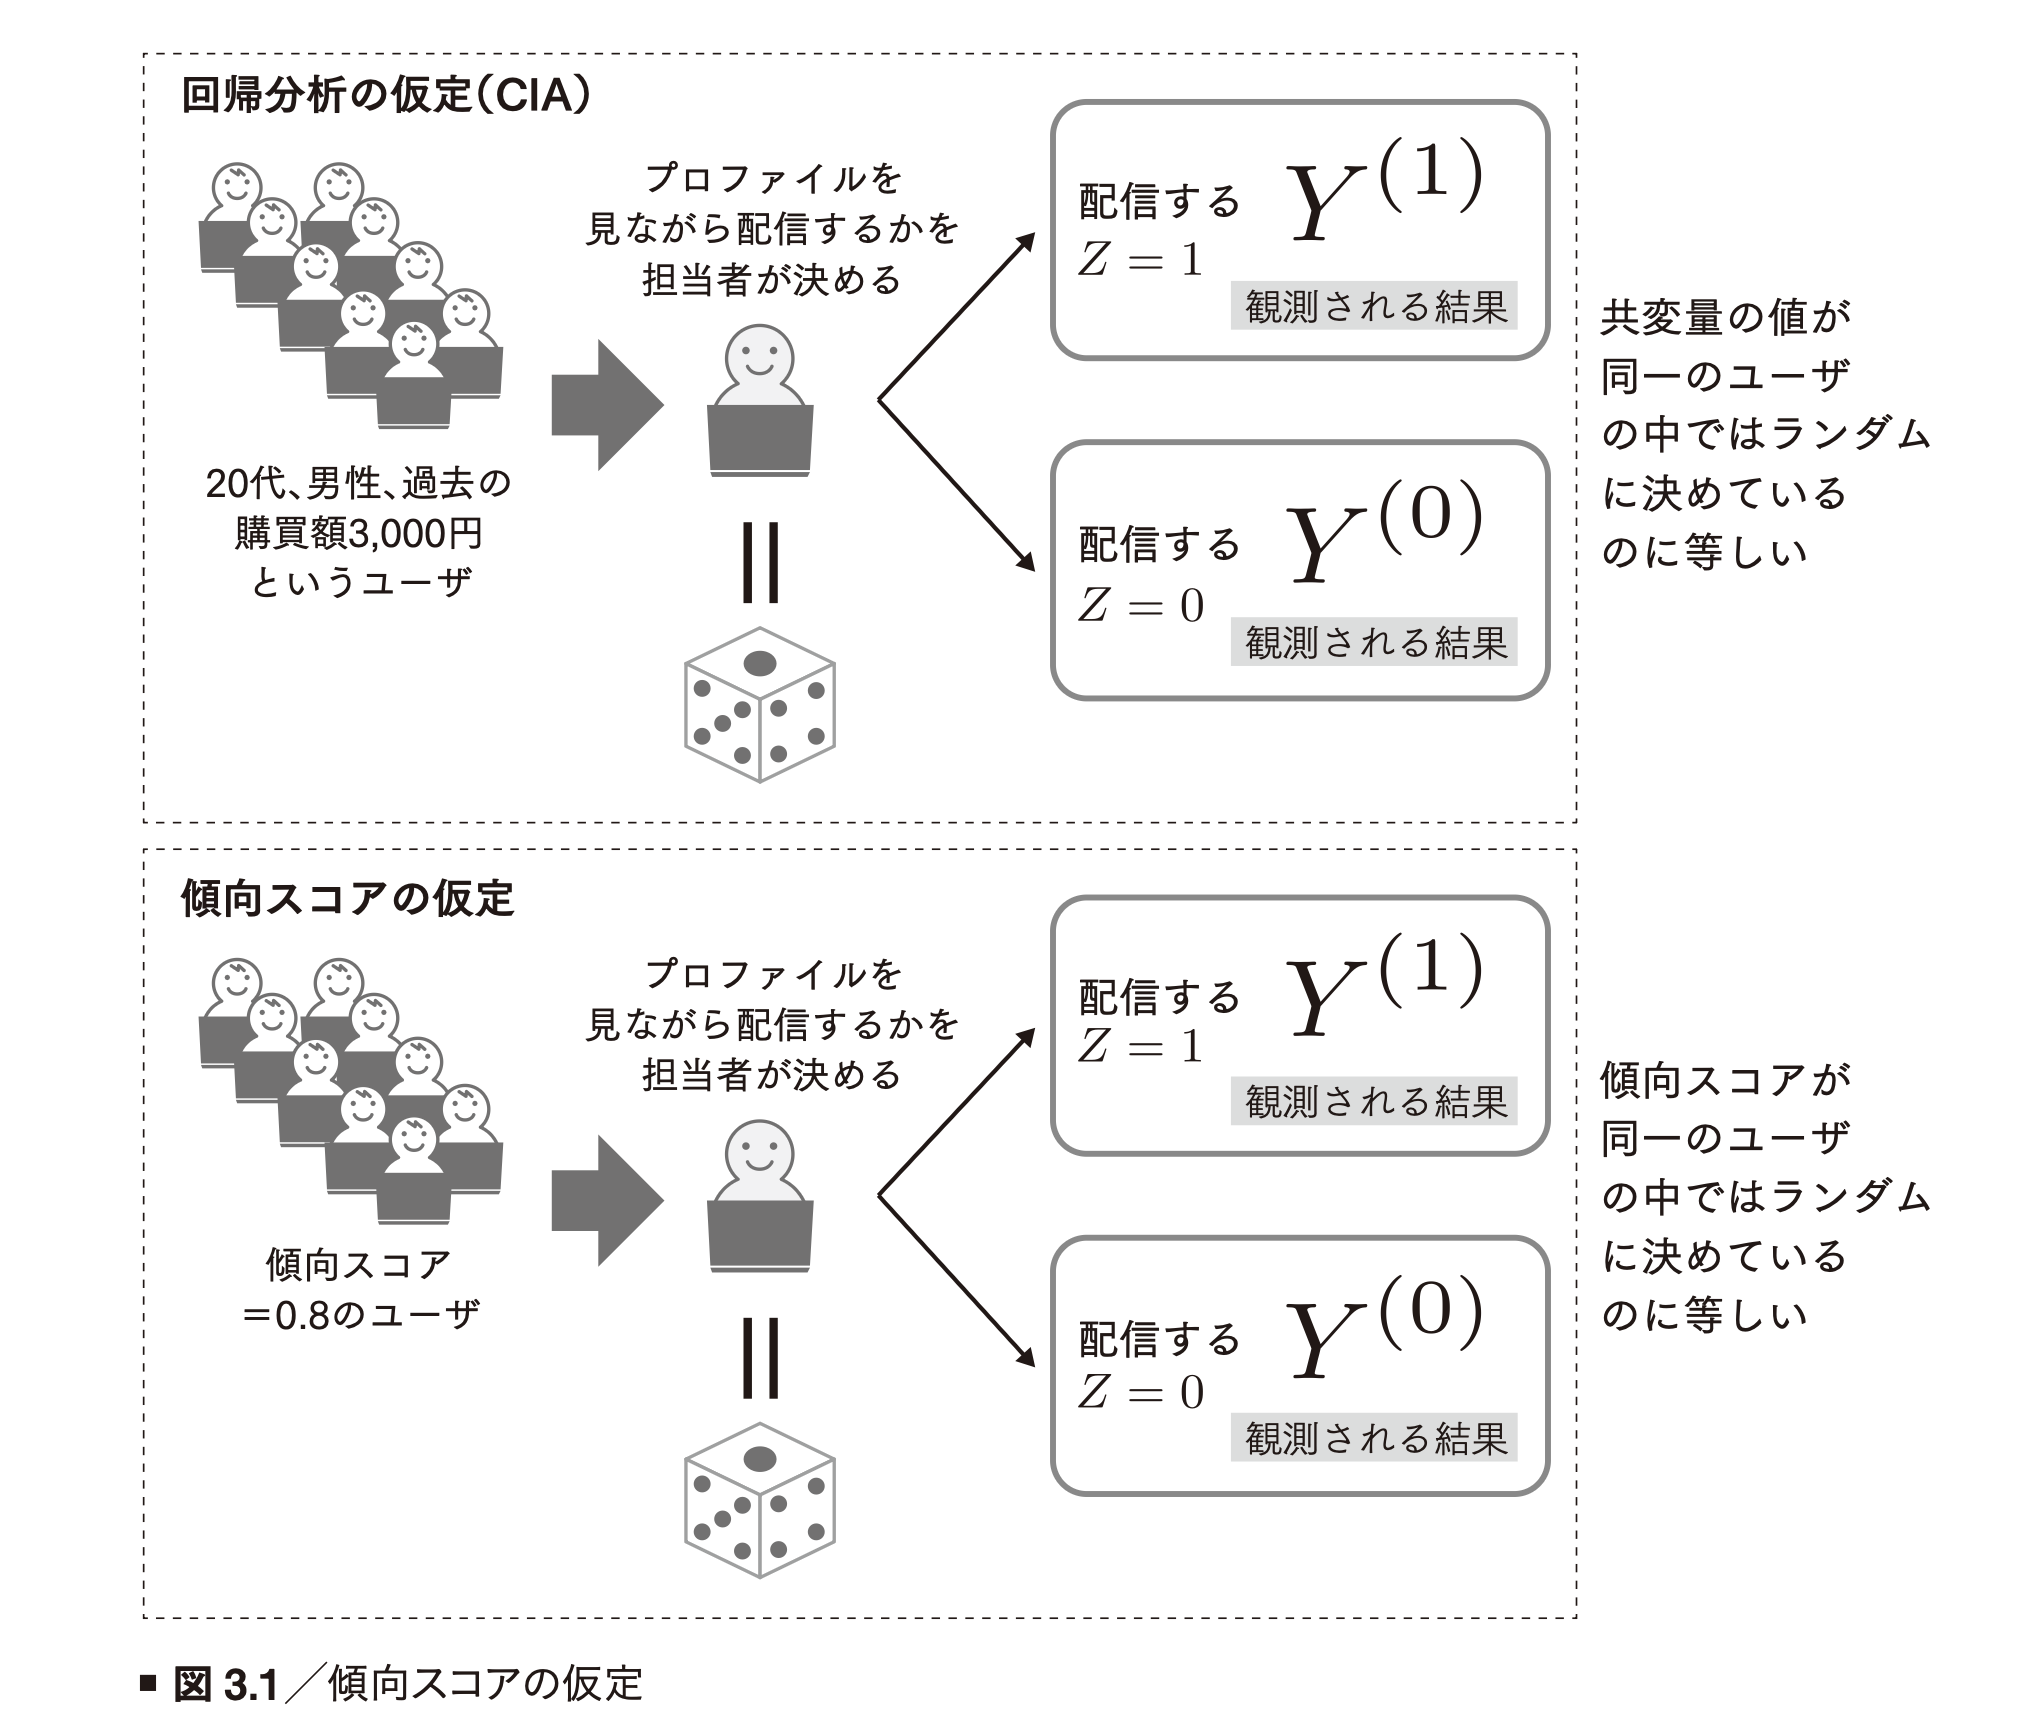
1.2 必要な仮定:スコアにまとめても未観測交絡は消えない
前節では、真の傾向スコアが同じ人たちの中では、観測した特徴の構成割合が両群で同じになることを説明した。次に考えたいのは、その状態で視聴率を比べれば、推薦の効果が分かるのか、という点である。
例えば、記録した過去の視聴履歴は同じでも、最近その作品に興味を持ったかどうかは違うかもしれない。そして、その興味が推薦対象の選ばれ方にも影響しているなら、観測した特徴をそろえた後にも、比較を歪める違いが残る。
したがって、視聴率の差を推薦の効果と解釈するには、「比較に必要な違いを、記録した情報で十分に捉えている」と考えられる必要がある。このほかにも、比較相手が存在することや、介入の内容が明確であることが必要になる。以下では、まず最も重要な「別の人を比較相手に使ってよいか」から説明する。
1.2.1 「もし推薦しなかったら」を誰で代わりに調べるのか
新しい推薦方針に割り当てた人の視聴率が30%、従来方針の人が20%だったとする。この差の10ポイントを、新方針の効果と言ってよいだろうか。
ここで本当に知りたいのは、「新方針を割り当てた人たちが、もし従来方針のままだったら、視聴率は何%だったか」である。その値が20%なら効果は10ポイントだが、もともと30%視聴する人たちだったなら、効果は0ポイントとなる。
ただし、新方針を割り当てた人たちについて、同じ期間に従来方針だった場合の結果は観測できない。そのため、従来方針だった別の人たちの結果を、比較相手として利用する。
そのためには、同じ介入前の特徴を持つ人同士で比べたときに、次のように考えられる必要がある。新方針の人たちを仮に従来方針へ戻した場合、その視聴しやすさは、実際に従来方針だった人たちと同じである、ということである。これが、条件付き交換可能性という仮定の中心的な意味である。
「条件付き」とは、例えば過去の視聴日数、ジャンルの好み、会員期間などをそろえた中で、という意味である。「交換可能」とは、反実仮想の平均を求める際に、もう一方の群を比較相手として使えるという意味である。個々人が同じ行動をする必要はなく、集団としての視聴しやすさがそろっていることが必要となる。
1.2.2 未観測交絡とは、記録から見えない「配信されやすさと視聴しやすさの共通原因」である
ここで、過去の視聴履歴がまったく同じ1,000人を考える。分析に使う特徴 は、その過去の視聴履歴だけとする。しかし実際には、次のような違いがあるとする。
| 分析データに記録されていない違い | 人数 | 推薦される確率 | 推薦しなくても視聴する確率 |
|---|---|---|---|
| 作品への関心が最近高まっている人 | 500人 | 80% | 60% |
| 作品への関心が最近高まっていない人 | 500人 | 20% | 10% |
例えば、配信システムは直前の作品検索を使って推薦対象を選んでいるが、分析用データにはその検索情報を入れていない状況である。関心が高まっている人は検索するので推薦されやすく、推薦がなくても自分で作品を探して視聴しやすい。
このように、 推薦されるかどうかと、推薦がなくても視聴するかどうかの両方に関係する要因 が、交絡の原因となる。それを分析で観測していない場合が「未観測交絡」である。単に結果に関係する未知の要因がある、というだけではなく、割り当てとの関係も問題になる。
では、この例で視聴率を比べるとどうなるだろうか。分かりやすくするため、推薦には誰に対しても効果がなく、推薦しても各タイプの視聴確率は60%と10%のままだとする。次の人数は、確率から計算した期待値である。
| タイプ | 推薦される群 | 推薦されない群 |
|---|---|---|
| 関心が高まっている人 | 人 | 人 |
| 関心が高まっていない人 | 人 | 人 |
| 合計 | 500人 | 500人 |
推薦群には、もともと視聴しやすい人が多く含まれる。そのため、推薦群の視聴率は次の値となる。
一方、非推薦群の視聴率は次の値となる。
観測上の差は 、つまり30ポイントになる。しかし、この例では推薦の効果を0と設定している。差のすべてが、もともとの関心の違いから生まれている。
ここで、分析で使っている過去の視聴履歴 は全員同じだったことを思い出そう。そのため、観測した共変量だけを見ると、両群に違いはない。それでも、記録していない関心の分布は大きく異なる。この例が示しているのは、観測した特徴がそろっても、観測していない違いによるバイアスは残り得るということである。
1.2.3 傾向スコアを正確に求めても、この問題は残る
先ほどの例では、分析者から見ると全員が同じ を持ち、その集団の半分が推薦される。そのため、観測した に基づく真の傾向スコアは、全員について次の値である。
全員のスコアが同じなので、スコアで比較相手を選び直しても、関心の高い人と低い人を区別できない。後で説明するIPWを使っても、両群の全員に同じ重み2を付けるだけなので、平均視聴率は変わらない。したがって、30ポイントの見かけの差が残る。
この例では、過去の視聴履歴から分かる割り当て確率0.5自体は正しい。しかし、その履歴だけでは最近の関心の違いが分からないため、適切な比較相手を作れない。「真の傾向スコア」であっても、何を に含めたかによって、表している確率が違うのである。分析に必要な情報が欠けている場合は、モデルの予測を正確にするだけでは解決しない。
仮に、表の関心のタイプを正確に測定して に追加できれば、この架空例では、関心が高い人同士、低い人同士で比較できる。各タイプ内では推薦あり・なしの視聴率が同じなので、差は0となる。ただし実務では、検索ログを追加しただけで関心を十分に測定できたかどうかまで、自動的に保証されるわけではない。
1.2.4 条件付き交換可能性の式を、日本語に分けて読む
ATEを扱うときの代表的な仮定は、次の式である。
| 式の部分 | 日本語での意味 |
|---|---|
| その人に新方針を割り当てた場合の結果 | |
| その人を従来方針のままにした場合の結果 | |
| 実際にどちらの方針を割り当てたか | |
| 介入前の特徴 が同じ人たちの中で考える | |
| 一方の情報を知っても、もう一方の分布が変わらない |
式全体は、「介入前の特徴が同じ人たちの中では、実際の割り当て先を知っても、新方針だった場合・従来方針だった場合の結果の分布は変わらない」という意味である。
平均に着目すると、従来方針だった場合について、次の関係が成り立つ。
左辺は「新方針の人たちを、もし従来方針にしていたらどうだったか」であり、右辺は「実際に従来方針だった人たちはどうだったか」である。この二つが同じだから、右辺の観測を左辺の代わりに使える。ATEのための上の仮定では、 についても同様に成り立つ。
ここでそろえているのは、 同じ方針にしたと仮定した場合の結果 である。実際の新方針群と従来方針群の観測視聴率が同じ、という意味ではない。推薦に効果があれば、観測した視聴率は違ってよい。また、全員の効果が同じであると仮定しているわけでもない。
この条件は、適切にランダム化された実験なら割り当ての仕組みによって支えられる。一方、観察データでは、両方の潜在結果を同じ人から観測できないので、共変量バランスの確認だけで成立を証明することはできない。配信の仕様と、分析に入れた情報が十分かどうかを考える必要がある。
1.2.5 重なり:同じ条件の比較相手が存在するか
もう1つ必要なのは、同じ介入前の条件の人に、新方針と従来方針の両方があり得ることである。
例えば、アニメ好きには必ず新方針、それ以外には必ず従来方針を割り当てていたら、アニメ好きの中に従来方針の人がいない。すると「アニメ好きの人が従来方針だった場合」の結果を、その条件の観測データから求められない。これが重なりの欠如である。
ここでは、アニメへの関心を正確に記録できていても問題は残る。未観測交絡は「比較に必要な違いを捉えられていない」問題であり、重なりの欠如は「違いを捉えても、比較相手がいない」問題だからである。
また、確率が0.999なら数学的には両方があり得るが、1,000人いても従来方針になるのは平均1人しかいない。比較相手が極端に少ないと推定が不安定になるため、0と1を避けるだけでなく、実際に十分な比較相手がいるかも確認する。
1.2.6 整合性と干渉:何を「新方針の効果」と呼ぶのか
比較以前の前提として、介入の内容も明確である必要がある。例えば を「特定バージョンの推薦方針に割り当てた」と定義したなら、観測された結果は、その方針に割り当てた場合の潜在結果に対応する。
これを整合性という。「方針への割り当て」を測っているのに、実際にトレイを見た人だけを介入者と呼び直すと、介入の定義が変わってしまう。割り当て効果には、画面を開かずトレイを見なかった人も含まれる。
さらに、ここでは他の人への割り当てが本人の結果を変えないとする。例えば同じ家族の別プロフィールに出た推薦をきっかけに本人も作品を見るなら、本人の割り当てだけでは結果を説明できない。この場合は、アカウント単位で介入を定義するなど、干渉を踏まえた設計を考える必要がある。
1.2.7 では、傾向スコアにまとめることで何ができるのか
必要な関係を順に並べると、次のようになる。
- まず、介入と結果の意味を明確にする。
- 次に、 をそろえれば、両群を適切な比較相手として使えると仮定する。これが条件付き交換可能性である。
- その条件の範囲で、両方の介入があり得ることを確認する。これが重なりである。
- そのうえで、比較の調整に、特徴の一覧 の代わりに真の傾向スコア を利用できる。
このとき、次の関係が成立する。
この式は、「同じ傾向スコアの人たちの中でも、介入群と対照群を適切な比較相手として使える」と表している。そのためには、もともと をそろえた段階で、比較に必要な違いを十分に取り除けていなければならない。傾向スコアの定理は、その前提があるときに、複数の特徴を1つの確率にまとめて調整できることを示している。Rosenbaum・Rubinの原論文
したがって、教科書の「条件が緩和される」という説明は、照合する情報の次元を減らせるという意味で読むとよい。比較に必要な情報を観測しなくてもよくなる、という意味ではない。先ほどの未観測の関心の例のように、もとの で適切な比較ができなければ、それをスコアにまとめても問題は残る。
なお、実際の介入者に対するATTだけを知りたい場合、介入者の はすでに観測されている。中心となるのは、その人たちの見えない を推定することである。そのため、介入者のいる特徴の範囲に適切な対照者がいることと、そこでの の交換可能性が特に重要となる。対象を絞れることはあっても、比較相手に関する前提が不要になるわけではない。
過去の視聴頻度・ジャンル・デバイス。割り当てと結果の共通原因を測る。
介入されやすさを推定し、マッチングまたは重み付けする。
未測定の共通原因がないか、比較相手が存在するかは別途考える。
1.3 ロジスティック回帰で推定する(3.1.2)
ここまでは、傾向スコアが分かっているものとして説明してきた。しかし、実際の観察データでは「この人が何%の確率で推薦対象になったか」は記録されていないことが多い。そこで、過去の割り当て結果を使って、その確率を推定する。
入力に使うのは介入前の特徴 、予測したいのは介入の有無 である。視聴の有無 を予測するモデルとは、目的が異なる。例えば、視聴日数やアニメ視聴歴を入力して、「新方針に割り当てられた人かどうか」を学習する。
このように、結果が0か1のときによく使われるのがロジスティック回帰である。まず、特徴に係数を掛けて足し合わせる。次に、その値をシグモイド関数 に通し、0から1の間の確率に変換する。
上の は、特徴ごとに「値×係数」を計算して足し合わせる部分である。また、 は切片であり、特徴による加算がないときの基準を調整する。
最初の式のBernoulliは、1または0を取る変数の分布を表す。例えば なら、 は確率0.7で1、確率0.3で0になる。教科書の式を読む際も、シグモイドの出力は介入の0/1そのものではなく、介入が1になる確率だと区別するとよい。
例えば、 を過去28日の視聴日数、 をアニメを視聴したことがあるかの0/1とし、次のモデルを考える。
10日視聴し、アニメ視聴歴がある人では、括弧の中は となる。したがって、 であり、推薦対象になる確率を50%と推定する。
一方、アニメ視聴歴は同じで、視聴日数が20日の人では、括弧の中が1になる。そのため、 であり、約73.1%と推定する。なお、記号の上のハット は、データから推定した値であることを示す。
ここで0.731は「アニメを見る確率」ではない。「新推薦に割り当てられる確率」である。Two-Towerの内積やランキングスコアとも意味が違う。
では、係数はどのように決めるのだろうか。実際に介入された人には高い確率を、介入されなかった人には低い確率を出すように、学習データを使って調整する。その際に使う損失が、次の負の対数尤度である。二値分類で使う交差エントロピーと同じ形なので、MLで見慣れた式かもしれない。
例えば、実際に介入された人では なので、その人の損失は となる。確率を0.8と予測すれば約0.223だが、0.2と予測すれば約1.609となる。このように、実際の割り当てに低い確率しか与えない予測ほど、損失が大きくなる。全員分の平均損失を小さくするように係数を求めるのが、ここでの最尤推定である。
付属Pythonでは、この計算をSciPyで行う。収入と年齢のように値の大きさが違う特徴を扱いやすくするため、数値列の平均とばらつきをそろえてから計算する。係数を小さくするための罰則は加えておらず、通常のRの
glm(..., family=binomial)
と同じモデルを推定する設定である。
このモデルの係数は、「推薦によって視聴が何ポイント増えるか」を表してはいない。効果の計算に使うのは、モデルが出した割り当て確率である。ただし、学習が正常に終わったかは確認する必要がある。例えば、特徴から介入群を完全に見分けられる場合は、係数が極端な値に向かい、安定した確率を得られないことがある。
2. 傾向スコアマッチング(3.2.1)
2.1 推薦されやすさが近い人を、比較相手として選ぶ
傾向スコアを求めたら、まずはその値を使って比較相手を選んでみよう。例えば、新方針に割り当てられた人のスコアが0.60なら、従来方針だった人の中から、0.60に近いスコアの人を探す。そして、この二人を1組にする。この操作をマッチングという。
すべての組を作った後で、各組について結果の差を計算し、最後にその差を平均する。例えば、3組の結果の差が1、0、−1なら、平均は である。1対1のマッチングを式で表すと、次のようになる。
ここで、 は介入者、 はその人の比較相手である。また、 は比較相手が見つかった介入者の集合、 はその人数である。したがって、式の意味は「各組の差を合計し、組数で割る」となる。
この方法では、介入者を出発点として比較相手を探す。そのため、すべての介入者に適切な相手が見つかれば、実際の介入者についての平均効果、つまりATTを推定することになる。ただし、比較相手が見つからず介入者の一部を除いた場合は、残った介入者についての平均になる。元の介入者全員のATTとは、対象が変わることに注意する。
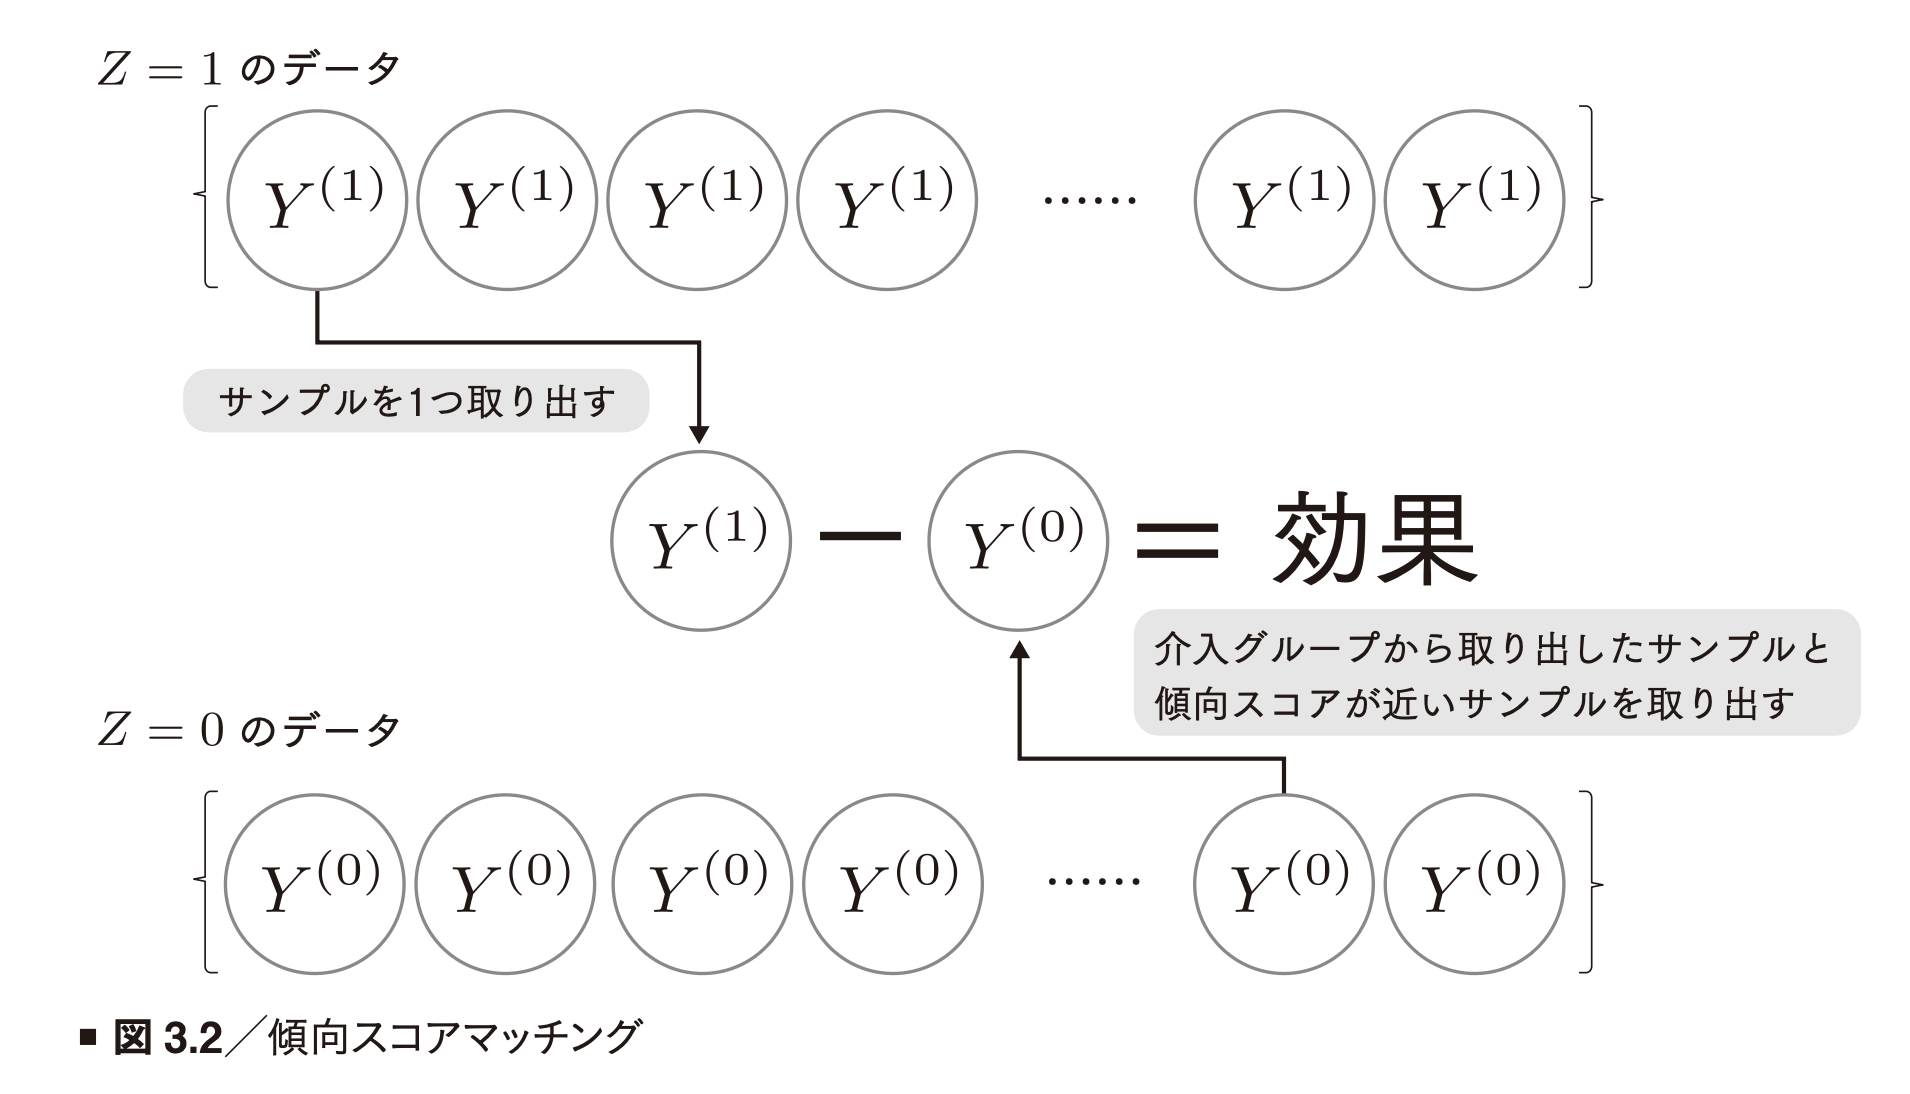
同じ考え方を、確率や期待値の記号で書くこともできる。まず、スコアが同じ人たちの中で介入群と対照群の平均を引き算する。次に、実際の介入者に多いスコアほど多く反映するように、その差を平均する。1.2節の仮定が成り立つ場合、この計算は次のように書ける。
内側の二つの は、同じスコアの人たちについて、介入あり・なしの結果の平均を求めている。外側の は、その差を実際の介入者の構成に合わせて平均している。例えば、介入者の3分の2がヘビー層なら、ヘビー層の効果を3分の2の割合で反映する。0.2節で計算したATTと同じ考え方である。
2.2 教科書の売上例を最後まで計算する
仕組みを確認するために、まず教科書の売上例を計算してみよう。顧客がAとBの2タイプに分かれ、それぞれ300人いるとする。タイプAはメールがなければ1,000円、あれば1,500円購入する。一方、タイプBはメールがなければ1,500円、あれば2,000円購入する。
したがって、もともとの購入額はBのほうが高いが、メールによる増加額は、どちらも500円である。この状況で、Aの100人とBの200人にメールを配信したとする。
| タイプ | 全人数 | 配信人数 | 非配信人数 | 非配信時の売上 | 配信時の売上 | 効果 |
|---|---|---|---|---|---|---|
| A | 300 | 100 | 200 | 1,000円 | 1,500円 | 500円 |
| B | 300 | 200 | 100 | 1,500円 | 2,000円 | 500円 |
観測された配信群の平均は 円、非配信群は 円である。
差は約666.67円であり、真の500円より約166.67円大きい。配信群に、もともと売上の高いBが多いためである。
そこで、AはA同士、BはB同士で比較する。同じ対照者を1回しか使わないとすると、Aでは配信者100人と非配信者100人を組にできる。一方、Bでは非配信者が100人しかいないため、作れるのは100組までである。
Aの組の売上差は 円、Bの組の差も 円となる。したがって、200組の差を平均しても500円となり、この例で設定した効果を得られる。
ただし、この比較にはBの配信者200人のうち100人しか含まれていない。今回は全員の効果を500円としているため、誰を除いても平均効果は変わらない。しかし、人によって効果が違う場合は、除かれた人の特徴によって平均も変わる。比較に残った人を確認する必要があるのは、このためである。
2.3 視聴の有無を使う場合も、集団の平均で考える
Huluの架空例として、Aをライト層、Bをヘビー層とし、先ほどと同じ人数配置を使う。
| タイプ | 介入人数 | うち視聴 | 非介入人数 | うち視聴 | 群内の視聴率差 |
|---|---|---|---|---|---|
| A | 100 | 20 | 200 | 20 | |
| B | 200 | 120 | 100 | 40 |
そのまま平均すると、介入群の視聴率は 、非介入群は であり、差は約26.67ポイントとなる。しかし、各タイプ内での差はAが10ポイント、Bが20ポイントである。全体の構成はAとBが半々なので、タイプ別の差を半々に平均すると15ポイントとなる。一方、介入者の構成はAが3分の1、Bが3分の2なので、その構成に合わせた平均は約16.67ポイントとなる。
ここで、一つのペアだけを見ると、視聴の差は1、0、−1のいずれかになる。例えば、介入者が視聴し、対照者が視聴しなければ差は1である。しかし、比べているのは別々の人なので、その差をそのまま介入者本人の効果とは呼べない。適切な比較相手を選び、多数のペアの差を平均することで、集団の効果を推定するのである。
なお、表は各タイプの合計人数を示しているので、そこから一部を選んだときの視聴率までは決まらない。どの人が比較に残るかによって、実際のマッチングの結果は変わる。また、視聴したかどうかを見て比較相手を選ぶと、都合のよい差を作れてしまう。そのため、相手は介入前の情報で選ぶ必要がある。後述のIPWでは、表の全員を重み付けして、15ポイントと約16.67ポイントを計算する。
2.4 マッチングの設定も分析の一部である
比較相手を選ぶときには、いくつか決めておくことがある。例えば、対照者を繰り返し使ってよいか、どれくらいスコアが離れた相手まで許すかによって、比較に残る人が変わる。主な設定を次にまとめる。
| 設定 | 意味 | 注意点 |
|---|---|---|
| 復元なし | 対照者を1回だけ使う | 相手が不足すると介入者が落ちたり、遠い相手と組んだりする |
| 復元あり | 対照者を繰り返し使える | 同じ対照者の再利用を標準誤差に反映する必要がある |
| caliper | 許す距離の上限 | 遠い比較を避けられるが、マッチしない介入者が増える |
| 距離の尺度 | 生の確率差、logit差など | 同じ数値のcaliperでも意味が違う |
| 順番・同点処理 | どの介入者から、同点のどちらを選ぶか | 復元なしでは最終結果が変わる |
以降、傾向スコアをPS、傾向スコアマッチングをPSMと略記することがある。付属コードの
match()
は、例えば0.60と0.58なら距離を0.02とするように、確率の差をそのまま使う。スコアの高い介入者から順に相手を探し、同じ距離の相手が複数いれば入力行番号で選ぶ。
このコードは、マッチングの仕組みを追えるようにした簡易実装である。RのMatchItやMatchingが持つ全機能を再現しているわけではない。特に、同じ距離の相手を複数使う方法と、一人だけ使う方法とでは、計算結果が変わることがある。
これらの設定は、推定された効果が大きくなるように選ぶのではなく、適切な比較相手を作るために決める。例えば、caliperを変えるときは、推定値の大小だけを見るのではなく、両群の特徴が近づいたか、介入者を何人除いたかを確認する。結果を見ながら設定を変え続けると、マッチングでも分析者に都合のよい結論を選べてしまうからである。
3. 逆確率重み付き推定:IPW(3.2.2)
3.1 なぜ「確率の逆数」なのか
マッチングでは、比較する人を選び直した。次に説明するIPWでは、人を選び直す代わりに、平均を計算するときの数え方を変える。例えば重み5を付けた人は、結果の合計にも人数の合計にも、5人分として加える。
なぜそのような数え方をするのだろうか。同じ特徴を持つ人が100人いて、新方針に割り当てられる確率が20%だとする。この場合、平均的には、新方針だった場合の結果を観測できるのは20人だけである。残る80人については、従来方針だった場合の結果が観測される。
そこで、新方針の20人を一人当たり 人分として数えると、元の100人に相当する量になる。この5は、割り当て確率の逆数 でもある。同じように、従来方針の80人を一人当たり 人分として数えれば、こちらも100人に相当する。1.25は、従来方針になる確率の逆数 である。
このように、ある側で観測される割合が小さいタイプほど、一人に大きな重みを付ける。すると、介入群に少ないタイプも集計に十分反映でき、元の対象者の構成に近づけられる。
ただし、20人を5倍に数えても、新たな80人の結果が分かるわけではない。あくまで、観測できた20人を使って100人の結果を推定している。そのため、少人数に大きな重みを付けた推定は、偶然のばらつきの影響を受けやすい。この点は後の4.3節で扱う。
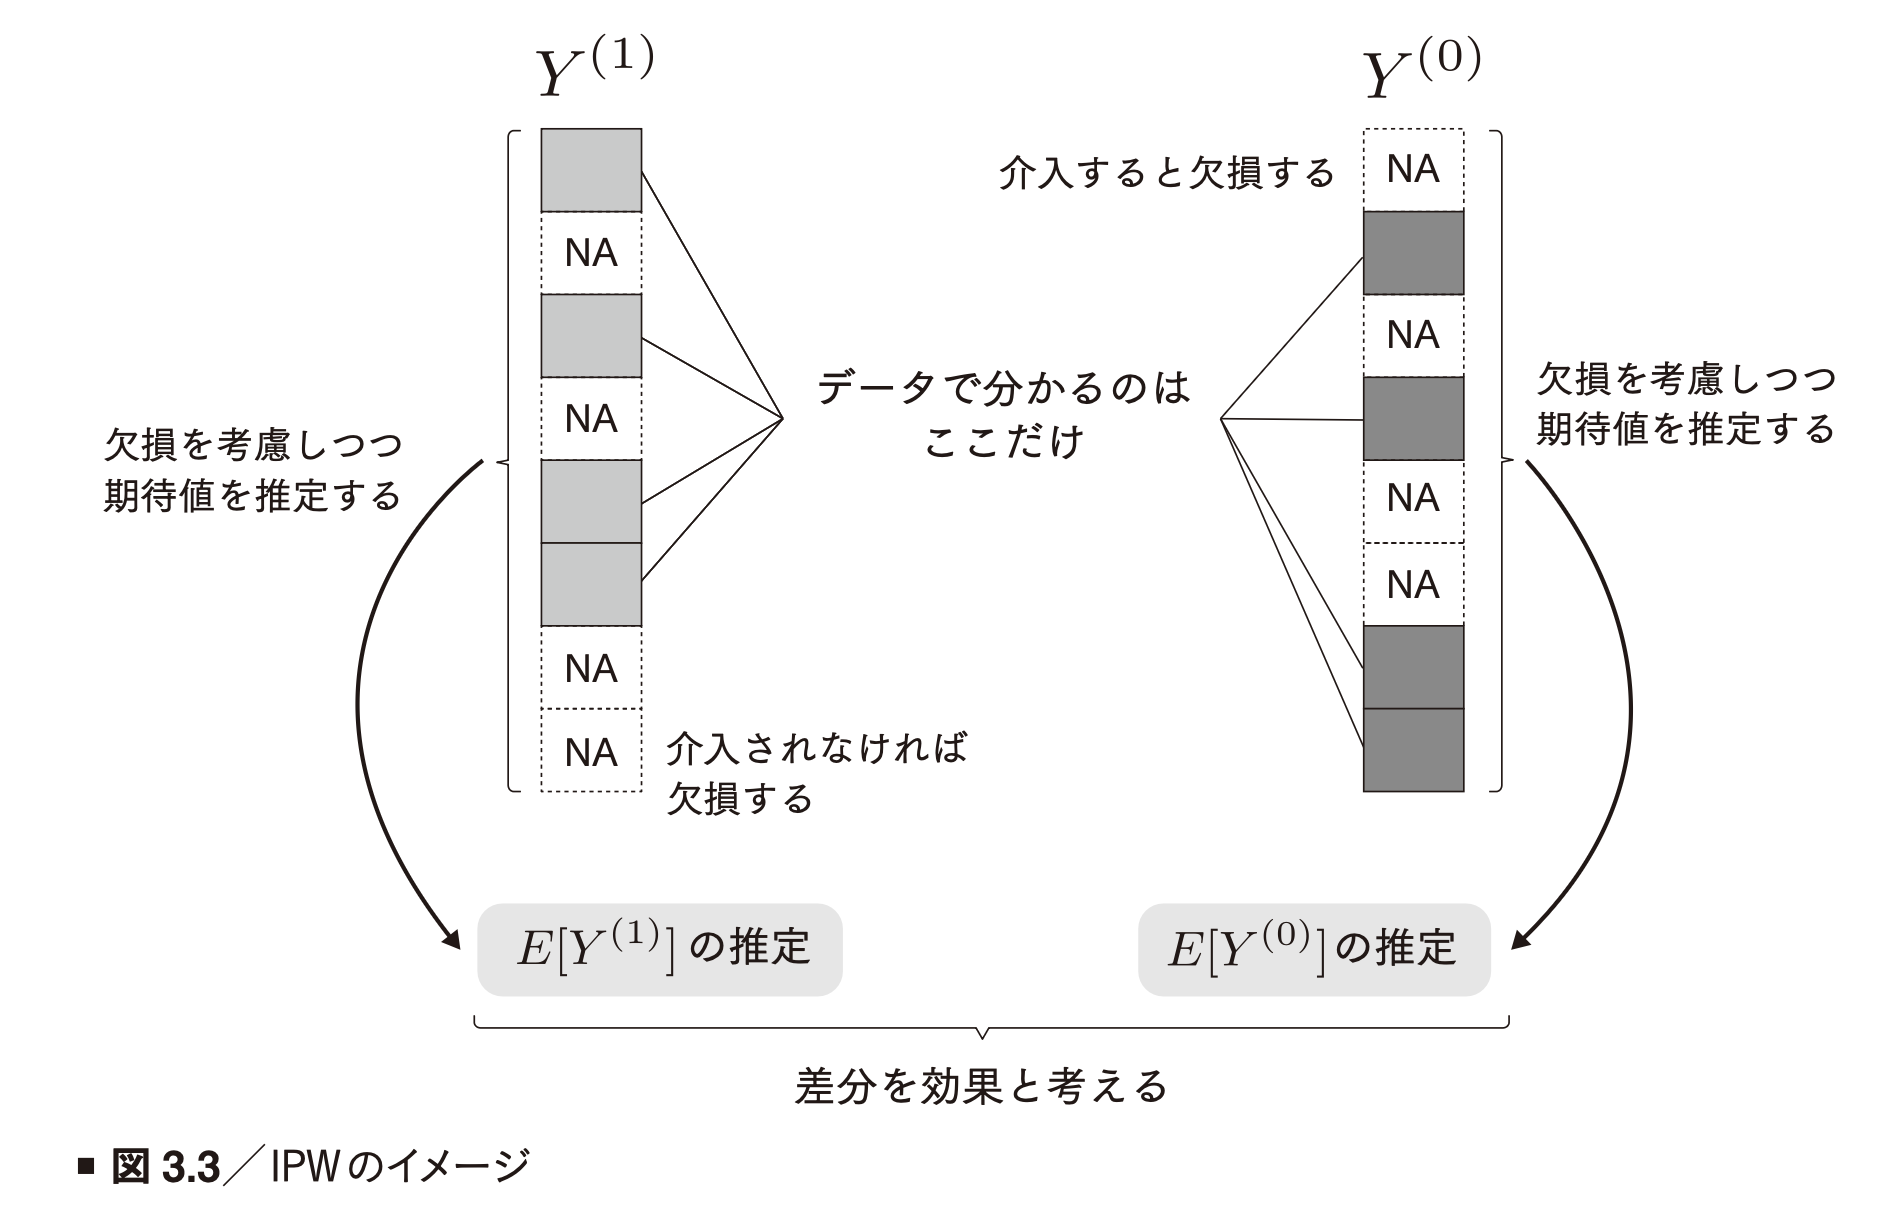
式でも、同じ考え方を確認しておこう。まず が同じ人たちに限り、介入者の結果に の重みを付ける。 の人は となるため、この計算に結果を加えない。すると、次の関係が得られる。
中央の式では、「介入者が現れる確率」 と、「その介入者の結果の平均」 に分けている。前者は と同じなので、分母と打ち消し合う。
さらに、1.2節の仮定が成り立てば、同じ特徴の介入者の平均を、その特徴を持つ人全体が介入された場合の平均として使える。これが最後の等号の意味である。最後に、特徴の異なるタイプも元の集団の割合で平均すれば、全体が介入された場合の平均 を求められる。非介入側では同じ手順で を使う。
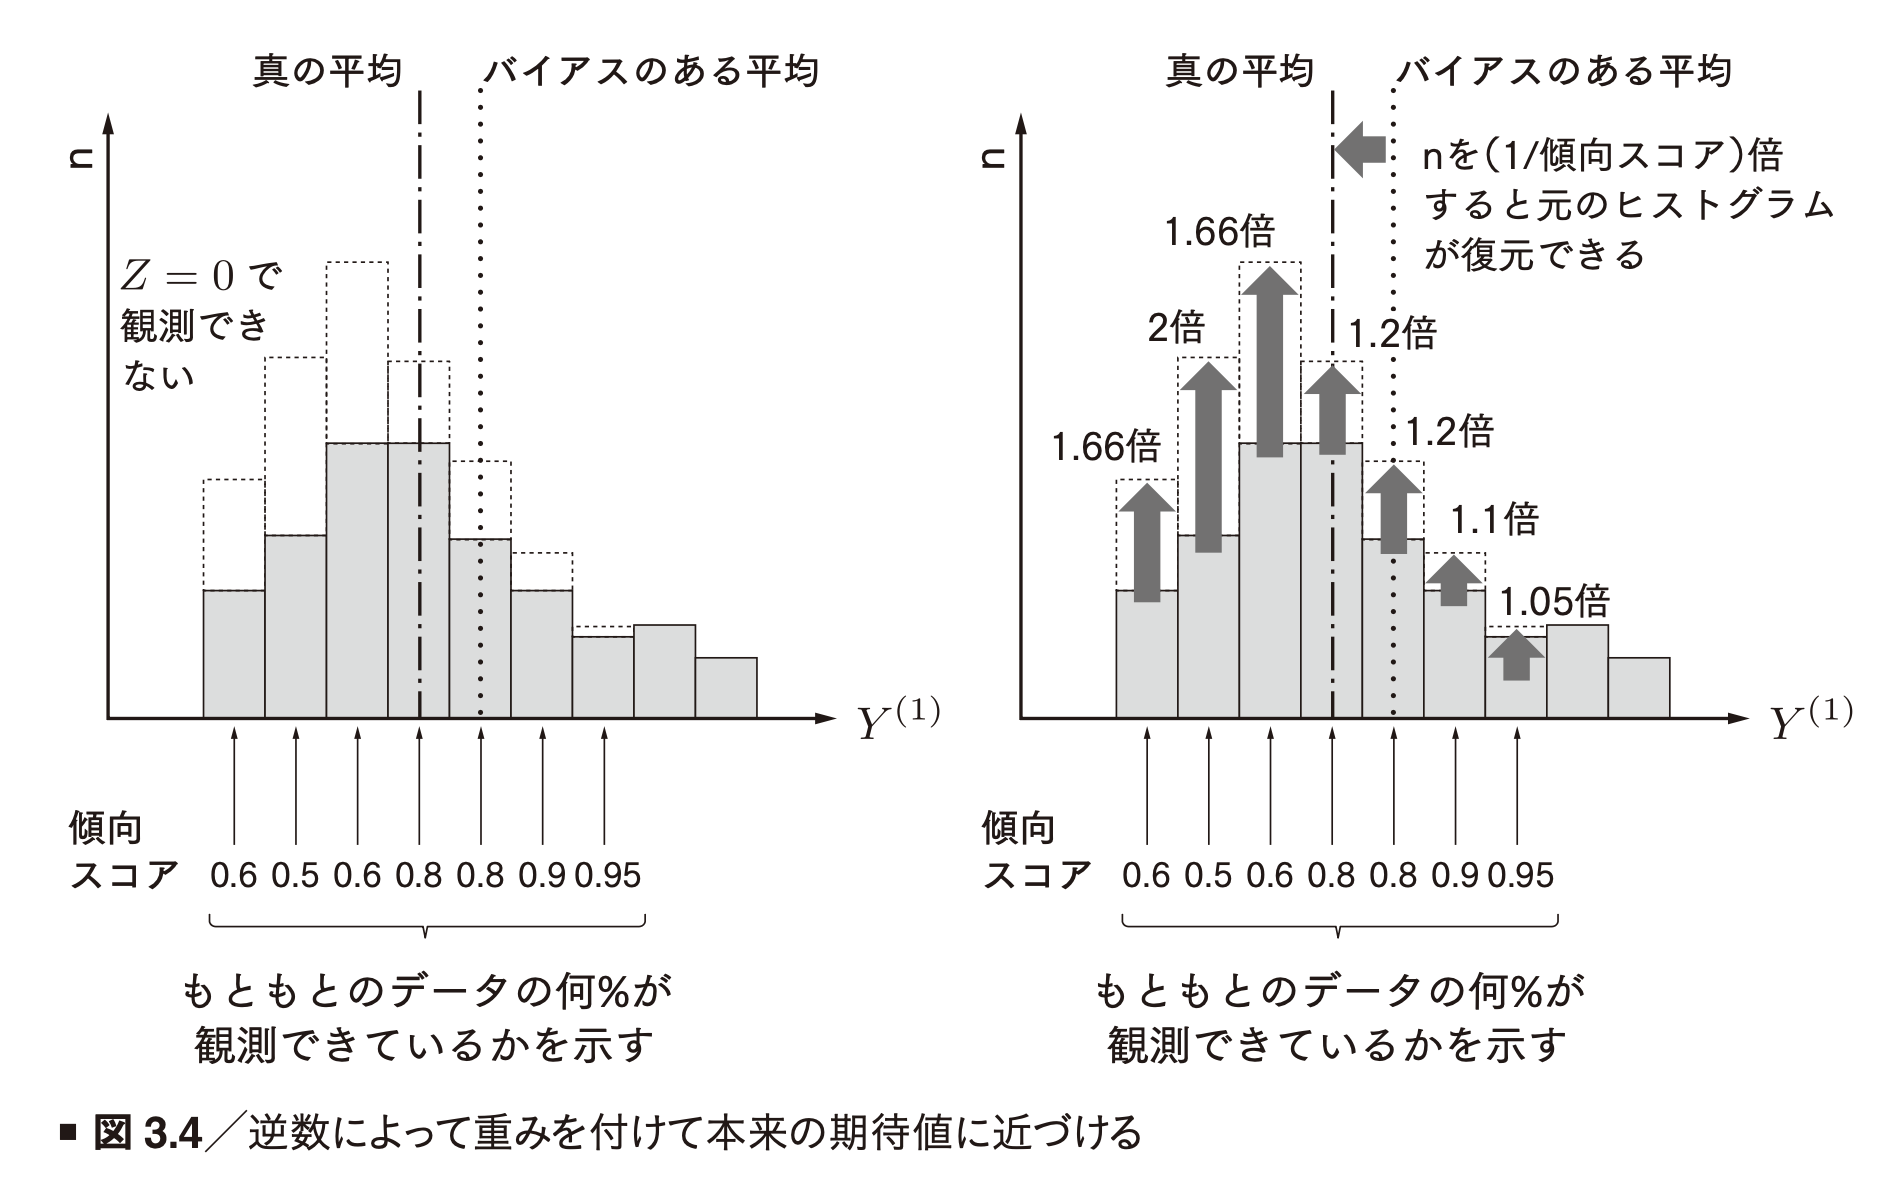
教科書の図の未観測部分は説明のための反実仮想であり、実データから直接描けるヒストグラムではない。
3.2 重み付きの平均を求め、最後に引き算する
通常の視聴率は「視聴した人数÷全人数」である。IPWでは、この両方の人数を重み付きで数える。介入側は 、非介入側は を使い、それぞれの視聴率を求める。
ここで、 は人 の推定傾向スコアである。また、 は対象者全員が介入された場合の平均結果、 は全員が介入されなかった場合の平均結果を推定した値である。
例えば の分子では、介入者の結果 に重みを掛けて合計している。視聴の有無なら、これは重み付きで数えた視聴人数である。分母では、視聴したかどうかに関係なく、介入者全員の重みを合計する。つまり、全員を介入させた場合の視聴率を、重み付きの「視聴人数÷全人数」で推定している。
非介入側も同様に平均を計算し、最後に二つを引き算する。これが教科書と付属コードで使うIPWである。各側が重み付き平均なので、視聴のような0/1の結果なら、 と はともに0〜1に収まる。
補足:IPWには、分母の異なる式もある
ここまでのように各群の重み合計で割る方法を、Hájek型という。まずは名前よりも、「重み付きで平均する式」だと理解すればよい。
これに対して、各群の重み合計の代わりに、元の対象者数 で割る方法もある。こちらはHorvitz–Thompson型、略してHT型と呼ぶ。
例えば、元の対象者数が1,000人でも、介入側の重み合計が今回のデータでは980になることがある。この場合、Hájek型は980で割り、HT型は1,000で割る。そのため、同じ重みを使っても計算結果が少し違うことがある。
真の割り当て確率を使ったHT型には、同じ仕組みでデータを取り直して計算を繰り返すと、その推定値の平均が真の値に一致する性質がある。これを不偏性という。一方、Hájek型は分母もデータによって変わるため、通常は厳密な不偏性を持たない。ただし、必要な仮定が成り立てば、データが十分に増えるにつれて真の値に近づく。この性質を一致性という。PS自体を推定する場合には、その推定が適切かどうかも必要になる。
3.3 売上例の重みを確認する
2.2節の売上例に戻ろう。タイプAは300人中100人が配信されるので、傾向スコアは である。一方、タイプBは300人中200人が配信されるので、 である。それぞれの逆数を使うと、次の重みになる。
| タイプ | 介入側の重み | 非介入側の重み | 重み付け後の各群の代表人数 | |
|---|---|---|---|---|
| A | 3 | 介入 、非介入 | ||
| B | 3 | 介入 、非介入 |
重みを付けた後は、配信群でも非配信群でも、AとBがそれぞれ300人分として集計される。つまり、両群とも、元の対象者の「Aが半分、Bが半分」という構成に戻る。この人数を使って売上を平均すると、次のようになる。
差は500円である。提供された教科書本文の非介入側の展開式には人数の対応が入れ替わった箇所があるため、ここでは表に従ってAの非介入者200人、Bの非介入者100人を使った。
3.4 Hulu例の視聴率を計算する
同じ重みを、2.3節のHulu例にも適用してみよう。介入側で視聴したのはAが20人、Bが120人だった。これらを重み付きで数えると、 人分となる。
一方、非介入側で視聴したのはAが20人、Bが40人だった。こちらは 人分となる。各群の全人数は、先ほどと同じく重み付きで600人分なので、視聴率は次のようになる。
両群を同じタイプ構成にそろえた結果、差は15ポイントとなった。最初の単純差は約26.67ポイントだったので、そのうち約11.67ポイントは、介入群にヘビー層が多かったことで生じた差と解釈できる。ただし、この例では、タイプ内の比較に1.2節の仮定が成り立つものとしている。
3.5 IPWでもATTを推定できる
ここまでは、両群を元の対象者全体の構成に合わせた。しかし、知りたいのが実際の介入者への効果、つまりATTなら、合わせる先を変える必要がある。
介入者については、すでにその人たちの結果が観測されているので、元のまま平均すればよい。一方、対照者は、そのままでは介入者と特徴の構成が異なる。そこで、対照者だけを介入者の構成に合わせて重み付けする。
そのための重みが である。同じ特徴の人のうち、介入者になる割合は 、対照者になる割合は なので、この比を掛けると対照者の人数を介入者に対応する人数へ換算できる。したがって、介入者の重みを1、対照者の重みを として、次の平均差を計算する。
Hulu例では、非介入Aの重みが 、Bの重みが となる。すると、非介入Aの200人は100人分、非介入Bの100人は200人分として数えられる。これは実際の介入者の構成と同じである。
この重みを視聴人数にも掛けると、非介入時の推定視聴率は となる。一方、介入者の実際の視聴率は である。したがって、ATTは 、約16.67ポイントと求められる。
このように、IPWでも、重みを変えればATEとATTの両方を扱える。「どの手法を使うか」に加えて、「誰の構成に合わせて平均するか」を確認することが大切である。
4. 良い傾向スコアと推定結果の診断(3.2.3〜3.2.5)
ここまでで、PSを使えば計算として効果の推定値を出せることが分かった。しかし、計算できたことと、信頼できる比較ができたことは別である。この節では、調整後の両群がどの程度似ているか、少数の人が結果を左右していないかを確認する方法を説明する。
4.1 AUCが高いだけでは目的を達成していない
MLでモデルを作ると、まず予測精度を評価したくなる。例えばAUCは、介入された人に、介入されなかった人より高いスコアを付けられるかを見る指標である。しかし、ここでの目的は、介入者をうまく見分けることだけではない。PSを使った後に、両群の特徴が比較しやすい状態へ近づく必要がある。
また、IPWでは予測確率の逆数をそのまま重みに使う。そのため、順位だけでなく、確率の値も重要になる。
例えば、本来の割り当て確率が0.2の人に、モデルが0.02と予測したとする。その人が介入者なら、使うべき重みは5なのに、50として数えてしまう。予測値の順位が正しくても、この違いによって推定結果は変わる。
一方、AUCが非常に高い場合には、両群の特徴が大きく異なるために、簡単に見分けられている可能性もある。したがって、AUCを確認したうえで、次に説明する特徴のバランスと、比較相手の有無も調べる必要がある。
4.2 SMD:両群の平均がどれくらい離れているかを見る
両群が似ているかを調べるには、まず介入前の特徴の平均を比べると分かりやすい。例えば、過去28日の視聴日数が介入群では平均12日、対照群では8日なら、4日の差がある。
ただし、視聴日数、会員期間、視聴時間では単位も値の大きさも違う。そのままの平均差では比べにくいので、人ごとのばらつきを基準にして差の大きさを表す。これが標準化平均差、SMDである。本ノートでは次の式を使う。
は、視聴日数や会員期間など、どの特徴を比べているかを表す。分子の は、その特徴の両群の平均差である。一方、分母の は、調整前の各群での標準偏差であり、人ごとの値がどれくらいばらついているかを表す。
つまり、SMDは「両群の平均の隔たりが、人ごとのばらつきに比べてどれくらい大きいか」を示す。調整後も同じ物差しで比較したいので、分母は調整前の値に固定し、分子だけを調整後の平均差に置き換える。
例えば、過去視聴日数の平均が12日対8日、両群の標準偏差が5日なら、SMDは である。重み付け後に10.2日対10.0日なら、SMDは まで下がる。
この例では、SMDが0.8から0.04に下がったので、視聴日数の平均はかなり近づいたと分かる。符号を気にせず差の大きさだけを見たい場合は、SMDの絶対値を使う。特徴ごとに、調整前と調整後の絶対SMDを点で並べたグラフがLove plotである。
教科書の「標準誤差で割る」という箇所は、標準偏差と区別して読む必要がある。標準偏差は人ごとの値のばらつきである。一方、標準誤差は、データを取り直したときに推定した平均などがどれくらい変わるかを表す。SMDで基準にするのは前者である。また、ASAMは通常、複数の特徴の絶対SMDをさらに平均した指標を指す。
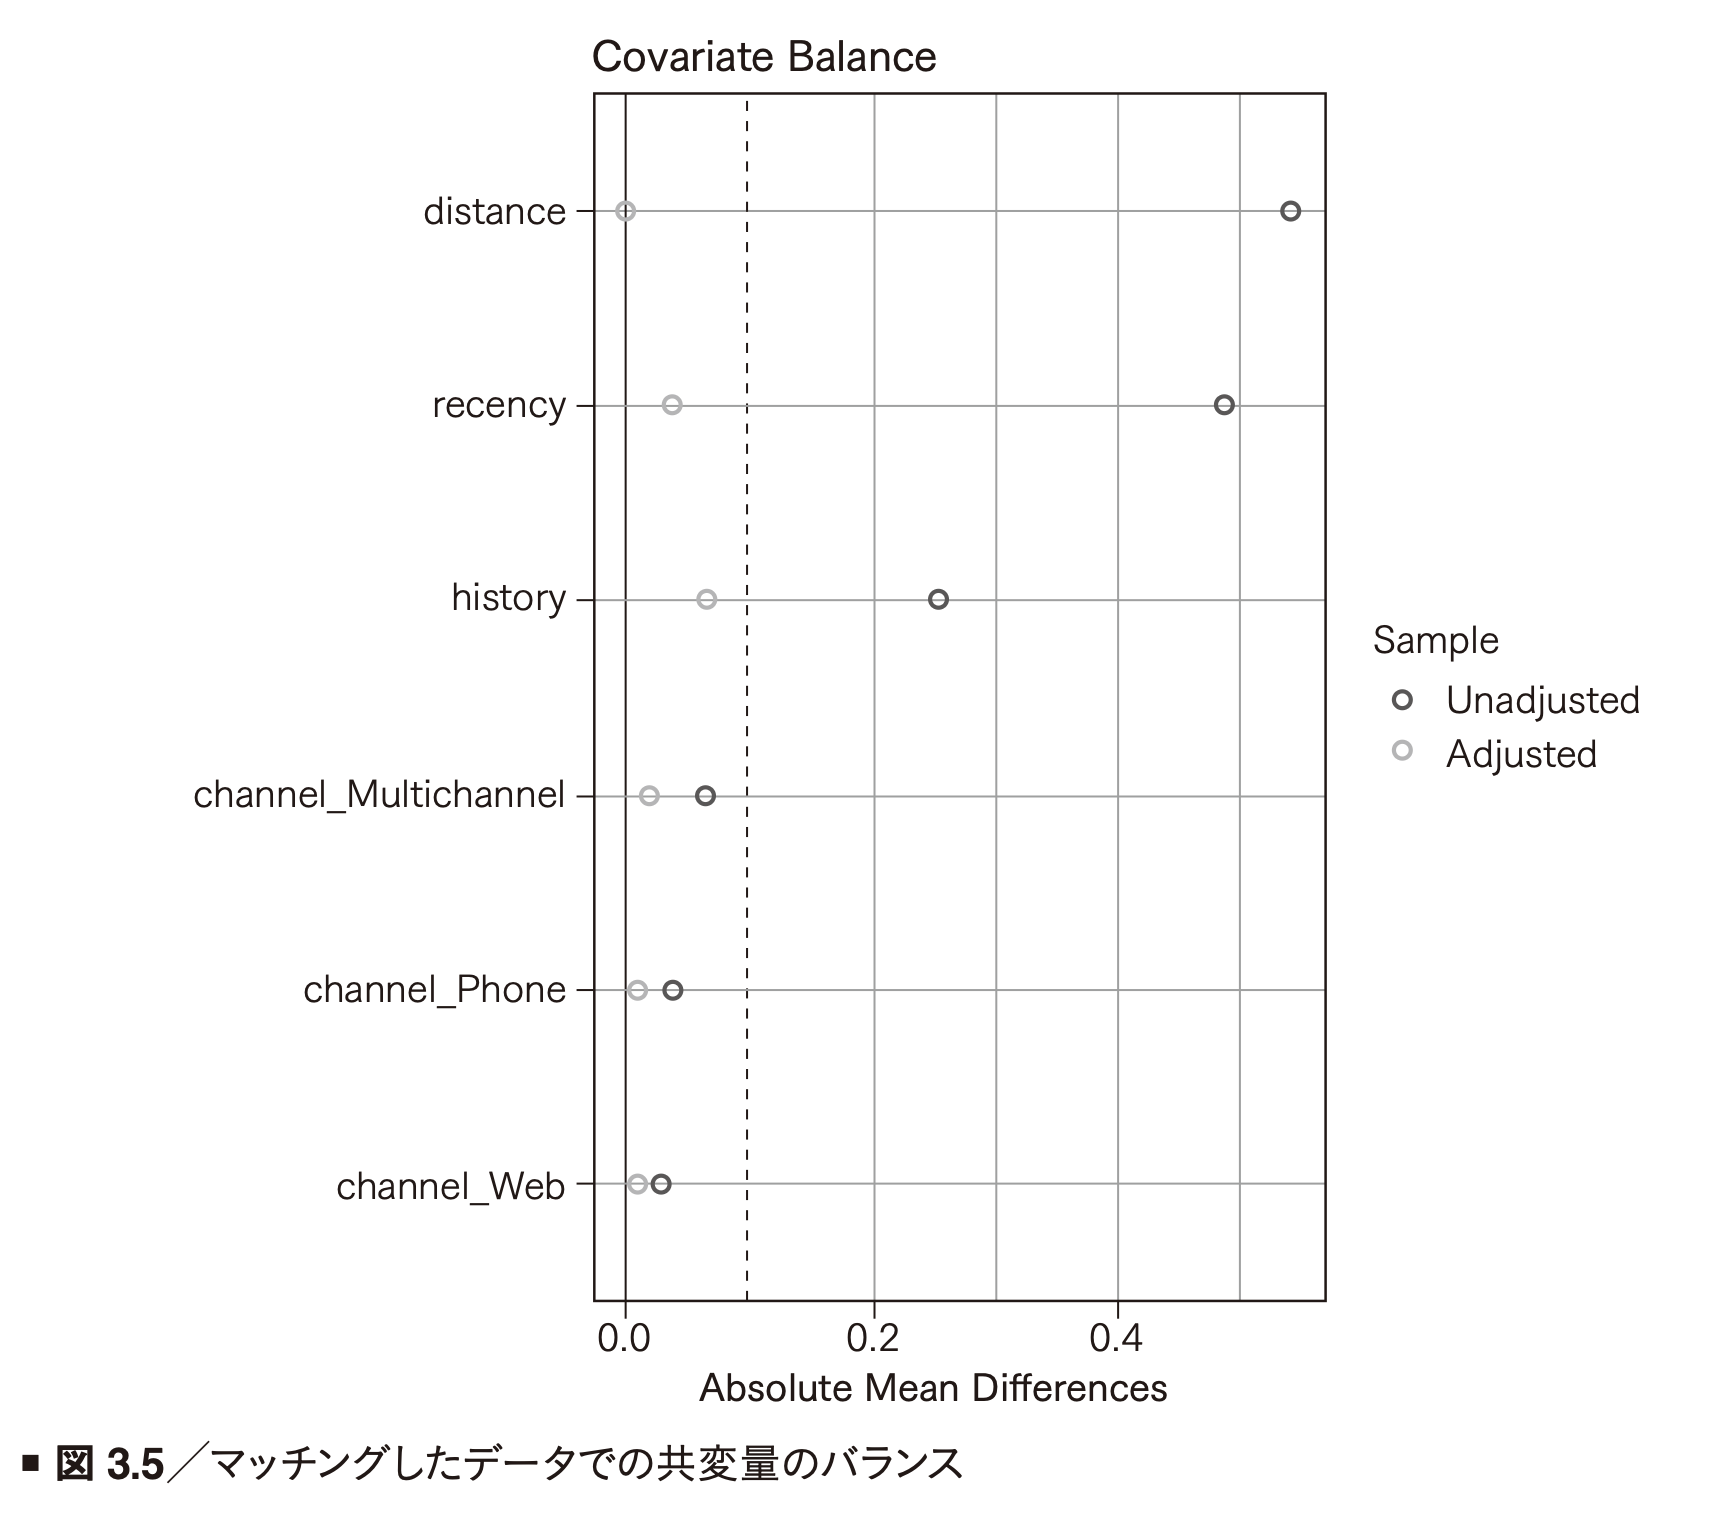
絶対SMDが0.1未満なら平均の差が小さい、という目安がよく使われる。ただし、1.2節で説明した未観測の関心などは、この確認では見つけられない。そのため、すべて0.1未満になっても、因果効果を正しく測れていると断定はできない。
なお、SMDの分母にはいくつか定義がある。例えばATTの分析では介入群の標準偏差を基準にする場合もあり、二値変数では割合の差をそのまま示す場合もある。別のライブラリのグラフと比較する際は、同じ計算方法かを確認する。
さらに、平均が同じでも人の構成は違うことがある。例えば、全員が10時間視聴する群と、半分が0時間、半分が20時間視聴する群は、どちらも平均10時間である。そのため、視聴時間では、未視聴者の割合や長時間視聴者の割合も確認するとよい。視聴日数とジャンルの組み合わせが結果に関係しそうなら、その組み合わせも比べる。
4.3 極端な重みと有効標本サイズ
IPWでは、観測されにくい人を大きな重みで補っていた。しかし、その重みが極端に大きいと、一人の結果が全体を大きく左右する。まず、どのような人に大きな重みが付くのかを確認しよう。ATEを推定する場合は、次のようになる。
| 観測された群 | スコア | 重み | 何が珍しいか |
|---|---|---|---|
| 介入者 | 介入されにくいのに介入された | ||
| 非介入者 | 介入されやすいのに介入されなかった | ||
| 非介入者 | 約1.01 | 非介入は普通なので大きくならない |
特に最後の行はLaLonde例で重要になる。スコアが小さいという理由だけで、すべての人の重みが大きくなるわけではない。
重みが少数の人に集中しているかを見る指標として、有効標本サイズ、ESSがある。全員に同じ重みが付いていれば人数と同じ値になり、一部の人だけが大きな重みを持つほど小さくなる。計算式は次のとおりである。
100人全員の重みが1なら、分子は 、分母は100なので、ESSは100となる。一方、一人の重みが100、残り99人の重みが1なら、重みの合計は199、重みの2乗の合計は10,099である。そのため、ESSは まで下がる。
このようなデータでは、100人を観測していても、推定結果が特定の一人に大きく依存していると分かる。ESSが小さければ、まず最大重みや、その重みを持つ人の特徴を確認する。ただし、ESSは情報量を厳密に人数へ換算した値ではなく、重みの偏りを見る目安である。介入群と対照群で状況が違うことも多いため、群別に計算する。
極端な重みへの対処法を読むときは、次の三つを区別するとよい。
| 操作 | 何を変えるか | 結果を読むときの注意 |
|---|---|---|
| クリッピング | 例えば0.001のPSを0.01に置き換え、重みを抑える | 本来と違う重みになるため、推定値が偏る可能性がある |
| トリミング | 例えばPSが0.01未満の人を分析から除く | 推定するのは、除外後の人たちに対する効果になる |
| 安定化重み | 各群の重みに、その群の割り当て割合など一定の値を掛ける | 本ノートのように群別の重み付き平均を取る場合、その定数は分子と分母で打ち消し合う |
いずれも、もともと存在しない比較相手を新たに作る操作ではない。計算が安定したかだけでなく、どの人について何を推定する形になったかまで確認する必要がある。
4.4 回帰分析と比べるときの注意
回帰分析でも、同じ人たちが新方針だった場合と従来方針だった場合を比べることができる。例えば、介入と過去の視聴履歴から視聴率を予測するモデルを作り、対象者全員について、新方針の場合の予測と従来方針の場合の予測を出す。そして、両方を同じ対象者で平均して引き算する。この方法を、回帰による標準化という。
このときモデル化するのは、特徴と介入から結果がどう変わるかを表す である。一方、IPWがモデル化するのは、特徴によって介入されやすさがどう変わるかを表す である。前者は結果を予測して比較し、後者は人に付ける重みを変えて比較する、という違いがある。
ただし、回帰式に介入変数 と共変量 を入れ、その の係数を読むだけでは、先ほどの「全員の予測を平均する計算」と同じ意味になるとは限らない。特に、人によって効果が違う場合は、回帰係数がどの人の効果をどれだけ反映しているかに注意が必要である。
したがって、回帰とIPWを比較するときは、まず同じ人たちの同じ平均効果を求めているかを確かめる。そのうえで値が違えば、予測モデルが合っていない可能性や、比較相手が少ない可能性を調べる。どちらの方法にも1.2節の前提が必要なので、二つの値が似ていることだけでは、未観測交絡がないとは言えない。
4.5 推定値がどれくらい不確かかも、計算方法に合わせて調べる
効果を0.8ドルと推定できても、その値がデータを取り直すたびに大きく変わるなら、慎重に判断する必要がある。この不確かさを表すのが標準誤差や信頼区間である。
教科書では、重みを付けた後に、結果を介入変数 だけで回帰することがある。切片と だけを入れた重み付き回帰では、 の係数が両群の重み付き平均差に一致するため、点推定を得る方法として使える。しかし、回帰ソフトが標準設定で返す標準誤差まで、そのまま適切とは限らない。通常の重み付き回帰が想定する重みの意味と、今回の割り当て確率を補う重みの意味が異なるためである。
また、PSもデータから学習した場合は、PSが変われば重みも変わる。そのため、効果の不確かさを調べるときには、その学習段階も考慮する必要がある。方法の一つに、データを繰り返し取り出し直してPSから計算し直すブートストラップがある。別の方法として、PSと効果の推定をまとめて数式で扱う方法や、一人のデータが推定値へ与える影響を使って標準誤差を求める方法もある。
ただし、データの取り出し直し方にも注意が必要である。例えば、同じアカウントの家族の視聴が互いに関係するなら、プロフィールをすべて独立した人として扱うのは不適切になり得る。この場合は、アカウントを単位にした計算を検討する。
さらに、最近傍の相手を固定個数だけ選ぶマッチングでは、通常のブートストラップが適切に働かない場合が知られている。同じ対照者を何組にも再利用したときも、それらの組を独立とは数えられない。したがって、IPWとマッチングに同じ標準誤差の計算をそのまま使うことはできない。付属の簡易PSMは、効果の点推定と特徴のバランス確認を行う教材として使う。Abadie・Imbensの原論文
5. Polarsによるメールデータ分析(3.1.2・3.2の実装)
ここからは、ここまで説明した手順を実際のデータで試す。使うのは、メールを送るかどうかをランダムに決めた実験データである。まず元の実験での平均差を求める。次に、わざと人の構成を偏らせたデータを作り、PSMやIPWで比較を調整すると値がどう変わるかを見る。
5.1 実行方法とRからPythonへの対応
分析全体を実行するコードは ch3_examples.py にある。データの読み込み・抽出・列の追加にはPolarsを使い、モデルの学習と数値計算にはNumPy/SciPyを使う。Stata形式のデータを読む箇所ではpyreadstatを使うが、pandasへの変換は行わない。
プロジェクトのルートで、次の順に実行すると、分析結果の表示、グラフの生成、ノートのサイト生成を行える。
uv run output/ch3_examples.py
uv run output/ch3_plots.py
uv run python build.py
各スクリプトの先頭には、必要なライブラリを記載してある。これはPEP
723という形式であり、 uv run
がその指定を読み取って実行環境を用意する。グラフのHTMLは
figs/plotly/
に保存される。表示時にはPlotlyのライブラリをインターネットから読み込むため、通信できる環境が必要である。
Rのコードと見比べたい場合は、次の対応表を使うとよい。ただし、付属の
match()
は説明用の簡易実装なので、Rのマッチングライブラリとすべての設定や結果が一致するわけではない。
| Rでの処理 | Pythonでの対応 |
|---|---|
read_csv, filter, mutate,
rbind |
Polarsの read_csv, filter,
with_columns, concat |
glm(..., family=binomial) |
fit_logistic(x, z) |
predict(..., type="response") |
モデルの predict(x) |
matchit, Match |
設定を明示した match()。全機能の互換実装ではない |
weightit(..., estimand="ATE") |
weights(z, e, "ATE") |
lm(Y ~ Z, weights=...) の係数 |
difference(y, z, w) |
love.plot |
balance() とPlotly |
read_dta |
pyreadstat.read_dta(..., output_format="dict")
とPolars |
percent_rank |
(rankdata(score, method="min") - 1) / (N - 1) |
rbinom |
rng.binomial(1, probability) |
pyreadstatの辞書出力は公式に提供されており、pandasを経由せずPolarsに渡せる。pyreadstatの公式説明
5.2 データを読み、バイアスのある標本を作る
Hillstromのデータには、男性向け商品を案内するメール、女性向け商品を案内するメール、メールなし、という割り当てがある。今回は、男性向けメールとメールなしの二つを比較する。そのため、女性向けメール群を除き、男性向けメールなら
treatment=1 、メールなしなら0となる列を作る。
ここで「男性向け」はメールの種類である。受信者の性別が男性であることを条件にしているわけではない。
import polars as pl

df = (
    pl.read_csv("data/hillstrom.csv", schema_overrides={"spend": pl.Float64, "history": pl.Float64})
    .filter(pl.col("segment") != "Womens E-Mail")
    .with_columns(
        (pl.col("segment") == "Mens E-Mail")
        .cast(pl.Int64).alias("treatment")
    )
)
次に、このデータから一部の人を取り出し、メール群にもともと購入しやすそうな人が多くなるようにする。具体的には、過去購入額が300を超える、最後の購入から6か月未満、複数チャネルを利用している、という条件のどれかを満たす人を、説明上「高意欲」と呼ぶ。
高意欲なメール受信者は全員残す一方、同じ高意欲でもメールを受け取っていない人は半分ほどに減らす。条件を満たさない人では逆に、非受信者を全員残し、受信者を半分ほどに減らす。こうすると、元はランダムな実験でも、取り出したデータでは両群の人の構成が偏る。
import numpy as np

rng = np.random.default_rng(1)
high = (
    (df["history"] > 300)
    | (df["recency"] < 6)
    | (df["channel"] == "Multichannel")
).to_numpy()
z = df["treatment"].to_numpy()

# 高意欲の受信者、または低意欲の非受信者なら全員残す。
# それ以外の人は、確率0.5で残す。
keep_probability = np.where(z == high.astype(int), 1.0, 0.5)
biased = df.filter(pl.Series(rng.random(len(z)) < keep_probability))
この抽出は、バイアスがある状況を作って手法を学ぶための操作である。実務の効果検証で、同じようにデータを偏らせる必要があるわけではない。
また、人を取り出した後は、同じ特徴の人の中でメール群が占める割合も変わる。したがって、元の実験の割り当て確率1/2をそのまま使えない。ここでは、抽出後のデータから改めて傾向スコアを推定する。
5.3 モデル推定からIPWまで
次のコードは、直前に作った biased
を使う。まず、介入前の情報である recency 、
history 、 channel から、メールの割り当て確率
e を学習する。その後、同じ e
をマッチングとIPWに使う。関数の詳しい定義は ch3_examples.py
にあり、次の断片は同じファイルがある output/
から読み込む想定である。
from ch3_examples import matrix, fit_logistic, weights, difference, match, balance

x, names = matrix(biased, ["recency", "history", "channel"])
z = biased["treatment"].to_numpy()
y = biased["spend"].to_numpy()
e = fit_logistic(x, z).predict(x)

t, c = match(z, e, replace=True)
psm = (y[t] - y[c]).mean()

w = weights(z, e, target="ATE")
ipw = difference(y, z, w)
diagnostics = balance(x, names, z, w)
matrix()
は、モデルに入力できるように特徴を数値の表へ変換する。例えばチャネルがWebかどうかを0/1で表す列を作る。このように、カテゴリを0/1の列に変える処理をダミー変数化という。続く
fit_logistic()
は、視聴や売上ではなく、割り当ての0/1を学習している。
match() が返す t と c
は、それぞれ組になった介入者と対照者の行番号である。そのため、
y[t] - y[c] で各組の売上差を計算できる。一方、
weights() は全員の重みを作り、 difference()
はその重みを使った平均差を計算する。
なお、付属の matrix()
は、特徴に欠損があるとエラーにする。データがない人を自動的に除くと、さらに対象者の構成が変わる可能性があるためである。実務では、なぜ欠損したのかを調べてから、補完するか、欠損したこと自体を特徴にするか、除外するかを決める。
この例では、人を残すルールに「購入額が300を超えるか」のような境界を使った。一方、PSモデルには購入額そのものを入れているので、その境界で急に変わる割り当てを完全には表現できない可能性がある。そこで、最後の
balance()
によって、実際に両群の特徴が近づいたかを確認する。
このメール例は教科書に合わせて復元あり、LaLonde例は復元なしとする。今回の実行結果は後掲の実行記録にまとめる。教科書にはマッチング約0.888ドル、IPW約0.870ドルという値が載っているが、RとNumPyの乱数、抽出された行、マッチングの同点処理が異なるため、小数点以下までの一致は要求しない。
6. MLで重点配信したメールの効果を測る(3.3)
次は、より実務に近い状況を考える。機械学習で購入しそうな人を予測し、その人にメールを送りやすくした場合である。この配信ルールでは、メール群にもともと購入しやすい人が集まる。その偏りを、記録した配信確率から調整してみよう。
6.1 売れそうな人の予測と、効果が大きい人の予測は違う
まず、「購入しそうな人」と「メールによって購入が増える人」を区別する必要がある。メールを送らなくても購入する確率が高い人に送れば、配信後の購入率は高くなりやすい。しかし、その購入のほとんどがメールなしでも起きるなら、メールによる増加分は小さい。
メールなしの人のデータで、特徴 から購入の有無を予測するモデルを考える。このモデルが表す購入確率を と書く。ここでは を購入あり、 をメールなしとする。
この予測値の高い人へ優先して配信すると、メール群に購入しやすい人が多く集まる。そのため、メール群と非配信群の単純な購入率差には、もともとの違いも混ざる。同じことはHuluの推薦にも起こる。
例えば、ユーザAは推薦がなくても80%、推薦があれば81%の確率で視聴するとする。一方、ユーザBは推薦なしで10%、推薦ありで25%である。推薦後の視聴確率ならAの81%が高いが、増加分を計算すると、Aは ポイント、Bは ポイントとなる。したがって、視聴確率を高く予測できることと、推薦の効果が大きい人を見つけられることは異なる。
6.2 教科書の疑似ログ生成の手順
この配信を実際に新しく行う代わりに、教科書では元のRCTデータから、MLで配信対象を選んだようなデータを作る。まずデータをランダムに二分し、一方をモデル学習用の「過去」、もう一方を配信対象の「未来」と見立てる。実際に日付で分割するわけではない。
過去側では、メールなしの人だけを使って購入確率モデルを学習する。こうするのは、メールがなくても購入しそうな人を予測したいからである。そのモデルで、未来側の各人の購入確率を求める。
次に、未来側の人を予測値の低い順に並べ、「下から何%の位置にいるか」を求める。これがパーセントランクである。教科書では、その順位の割合を配信確率として使う。例えば、下から90%の位置にいる人には90%の確率でメールを出す、という方針にする。
その確率で乱数を引き、各人について、仮想的に配信するかしないかを決める。最後に、仮想的な割り当てと、元の実験での割り当てが一致した行だけを残す。
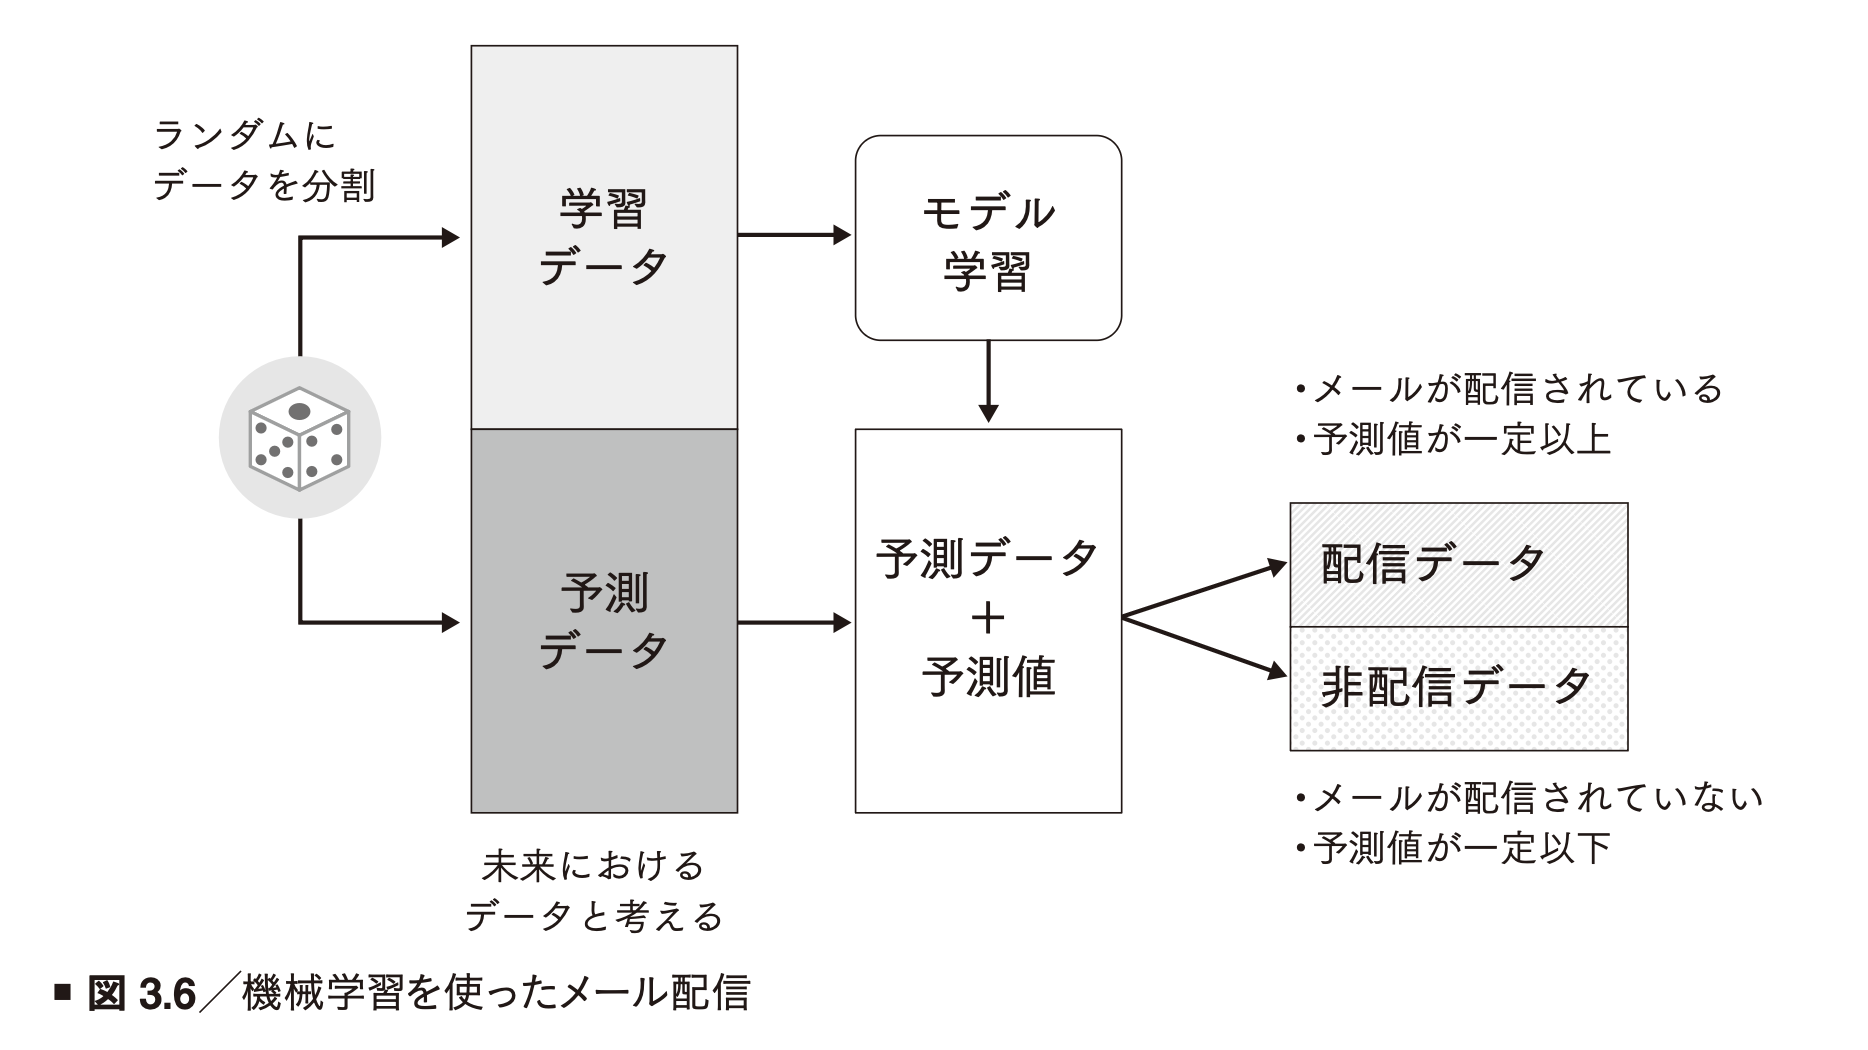
なぜ一致した行だけを残すのだろうか。例えば、元の実験でメールを受け取っていない人を、仮想方針では配信対象に選んだとする。しかし、その人がメールを受け取った場合の売上は記録されていない。元の売上を「メールありの結果」として使うことはできないため、その行を除くのである。
反対に、元の実験でも仮想方針でもメールありなら、その行には必要な結果が記録されている。両方ともメールなしの場合も同様である。こうして、観測済みの結果を正しい介入の結果として使える行を残している。
6.3 なぜ残った行で配信確率が使えるのか
ただし、一部の行を残した後でも、仮想方針の確率をそのままPSとして使えるかは確認が必要である。ここでは、その理由を数値で考えてから一般式を見る。
元の実験が50%ずつの配信で、あるタイプへの仮想方針の配信確率が80%だったとする。このタイプで「両方ともメールあり」になる確率は である。一方、「両方ともメールなし」になる確率は である。したがって、行が残る確率は0.5であり、残った行の中でメールありとなる割合は となる。元の仮想配信確率と一致した。
この計算を記号で書いてみよう。元のRCTの配信確率を 、仮想方針の配信確率を 、行が残ることを とする。元の割り当てと仮想割り当てを独立に生成すると、残った行での配信確率は次の値になる。
分子は「両方とも配信あり」となる確率、分母は「両方ともあり、または両方ともなし」となる確率である。 を代入すると、先ほどの数値例と同じように が残る。
さらに、この場合は、どのタイプでも行が残る確率が となる。そのため、特定のタイプだけが多く除かれることもない。偶然のばらつきはあるが、残ったデータの人の構成は、元の未来側の構成を保つことが期待できる。
一方、元の配信確率が0.8で、仮想方針の確率が0.9なら、残った行でのPSは となる。この場合は0.9をそのまま使えない。行が残る確率もタイプによって変わるため、元の全体に対する効果を求めるなら、人が残る過程の偏りも別途調整する必要がある。
6.4 Python版では、どの人にも配信あり・なしの可能性を残す
教科書のようにパーセントランクをそのまま確率にすると、0や1になる場合がある。0の人には必ず配信せず、1の人には必ず配信するため、その条件で配信あり・なしを比較できなくなる。
そこで付属Pythonでは、配信確率を5%から95%の範囲にする。購入しにくそうな人にも少し配信し、購入しそうな人にも少し非配信を残すことで、どちらの結果も観測する機会を作る。このために次の式を使う。
順位が最下位で値が0なら配信確率は0.05、最上位で1なら0.95、中央で0.5なら0.5となる。ここでは、この確率を実際の仮想割り当てに使っている。したがって、後から推定PSだけを丸めるクリッピングとは違い、データを作る配信方針を変えた例となる。
import numpy as np
from scipy.stats import rankdata

# score: 未来側に対する、非介入時の購入確率予測
rank = (rankdata(score, method="min") - 1) / (len(score) - 1)
q = 0.05 + 0.90 * rank
rng = np.random.default_rng(3)
assigned = rng.binomial(1, q)
keep = assigned == original_treatment
# original_treatmentが1/2のRCTなら、keep後のPSにq[keep]を使う
コードの assigned は、確率 q
で1になるように乱数を引いた結果である。この q
が、実際に仮想配信を決めた確率なので、後の分析でも保存した値を使う。単に予測値の順位を計算しただけでは、PSを記録したことにはならない。
なお、予測値が同点の場合は同じ順位を付けている。そのため、
q
が0.05から0.95まで等間隔に並ぶとは限らないが、割り当てに実際に使った確率であることは変わらない。
教科書では、未来側のRCTの平均差が約0.897ドルだったのに対し、ML配信を模したデータの単純差は約1.35ドルとなった。購入しやすい人が配信群に多くなったため、差が大きく見えている。その後、PSMでは約1.173ドル、ATEを求めるIPWでは約0.816ドルとなっている。
ただし、PSMはATT、ここでのIPWはATEを求めているので、二つの値が必ず一致するわけではない。また、PSMの検定で有意差が出なかったことは、効果が0だと確認されたことを意味しない。今回のPython版は乱数と配信方針を一部変更しているため、実行結果は11節に別途示す。
6.5 決定的なランキングのスコアを逆数にしてはいけない
ここまでの例では、確率を使って配信するかどうかを決めた。一方、実務では「スコアの上位100人に必ず配信する」というルールもある。この場合、順位や候補者全体など、ルールに必要な情報がすべて分かれば、誰に配信するかは決まっている。その情報のもとでの割り当て確率は0か1である。
例えば、購入確率の予測値が0.7でも、上位100人に入れば必ず配信される。この0.7は購入の確率であり、配信の確率ではない。同じように、Two-Towerの内積やsoftmaxの値も、その値を使って実際にランダムに選んだのでなければ、割り当て確率とは呼べない。
このようなデータで効果を知りたい場合は、まず、比較できる情報をどう得るかを考える必要がある。例えば、一部をランダムに割り当てる実験を設ける方法がある。また、数値の境界で介入を決めているなら、境界のすぐ上と下を比較するRDDを検討できる場合もある。ただしRDDにも、境界を挟んで介入以外の条件が急に変わらないことなど、別の前提が必要である。
7. LaLonde:実験の対照群を別調査で置き換える(3.4)
前のメール例では、同じ実験データから一部の人を取り出して偏りを作った。次は、介入群と対照群を別々の調査から集める場合を考える。Huluに置き換えると、新しい推薦の利用者を、別の時期や別の利用条件の人と比較するような状況である。二つの集団が大きく違う場合に、PSを使った調整がどこまで役立つかを学べる。
7.1 NSW、CPS1、CPS3は何が違うのか
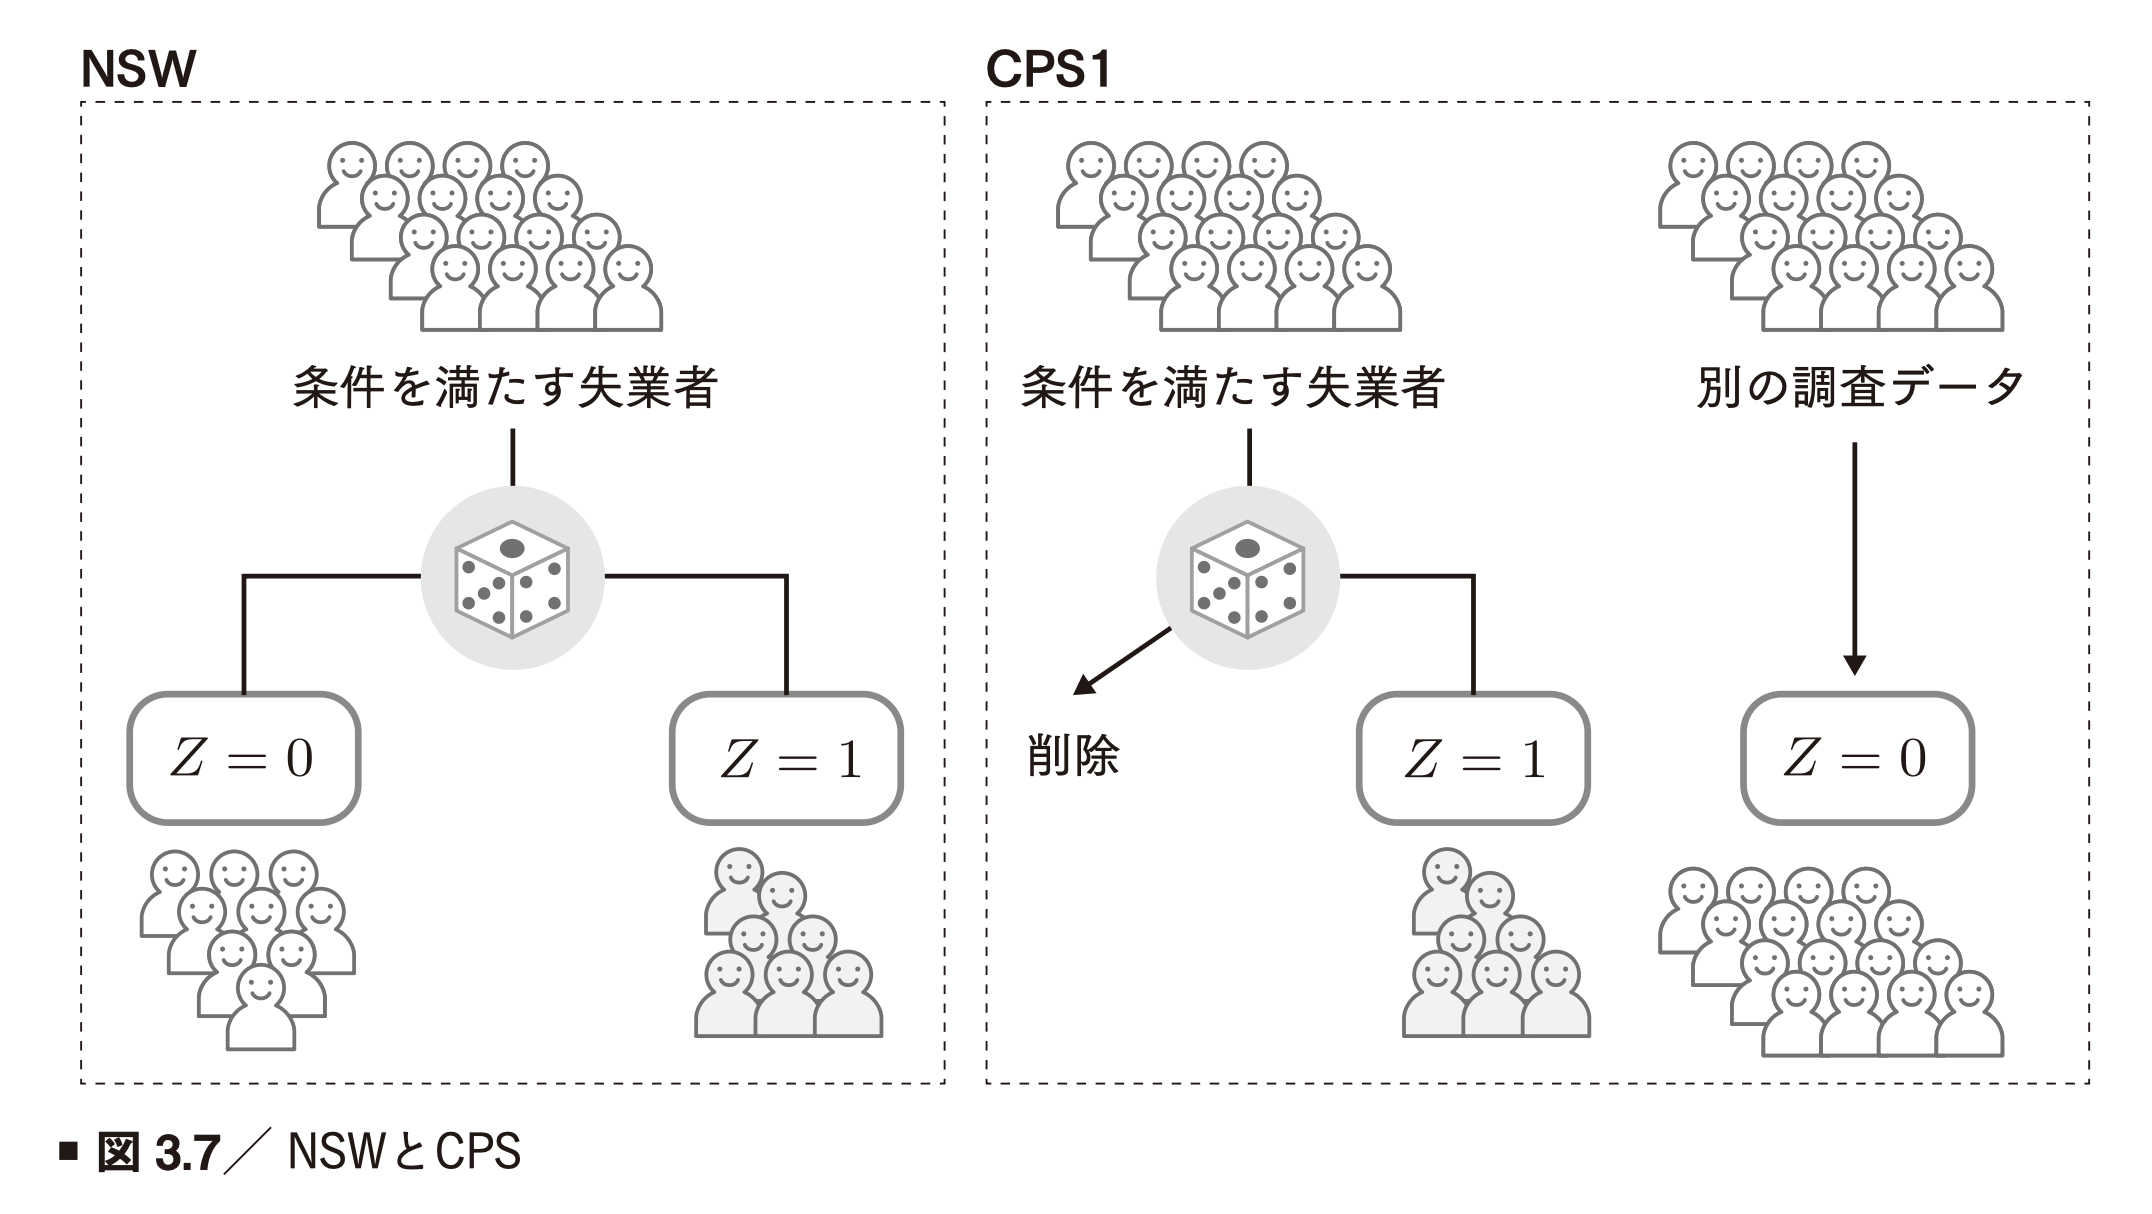
NSWは、就業に困難を抱える人を対象にした就業支援の実験である。参加者を、職業訓練を受ける群と受けない群へランダムに割り当てた。ここでは、その割り当てを
、後の1978年の所得 re78 を結果
とする。分析には、Dehejia–Wahbaが公開しているデータを使う。著者のデータ配布ページ
この実験の元の両群を比較すれば、実験に基づく効果の推定値を得られる。そこで、その値を基準として知ったうえで、実験の対照群を、CPSという別の調査の人たちに置き換えてみる。置き換えた後でも、回帰やPSによる調整で実験に近い値を得られるだろうか、というのがここでの問いである。
| データ | 介入群 | 対照群 | 主な問い・難しさ |
|---|---|---|---|
| NSW | NSWの介入者 | NSWの無作為割り当て対照者 | 実験参加者に対する効果の基準 |
| NSW + CPS1 | 同じNSW介入者 | 広いCPS標本 | 集団の違い、交絡、重なり不足 |
| NSW + CPS3 | 同じNSW介入者 | 条件を絞ったCPS標本 | 比較可能性が改善するか |
CPS1には、NSWの参加者よりも広い範囲の人が含まれる。その中には、もともと安定して働いていた人もいるため、そのままでは就業支援の対象者に近い比較相手にならない可能性がある。
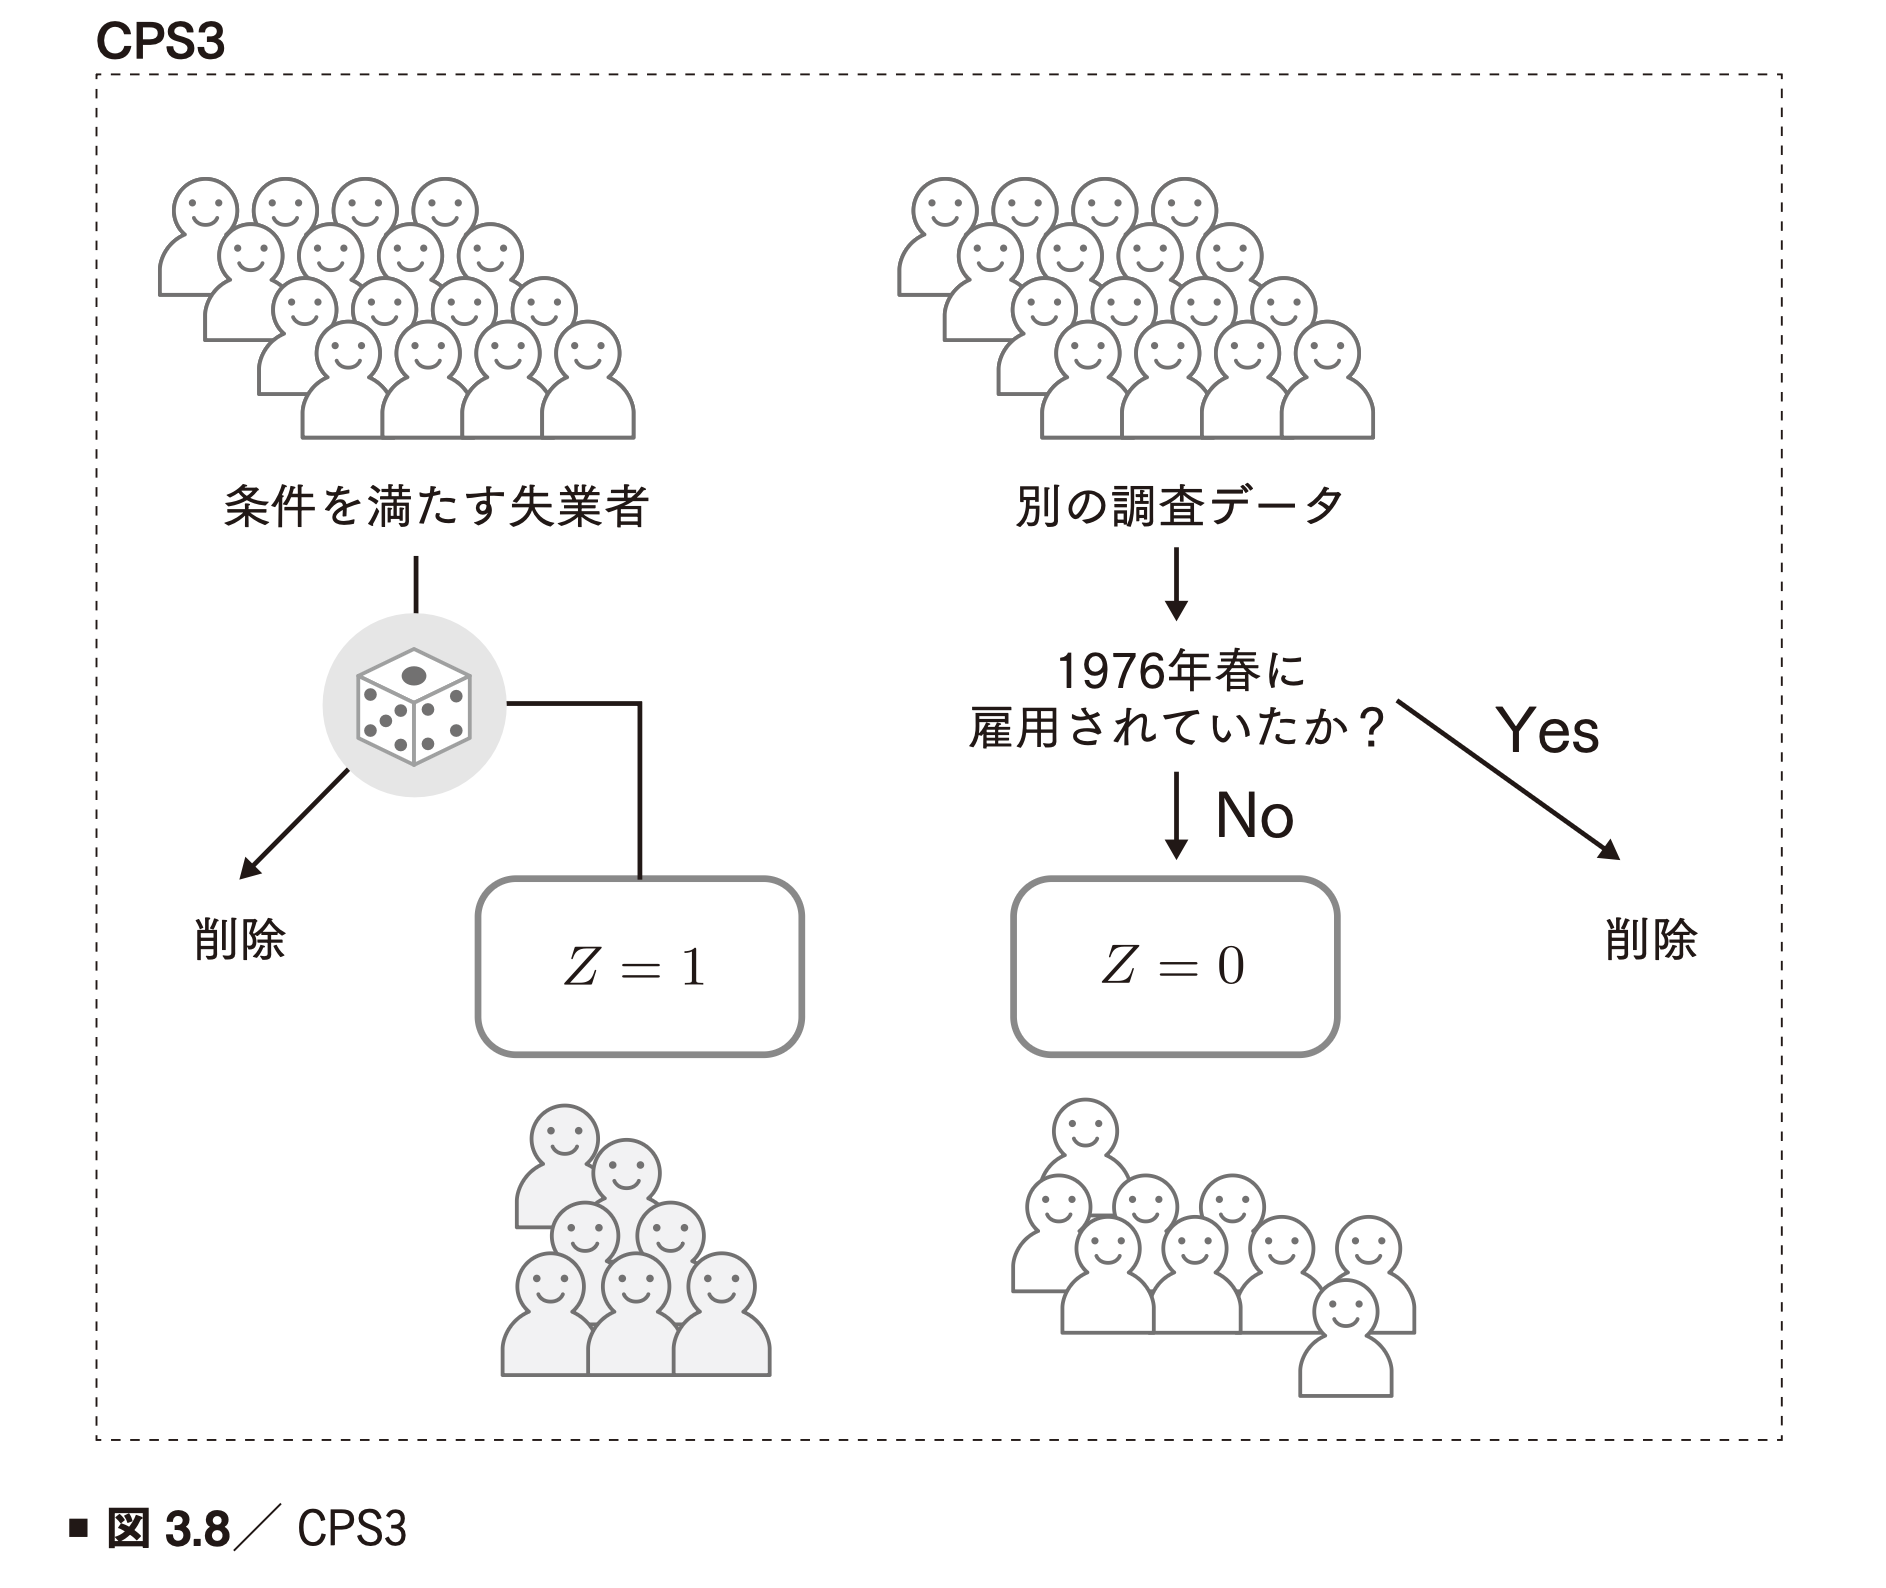
一方、CPS3は条件を絞った対照標本である。教科書では、1976年春に雇用されていないなどの条件を満たす人に絞ったものとして説明している。対象を絞ることで、NSWの参加者に近い人を比較相手にできるかを調べる。今回のPythonでも、公開されているCPS3のファイルをそのまま読み込む。
7.2 共変量と回帰分析(3.4.1〜3.4.3)
まず、所得に関係しそうな介入前の違いを回帰で調整してみよう。使うのは、過去の所得、年齢、教育年数などである。特に過去の所得は、支援がなくてもどれくらい働けそうかを考えるための情報になる。
| 変数 | 内容 |
|---|---|
re74, re75 |
1974・1975年の所得 |
age |
年齢 |
education |
教育年数 |
black, hispanic |
元データの人口統計区分を示す指標 |
nodegree |
学位を持たないことの指標 |
married |
既婚の指標 |
これらの特徴を とし、次の回帰をNSW、CPS1との混合、CPS3との混合の三つに適用する。
この式では、年齢や過去の所得による違いを で表し、それらを調整した後の訓練あり・なしの差を係数 で表す。教科書の推定値は、NSWで約1,676ドル、CPS1で約699ドル、CPS3で約1,548ドルとなっている。
CPS1では、対照群に元々所得の高い人が多いため、調整なしの比較は大きく偏る。回帰で調整しても、年齢や過去の所得と結果の関係を十分に表せていなければ、偏りは残る。また、記録していない就業意欲などの違いが残っている可能性もある。一方、比較相手を絞ったCPS3では、今回の回帰の推定値は実験の値に近くなっている。
ただし、実験の約1,676ドルも、限られた参加者から求めた推定値なので、真の効果と完全に一致するとは限らない。さらに、人によって訓練の効果が違うなら、回帰係数をそのまま混合集団全体のATEと呼べないことは4.4節で説明したとおりである。したがって、値の違いを見るときは、比較相手の違いに加えて、回帰の表現が十分か、誰の効果を求めているかも確認する必要がある。
7.3 マッチングでNSW介入者に近い比較相手を選ぶ(3.4.4)
次に、NSWの各介入者について、CPSからPSの近い人を一人ずつ探す。元の介入者185人を出発点にするので、その人たちが訓練を受けなかった場合を、CPSの人で推定しようとしている。
PSモデルには、回帰で使った特徴に加えて、過去所得 re74 と
re75
の2乗を入れる。例えば、所得が少し増えたときの割り当て確率の変化が、低所得の人と高所得の人で同じとは限らない。2乗の項を加えることで、所得に対して曲がった関係も表せるようにする。
付属コードでは、所得を1,000で割ってから2乗し、値が極端に大きくならないようにしている。これは係数で調整できる定数倍なので、罰則を使わない今回のモデルが表現できる関係は変わらない。
import polars as pl
import pyreadstat

raw, metadata = pyreadstat.read_dta(
    "data/nsw_dw.dta", output_format="dict"
)
nsw = pl.DataFrame(raw)
raw, _ = pyreadstat.read_dta(
    "data/cps_controls.dta", output_format="dict"
)
cps = pl.DataFrame(raw)
combined = pl.concat([
    nsw.filter(pl.col("treat") == 1).cast(pl.Float64),
    cps.select(nsw.columns).cast(pl.Float64),
])
combined = combined.with_columns(
    (pl.col("re74") / 1000).pow(2).alias("re74_sq"),
    (pl.col("re75") / 1000).pow(2).alias("re75_sq"),
)
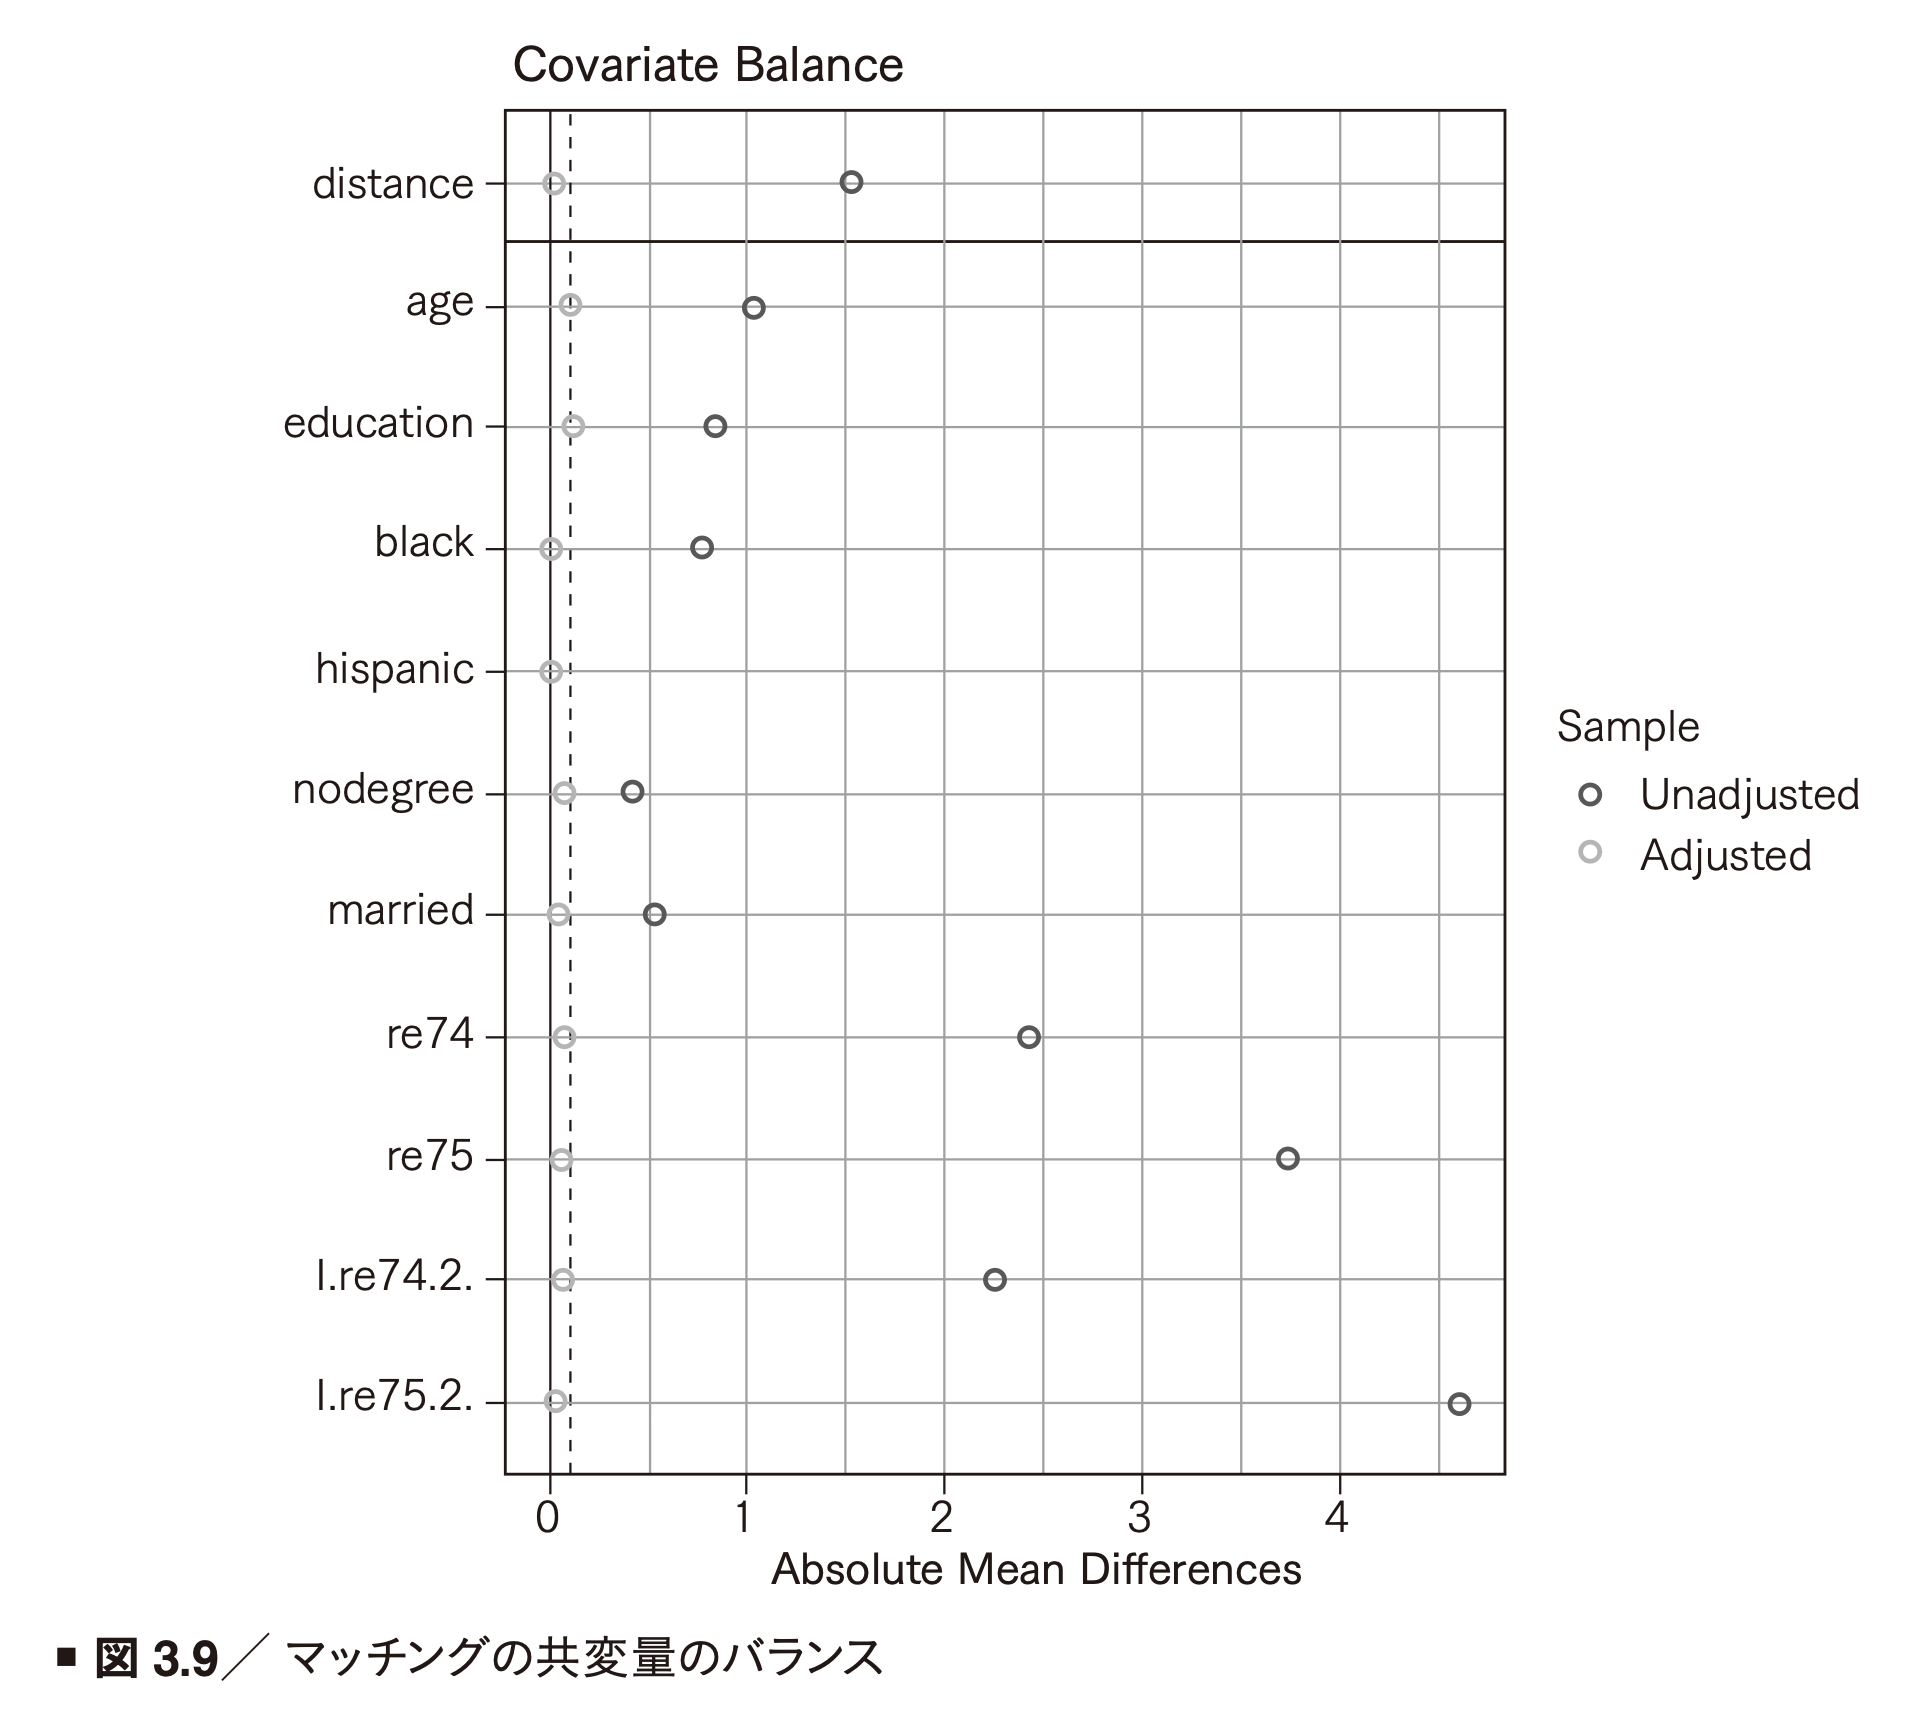
このように準備したデータでマッチングすると、教科書では約1,830ドルという推定値が得られている。実験の約1,676ドルに近い値だが、ここで確認したいのは値の近さだけではない。各NSW介入者にどのような相手を選んだか、その結果として年齢や過去所得の差が小さくなったかも調べる。その確認を示したのが、次の図である。
7.4 IPWの大きな負の推定値をどう読むか
同じCPS1のデータにIPWを使うと、教科書では約−7,627ドルという大きな負の値になる。マッチングでは正の値だったのに、なぜこれほど違うのだろうか。まず、両者が平均しようとしている人たちの違いを見る必要がある。
このマッチングは、NSWの介入者に近い対照者を探し、NSWの介入者について平均する。一方、ここでのIPWはATEを求めているので、CPSも含む対象者全体を新旧両方の状態にした場合の平均を推定しようとする。
ところが、NSWの介入者には、失業や低所得の人が多い。CPSに多い「もともと所得が高い人」が訓練を受けた場合の結果は、介入群にはほとんど記録されていない。そのため、全体のATEを計算しようとすると、ごく少数の介入者に大きな重みを付け、広い範囲の人を代表させることになる。これが推定を不安定にする。
例えば、CPSには多いがNSWの介入者には少ない特徴の人は、混合集団でのPSが小さくなりやすい。その特徴を持つ介入者の重み は大きくなる。一方、同じ特徴を持つCPSの対照者は、重み がほぼ1になる。つまり、PSが小さいからといって、CPSの対照者全員が大きな重みを持つわけではない。教科書の説明を読む際も、どちらの群の重みを考えているかを区別する必要がある。
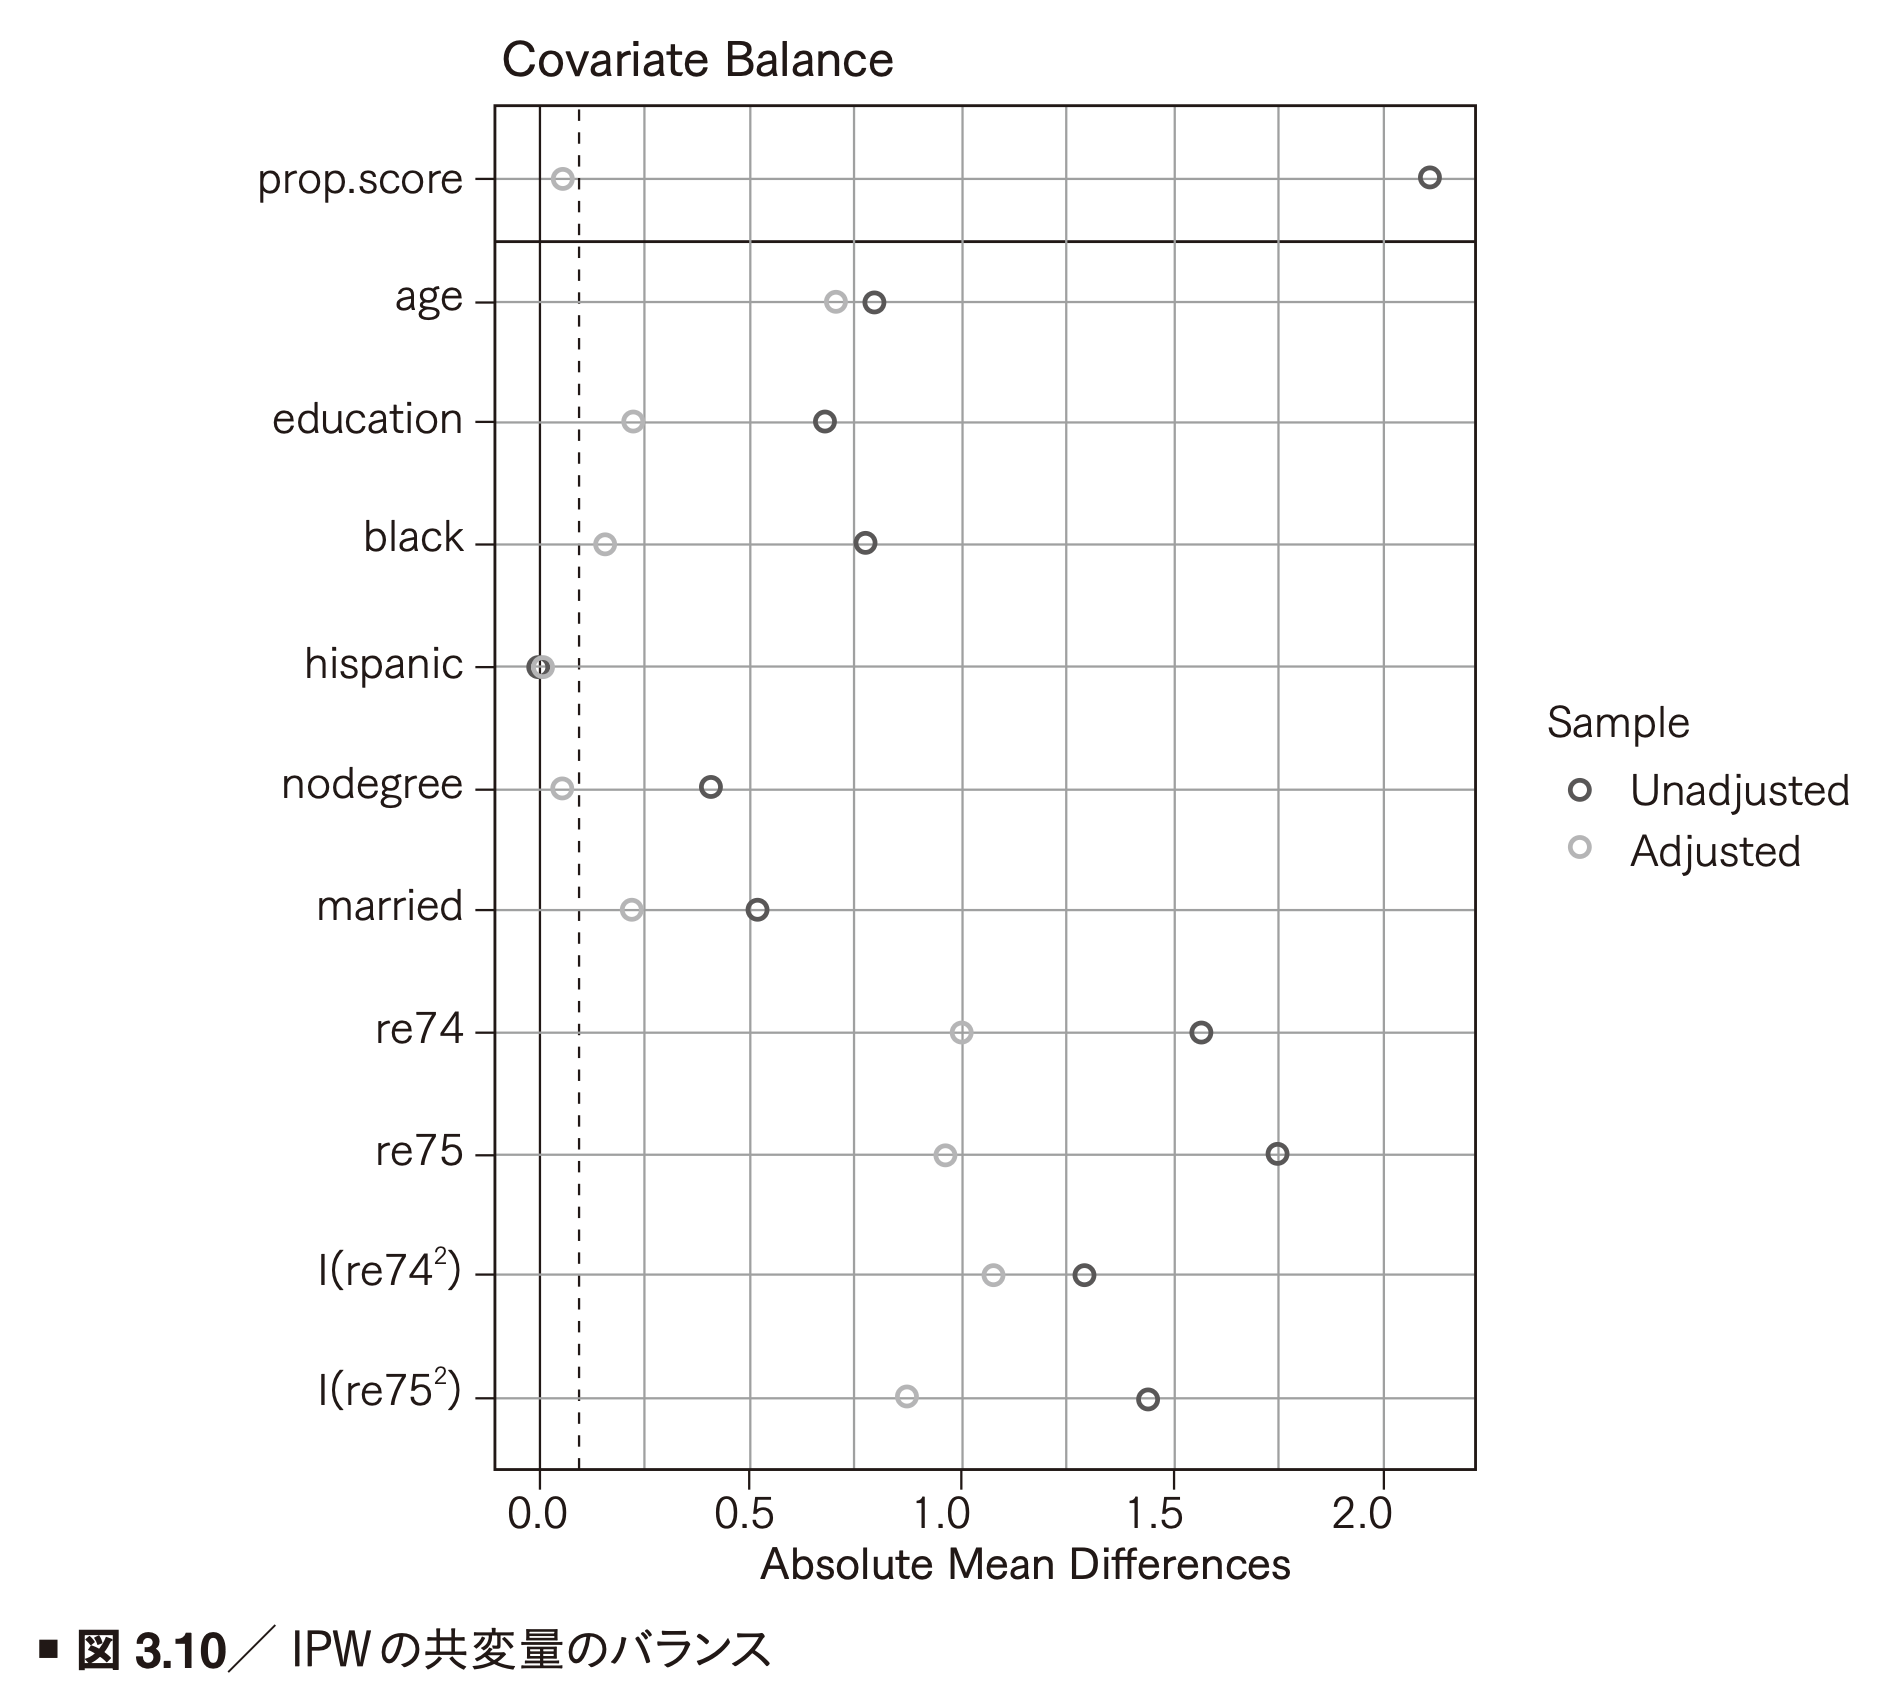
このような状況では、対照者が大量にいても、必要な特徴の介入者が少なければ比較は安定しない。さらに、重み付け後にも特徴の差が大きく残っているなら、−7,627ドルをそのまま訓練の効果とは解釈できない。p値が小さくても、適切な比較相手がいるという前提まで保証されるわけではないためである。
今回のPythonでは、効果の値に加えて、群ごとのESSと最大重みも出力する。また、IPWでATTを求めた場合や、次節で説明する別の重みを使った場合も並べる。それぞれ誰の効果を求めているかを確認しながら読むとよい。
7.5 データ取得と再現上の違い
使用ファイルは data/nsw_dw.dta 、
data/cps_controls.dta 、
data/cps_controls3.dta
である。取得元は次の公開URLである。
curl -fL -o data/nsw_dw.dta https://users.nber.org/~rdehejia/data/nsw_dw.dta
curl -fL -o data/cps_controls.dta https://users.nber.org/~rdehejia/data/cps_controls.dta
curl -fL -o data/cps_controls3.dta https://users.nber.org/~rdehejia/data/cps_controls3.dta
「LaLondeデータ」という名前でも、ライブラリによって、含まれる対照者や人数が異なる場合がある。そのため、別の解説と数値を比べるときは、まず同じファイルを使っているかを確認する。そのうえで、使った特徴、ATEとATTのどちらを求めたか、マッチングの順番や同点の扱いを確認する。同じ手法名でも、これらが違えば結果は変わる。
8. 教科書から一歩進む:状況に応じて役立つ手法
ここまでの内容を押さえたら、次に、推定を改善するための方法も見ておこう。最初に紹介するAIPWは、視聴率の予測と傾向スコアの両方を使う方法である。続くcross-fittingは、その予測を学習するデータの分け方である。最後のoverlap weightingは、比較相手が少ない人を無理に重く数えず、比較しやすい人を中心に平均する方法である。
いずれも、1.2節の前提を不要にする方法ではない。それぞれが、モデルの誤り、学習データへの過学習、極端な重みという別々の問題に対応する。
8.1 AIPW:結果の予測と傾向スコアを組み合わせる
IPWでは、「この人はどれくらい介入されやすかったか」をモデル化した。一方、回帰による標準化では、「この人が介入された場合と、されなかった場合に、どれくらい視聴しそうか」をモデル化した。AIPWは、この二つを組み合わせる。
まず、介入あり・なしの二つの視聴率予測を作る。それらを と と書く。一般には、介入状態を として次のように表す。
例えば 、 なら、モデルはその特徴の人について「介入ありなら30%、なしなら20%視聴する」と予測している。したがって、予測だけで考えた効果は10ポイントである。
ただし、予測が正しいとは限らない。そこで、実際に観測できた側の結果を使って、予測がどれくらい外れたかを調べる。さらに、その人がその側に割り当てられた確率を使って、予測の外れを全体に反映する。これがAIPWの補正である。全体の式は次のようになる。
長い式だが、一人分の計算を三つに分けると理解しやすい。
| 式の部分 | 何を計算しているか |
|---|---|
| 予測モデルだけから求めた効果 | |
| 介入者について、実際の結果と介入ありの予測のずれを重み付けした補正 | |
| 対照者について、実際の結果と介入なしの予測のずれを重み付けした補正 |
介入者では なので最後の項が0になる。対照者では なので真ん中の項が0になる。したがって、観測していない結果を直接使うことはない。最後に、この一人分の計算を全員で平均する。
例えば、ある人の 、 、 とする。その人が介入され、実際に視聴したなら、一人分の計算は次のようになる。
この人は、30%しか視聴しないと予測されていたのに、実際には視聴した。そのため、観測した側の予測のずれは となる。さらに、この人の介入確率は0.25なので、ずれを4倍して反映する。元の予測差0.10に補正2.80を足した結果が2.90である。
ここでの2.90は、最終的な平均を作るための一人分の計算値であり、視聴確率や本人の因果効果ではない。そのため、1を超えることがある。視聴しなかった介入者なら補正は負になり、対照者では非介入側の予測を補正する。最終的な効果は、それらを全員で平均して求める。
この方法の利点は、二種類のモデルのうち、一方が正しく推定できれば、もう一方の誤りを補える点にある。具体的には、PSモデルが正しい場合、または介入あり・なし両方の結果モデルが正しい場合には、必要な条件のもとで、データを増やすにつれて正しい平均効果に近づく。この性質を二重頑健性という。
ただし、この性質は、観測した情報で交絡を調整でき、比較相手も存在するという前提のもとで成り立つ。また、「結果モデルが正しい」というときには、介入あり・なしの両方が必要である。どちらか一人分の予測が当たればよい、という意味ではない。
補足:二重頑健性が成り立つ理由を式で見る
前の説明の理由を数式でも確認したい場合は、次の式を見るとよい。学習したPSを 、学習した結果モデルを とし、正しい値をそれぞれ とする。学習したモデルを固定して考えると、同じ特徴の人たちにおけるAIPWの平均的なずれは、次のように書ける。
最初の括弧 はPSの誤りである。続く角括弧の中には、結果モデルの誤り と が入っている。つまり、ずれが「PSの誤り×結果モデルの誤り」という積になっている。
PSが正しければ最初の括弧が0なので、積も0になる。一方、結果モデルが両方正しければ角括弧が0となり、やはり積は0になる。これが二重頑健性の理由である。ただし、分母に小さな確率が残るため、比較相手がほとんどいないときの不安定さまで消えるわけではない。
8.2 Cross-fittingとDML:同じ行への過学習を避ける
AIPWで使う予測を複雑なMLで作る場合には、もう一つ注意がある。ある人の結果を学習に使い、同じ人への予測で「予測のずれ」を調べると、学習データに合わせ込みすぎたために、ずれが小さく見えることがある。これでは、予測の誤りを補う計算がうまく働かなくなる。
そこで、各人への予測は、その人の行を学習に使わなかったモデルから求める。これがcross-fittingである。例えば、データをA・B・Cの3つに分ける。Aの人を予測するときはBとCで学習し、Bの人を予測するときはAとCで学習し、Cの人を予測するときはAとBで学習する。
こうすれば、全員について、自分の結果を学習に使っていない予測を得られる。その予測でAIPWの一人分の値を計算し、最後に全員で平均する。
介入確率モデルと、介入あり・なしの結果モデルを作る。
未使用の行でAIPWの寄与を計算する。役割を交代して全行を予測する。
同じ対象集団のATEを推定する。分割ごとに対象を変えない。
このようなデータ分割と、予測の小さな誤りが効果の推定へ直接大きく響きにくい補正式を組み合わせる考え方が、DMLの中心である。後者の性質を直交性と呼ぶ。DMLは単にモデルを二つ学習するという意味ではなく、効果を求める式と、予測を学習するデータの使い方を組み合わせた方法である。Chernozhukovらの原論文
付属の aipw_simulation()
では、データを3分割し、ロジスティック回帰でPSと視聴確率を学習する。視聴あり・なしの架空データを生成しているので、あらかじめ設定した確率差と、AIPWで推定した差を比較できる。
さらに、一人分の計算値を と書くと、そのばらつきから推定値の標準誤差を近似できる。プロフィール同士が独立で、モデルが十分に正確に学習できているなどの条件が成り立つ場合、次の式を使う。
分子のSDは、一人分の計算値がどれくらいばらついているかを表す。それを人数 の平方根で割ることで、その平均である効果の推定値の不確かさを近似する。さらに、推定値から標準誤差の1.96倍を引いた値と足した値を、近似的な95%信頼区間の両端とする。
この近似には、十分な比較相手が存在し、学習したモデルの誤りも十分に小さくなっていることが必要である。特に、PSと結果モデルの誤りの積が、人数の増加とともに十分速く小さくなることが理論上の条件となる。データを分けるだけで、どの予測モデルでも適切な信頼区間を得られるわけではない。
また、同じ人の繰り返しの表示や、同じ家族の複数プロフィールを含む場合、それらの行を独立とは扱えないことがある。その場合は、同じ人やアカウントが学習側と予測側にまたがらないように分割し、標準誤差の計算もその単位に合わせる必要がある。
8.3 Overlap weighting:比較可能な集団を対象にする
LaLondeの例のように、対象者全体の効果を求めようとすると、比較相手がほとんどいない人まで含めなければならないことがある。その場合、「新方針にも従来方針にもなりやすく、比較相手を得やすい人を中心にした平均効果」を考える選択肢がある。これがoverlap weightingである。
この方法では、介入者に 、対照者に の重みを付ける。例えば、PSが0.5なら両群とも重み0.5となる。一方、PSが0.99の人では、多数いる介入者の重みを0.01にし、少数の対照者には0.99を付ける。まれな人を巨大な重みで増やすのではなく、多い側の重みを小さくして合わせるのである。
重みは0から1の間なので、一人に数千の重みが付くことはない。ただし、平均する人の構成は、元の対象者全体とは異なる。比較相手を得やすいタイプほど多く反映した平均効果となり、これをATOと呼ぶ。
この式では、タイプごとの効果に を掛けて平均している。例えば、元の人数が同じなら、PSが0.5のタイプには0.25、PSが0.01のタイプには0.0099が掛かる。したがって、前者の効果がより多く反映される。
Huluでこの方法を使うなら、「全対象者へ展開した場合の効果」ではなく、「両方の方針を比較しやすいプロフィールを中心にした効果」として報告する必要がある。重みが安定する利点と引き換えに、答えている問いが変わるためである。
補足として、PSを切片付き・罰則なしのロジスティック回帰で求め、学習が適切に収束した場合には、モデルに入れた特徴の重み付き平均が両群で一致する性質もある。ただし、平均が一致するのはその特徴についてであり、未観測の違いまでなくなるわけではない。Li・Morgan・Zaslavskyの原論文
8.4 その他の選択肢をどう位置付けるか
PSモデルを作る段階で、重み付け後の両群の特徴を近づけることも考慮する方法として、CBPSがある。通常の割り当て予測だけでモデルを選んでも、調整後の特徴が十分にそろわない場合に検討できる。Imai・Ratkovicの原論文紹介
マッチングにも工夫の余地がある。例えば、デバイスの種類だけは同じにしたうえでPSの近い人を探す方法や、一人ずつ順に相手を決めるのではなく全体でよい組み合わせを探す方法がある。また、比較相手が豊富な人には複数の対照者を使うこともできる。
ただし、方法を複雑にすること自体が目的ではない。どの人を比較に残すか、両群の特徴が近づいたか、推定の不確かさをどう計算するかを一緒に確認する。例えばGBDTでPSの予測を改善できても、未観測交絡や比較相手の欠如が解決するわけではない。
9. Huluのデータで実務に接続する
ここまでの手法をHuluで使うときは、モデルを学習する前のデータ作成が重要になる。何を介入と呼び、どの人を分母に入れ、いつの視聴を結果にするかによって、同じIPWでも求める効果が変わるからである。以下では、新しいアニメ推薦方針の効果を測る例で整理する。
9.1 最初に、対象者と介入の内容、観測期間を決める
まず、新しいアニメ推薦を利用できる条件を満たしたプロフィールを対象にする。この条件を満たす人を、ここでは「適格者」と呼ぶ。例えば、対象となる会員状態やデバイスなどがあるなら、新旧の方針を割り当てる前に条件を決めておく。
次に、その適格者について、新方針を割り当てたかを介入とし、その後7日以内に対象シリーズを視聴したかを結果にする。新方針に割り当てた後でクリックした人だけを集めると、利用意欲の高い人に偏る可能性がある。そのため、方針の効果を測るこの設計では、クリックしなかった人も対象に含める。
割り当て前28日間
視聴日数・視聴時間・アニメ嗜好・介入前の会員状態を固定する。
時点 t0:適格者へ割り当て
プロフィール、方針、確率、時刻、方針バージョンを記録する。
割り当て後7日間
視聴の有無を集計する。開かなかった人も分母に残す。
この設計で分かるのは、新方針へ割り当てることの効果である。実際にトレイを見たことやクリックしたことの効果を知りたい場合は、別の問いとして考える必要がある。例えば、新方針を割り当てたのに画面を開かなかった人を、後から非介入群へ移すと、アプリをよく使う人と使わない人の違いが両群に混ざってしまう。
9.2 カタログから何を作れるか
分析に必要なのは、介入前の特徴、実際の割り当て、介入後の結果の三つである。ローカルの
データカタログ と
docs/domain/bq_data_definitions/
を読むと、それぞれに使えそうな情報を次のように整理できる。ここではカタログ上の定義を確認しており、実際のBigQueryの値や欠損状況まで調べたものではない。
| 情報 | カタログ内の候補 | 因果分析での使い方と注意 |
|---|---|---|
| 視聴イベント | hj-data-01.report.content_viewing |
profile_id, series_id,
watched_seconds, start_date_unixtime_sec
などから前後の窓を作る。イベント粒度と重複を確認する |
| 既視聴シリーズ | hj-data-01.report.unique_viewed_series |
25%以上視聴したシリーズという定義。last_viewing_date
のある履歴を使う際は、未来の更新を混ぜない |
| プロフィールとアカウント | hj-data-01.master.gene_profiles_YYYYMMDD |
id が profile_id
に対応する。account_id を使い依存単位を確認する |
| 介入前の契約状態 | hj-data-01.master.zeus_account_subscriptions_YYYYMMDD |
介入前スナップショットを使う。最新状態には介入後の解約などが混ざり得る |
| 画面・操作イベント | hj-data-01.intermediate.ga4_unnested_cleaned_log |
表示や選択の定義、欠測、IDの整合性を確認する。イベント名だけで割り当てとは見なさない |
| シリーズページ訪問 | hj-data-01.raw_data.import_raw_data_tracking |
カタログの event_type='imp'
はシリーズページ訪問である。推薦トレイの全露出とは異なる |
| 推薦候補出力 | recommend_engine.two_tower_u2i_recommendation_{genre} |
候補出力は、その作品が表示・閲覧された証拠でも、確率的に選択された証拠でもない |
| KPI集計 | personalize.daily_personalize_viewing_kpi など |
期間の定義を合わせる。集計に現れる人だけを分母にすると非利用者が欠ける可能性がある |
これらのテーブルをつなぐ際は、同じ「ユーザID」という名前でも、プロフィールを指すのか、アカウントを指すのかを確認する必要がある。例えば、カタログではGA4の
user_id
はプロフィールIDとされる一方、アカウント関連の説明には表記の揺れもある。IDを取り違えると、視聴を別の単位に結び付けたり、家族のプロフィールを独立したアカウントとして数えたりする可能性がある。
一方、推薦候補のテーブルがあっても、それだけでは「誰に、いつ、どの確率で新方針を割り当てたか」は分からない。候補として計算された作品が、実際に選ばれたかどうかも別の情報である。そのため、次のような割り当てログがあるかを確認したい。以下の列名は、既存の列として確認したものではなく、記録内容の提案である。
| 提案する項目 | 必要な理由 |
|---|---|
decision_id, profile_id,
account_id, assigned_at |
何の意思決定を1行とするか、依存単位、前後関係を確定する |
eligible, policy_version,
assigned_treatment |
分母と比較する施策を確定する |
assignment_probability |
実際のランダム化に使った確率を保存する |
candidate_set, position,
item_id |
作品選択の評価なら、選択可能な行動と表示位置を定義する |
feature_snapshot_at |
特徴量が介入前であることを確認する |
9.3 視聴しなかった人をどう0にするか
視聴率を求めるには、視聴しなかった人も分母に入れる必要がある。ところが、視聴イベントだけから表を作ると、視聴しなかった人には行がないため、最初から分析対象に入らない。
そこで、まず適格者や割り当てログから全対象者の表を作る。次に、各人の割り当て後7日間の視聴を集計し、元の対象者を全員残す左結合で追加する。最後に、視聴がなかった人を0とする。ただし、7日間を最後まで追えていない人や、ログ自体が欠けている人については、視聴がなかったと断定できないため区別する。
Huluの暗黙的フィードバックでは、ここでの0の意味にも注意したい。「新方針を割り当てた後7日間に視聴しなかった」という結果を0と記録しても、その作品を嫌いだと判断したことにはならない。見ていない、気付かなかった、時間がなかった、といった理由もあり得る。施策の結果として視聴の有無を測ることと、推薦モデルに好き嫌いを学習させることを分けて考える必要がある。
また、「視聴した」の基準もそろえる必要がある。
unique_viewed_series
は25%以上視聴したシリーズを記録する定義なので、その基準を結果に使うなら、集計する7日間と記録の時点を合わせる。初めて見た作品への効果を測るなら、介入前に既視聴だったかも調べなければならない。後から更新された最終視聴日だけで判断せず、必要に応じて介入前の保存データや視聴イベントを使う。
9.4 二値の施策効果と推薦方針のオフライン評価
ここまでは、新方針と従来方針の二つに分け、その平均的な効果の差を求めた。一方、推薦の開発では、「いままでの推薦ログを使って、まだ配信していない別の推薦ルールを評価したい」という場面もある。これが推薦方針のオフライン評価である。
例えば、これまでのルールはある作品を10%の確率で選んでいたが、新しいルールでは20%の確率で選ぶとする。その作品が選ばれたときの結果は、新ルールでは2倍多く現れるはずなので、元のログでは重み2を付けて集計する。このように、新旧の選択確率の比を使う方法がIPSである。
式を読むために、 をログを生成した推薦ルール、 を評価したい新ルールとする。また、 は選ばれた作品などの行動、 はその後の視聴などの結果である。新ルールで期待される平均結果を、次のように推定する。
分子の は、その場面で新ルールが観測された作品を選ぶ確率である。分母の は、元のルールが同じ作品を選んだ確率である。先ほどの例なら となり、視聴結果に2を掛けて全体の平均へ加える。
ただし、新ルールが選ぶ作品を、元のルールが一度も選び得なかった場合、その作品を選んだ後の結果をログから調べられない。式でも分母が0になる。したがって、新ルールが選ぶ可能性のある行動については、元のルールにも選ぶ可能性が必要である。これは1.2節の重なりに対応する条件である。
さらに、一度に複数作品を並べる推薦では、一つの作品だけを行動と考えるのか、並び順を含む一覧全体を行動と考えるのかを決める必要がある。隣にどの作品があるかで視聴が変わるなら、単体の選択確率だけで一覧全体を評価できるとは限らない。行動と結果の対応を明確にすることが重要となる。
推薦の学習や評価で、このような選ばれ方の偏りを扱う研究もある。ただし、ユーザが評価を付ける確率、作品が推薦される確率、その作品を視聴する確率はそれぞれ異なる。Huluへ応用するときも、何が観測される確率を重みにしているかを確認する必要がある。Schnabelらの原論文
10. 手を動かして確認する問題
問題1:視聴率は高いが効果は小さい
アニメ好きは非推薦時50%、推薦時55%、ライト層は非推薦時10%、推薦時25%視聴する。全体では半々だが、介入者の80%はアニメ好きである。ATEとATTを求める。
まず、タイプごとの増加分を求めると、アニメ好きは5ポイント、ライト層は15ポイントである。全体では両タイプが半々なので、ATEは 、10ポイントとなる。一方、介入者ではアニメ好きが80%なので、ATTは 、7ポイントとなる。もともと視聴しやすい人を多く選ぶと、推薦による増加分の平均が小さくなることもある。
問題2:誰が巨大な重みを持つか
の介入者と非介入者のATE重みを求める。
介入者の重みは 、非介入者の重みは である。ほとんどの人が介入されない条件なので、まれに介入された人だけが非常に大きな重みを持つ。
問題3:マッチしない人が落ちたら
介入者100人のうち20人は極端なヘビー層で、適切な対照者が見つからず落ちた。残り80人の平均差が5ポイントだったとき、「介入者100人のATTは5ポイント」と言えるか。
この計算から分かるのは、比較に残った80人の平均差である。除かれた20人はヘビー層なので、残った人たちとは推薦の効果が違うかもしれない。そのため、100人全体のATTを5ポイントとするには、除かれた人にも同じ効果を当てはめてよい理由が必要になる。結果を報告するときは、比較から何人が除かれ、どのような特徴だったかも示す。
問題4:完璧に予測できるモデル
介入割り当てをAUC1で予測できた。このPSを使えば最良の因果推定になるか。
AUCだけでは判断できない。例えば、特定の特徴の人に必ず介入するルールなら、割り当ては正確に予測できても、その特徴を持つ対照者がいない。また、学習したデータに過剰に合わせたために、よく当たって見える場合もある。そのため、実際の割り当てルールと、調整後の比較相手の有無を併せて確認する必要がある。
11. Python実行記録
ここでは、付属Pythonを実行した結果をまとめる。各表の「推定値」は、今回のデータから求めた一つの値であり、確定した真の効果ではない。まず、単純な平均差が調整によってどう変わったかを見よう。そのうえで、ATEとATTの違いや、重みと特徴のバランスの確認結果を読むと、値が変わった理由を考えやすい。
11.1 メール:バイアスを作った標本
5節の方法で偏りを作った後のデータには31,925人おり、そのうち17,150人がメール受信者である。マッチングでは、各受信者に対して比較相手を選び、17,150組を作った。同じ対照者を繰り返し使っているので、17,150人の異なる対照者がいるという意味ではない。
| 推定 | 今回の値(ドル/人) |
|---|---|
| 元のRCTの平均差 | 0.7698 |
| 抽出後の単純差 | 0.9537 |
| PSM、ATTを狙う | 1.1013 |
| IPW、ATEを狙う | 0.8227 |
| IPW、ATTを狙う | 0.8444 |
単純差は、元のRCTの約0.77ドルから、抽出後には約0.95ドルへ大きくなった。その後、ATE-IPWでは約0.82ドルとなり、この実行では元のRCTの値に近づいている。
特徴の平均も確認すると、ATE-IPW後の絶対SMDは、 recency
が0.0163、 history が0.0418、 channel=Phone
が0.0088、 channel=Web
が0.0086となった。これらの特徴の平均は近づいたと分かるが、未観測の違いまで確認できたわけではない。
一方、PSMの約1.10ドルは、元のRCT差からさらに離れている。同じ対照者の再利用や同点の相手の選び方でも結果が変わり、推定対象もATTである。そのため、この表だけで原因を一つに決めることはできないが、マッチングを行えば必ず実験の値に近づくわけではないことが分かる。
11.2 ML方針の疑似ログ
6節では、購入しそうな人ほど配信しやすくしつつ、配信確率を0.05〜0.95の範囲に収めた。この仮想方針の割り当てと元のRCT割り当てが一致した10,588人を使って、次の値を得た。
| 推定 | 今回の値(ドル/人) |
|---|---|
| 未来側に見立てたRCTの平均差 | 0.7516 |
| 方針ログの単純差 | 1.0463 |
| 復元PSM、ATTを狙う | 1.3600 |
| 既知PSによるIPW、ATEを狙う | 0.7533 |
この実行では、単純差は約1.05ドルまで大きく見えたが、配信確率を使ったATE-IPWでは約0.75ドルとなり、元のRCT差に近づいた。一方、PSMの値は約1.36ドルである。PSMは実際の介入者について平均するため、全体の平均とは対象が違う。ただし、その違いに加えて、有限のデータによるばらつきなどもあるので、値の差のすべてを「人によって効果が違うため」と断定はできない。
11.3 NSWとCPS
| データ | 全人数 | 介入人数 | 単純差 | 共変量付きOLS |
|---|---|---|---|---|
| NSW | 445 | 185 | 1,794.34 | 1,676.34 |
| NSW + CPS1 | 16,177 | 185 | −8,497.52 | 699.13 |
| NSW + CPS3 | 614 | 185 | −635.03 | 1,548.24 |
金額は、1978年の所得についての一人当たりの差である。NSWでは単純差も回帰の値も正だが、CPS1の対照者に置き換えると、単純差は約−8,498ドルになる。もともと所得の高い人が対照群に多いためである。回帰で調整すると約699ドルになったが、NSWの回帰の約1,676ドルとはまだ離れている。
これらの回帰の値は、教科書の掲載値と丸めの範囲で一致した。次に、所得の2乗も含めてPSを学習し、マッチングや重み付けを行った結果を見る。
| データ | 復元なしPSM | IPW・ATE | IPW・ATT | Overlap・ATO |
|---|---|---|---|---|
| NSW + CPS1 | 1,877.19 | −7,626.82 | 1,245.10 | 1,033.27 |
| NSW + CPS3 | 715.27 | −290.68 | 1,240.54 | 922.55 |
どちらのPSMでも、介入者185人全員に比較相手を選んだ。CPS1での約1,877ドルは教科書の約1,830ドルに近いが、一致はしていない。付属コードは、同じ距離の相手が複数いる場合に行番号で一人を選ぶ。PSのごく小さな数値差や、この相手の選び方によって、組み合わせと平均差が変わることがある。
CPS3のPSMは、本ノートで追加した比較である。CPS3を使えば、どの推定方法でも回帰の約1,548ドルに近づく、というわけではない。また、表の各列はATE・ATT・ATOという異なる平均を求めているため、値の大小だけで方法を選ばないようにする。
| ATE-IPWの診断 | CPS1 | CPS3 |
|---|---|---|
| 介入群のESS | 10.26 | 48.83 |
| 対照群のESS | 15,906.65 | 326.22 |
| 最大重み | 2,144.13 | 54.24 |
CPS1のATE-IPWでは、介入者185人に対してESSが約10.26であり、最大重みは約2,144となった。つまり、一部の介入者が極めて大きく数えられている。さらに、調整後にも過去所得
re74 の絶対SMDは約1.004、 re75
は約0.963残っている。過去所得の平均がまだ大きく違うので、この−7,626.82ドルを適切に比較した訓練効果として報告することは難しい。
一方、PSMでは多くの特徴のSMDが0.1未満となった。ただし、学位の有無を示す
nodegree
は約0.154であり、すべての特徴が十分にそろったわけではない。実験に近い効果の値が得られても、こうした比較条件の確認は必要である。
11.4 Cross-fitting AIPWの二値視聴シミュレーション
最後に、8節のAIPWを架空の視聴データで実行した結果を見る。ここでは12,000人を生成し、乱数の開始状態を決めるseedを42に固定した。そのデータを3つに分け、自分自身を学習に使わない予測から効果を計算した。
| 数量 | 視聴率差(パーセントポイント) |
|---|---|
| データ生成時に設定した各人の視聴確率差の平均 | 8.6313 |
| 観測された単純差 | 16.9386 |
| IPW | 6.6322 |
| AIPW | 6.5752 |
| AIPWの漸近標準誤差 | 0.8230 |
| AIPWの近似95%信頼区間 | [4.9622, 8.1882] |
今回生成した人たちについて、新方針と従来方針の視聴確率差を平均すると、約8.63ポイントである。一方、実際に0/1として生成した視聴結果から求めたAIPWは約6.58ポイントとなり、その区間も8.63ポイントを含んでいない。
モデルの形が正しくても、誰が介入されるか、誰が実際に視聴するかには偶然のばらつきがある。そのため、一度のデータで推定値が正しい値から離れることはある。95%信頼区間も、毎回必ず正しい値を含むという意味ではない。
なお、8.63ポイントは、今回生成した12,000人の特徴に対して計算した平均である。無限に多くの人を同じ仕組みで生成したときの平均を、厳密に求めた値ではない。一方、ここで使った標準誤差は、そのような元の集団のATEを対象にした近似である。
したがって、区間がどれくらい正しい値を含むかを評価するには、何を正解とするかをそろえ、データ生成から多数回繰り返す必要がある。この一回の結果だけでは、AIPWとIPWのどちらが常に正確かを判断することはできない。