第2章 介入効果を測るための回帰分析:Huluの推薦ログから効果を取り出す
本ノートは『効果検証入門』第2章の2.1〜2.4を解説するものである。教科書ではクーポンメールの施策と、コロンビアの学費割引券(PACES)の分析を例にしているが、本ノートではそれに加えて、Huluの「推薦施策によって視聴がどれだけ増えたか」という問題に置き換えて考える。数式の前提、手計算できる小さな例、Python(Polars + NumPy)による分析までを一つにまとめている。Huluの数値例はすべて説明のために作った架空のデータであり、実際の施策の成果を表すものではない。
第1章では、比較の妥当性を「介入をランダムに割り当てる」ことで実験の段階から確保した。しかし現実には、RCTが行われないままデータだけが残っていることが多い。第2章のテーマは、 すでに偏ってしまったデータから、回帰分析によって介入の効果をできるだけ正しく取り出すこと である。同時に、回帰分析がどこまでできて、どこからできないのかを見極めることも学ぶ。
この章の出発点:RCTをしなかった施策の効果を、あとから知りたい
Huluの推薦開発では、次のような状況がよく起きる。たとえば『名探偵コナン』の新シーズンの配信開始に合わせて、「過去90日間にアニメを視聴したプロフィール」に対してホーム上段のトレイで作品を大きく訴求したとする。この施策はA/Bテストではなく、ルールに基づいて対象者を決めて全員に適用した。数週間後、「訴求を受けた人のコナン視聴率は45%、受けなかった人は10%だった」という集計が出てくる。では、この35ポイントの差は施策の効果と言えるだろうか。
言えない、というのが第1章の結論であった。訴求を受けた人は、もともとアニメをよく見る人であり、訴求がなくてもコナンを見ていた可能性が高い。つまり、観測された差には「施策の効果」と「もともとの視聴傾向の差(セレクションバイアス)」が混ざっている。
では、混ざってしまった二つをどう分ければよいのか。素朴に考えれば、「もともとの視聴傾向」が同じ人同士で比べればよい。アニメ好き同士、アニメ好きでない人同士で比べれば、視聴傾向の差は消えて、施策の効果だけが残るはずである。第2章の回帰分析は、この 「同じ条件の人同士で比べる」という素朴な発想を、条件が多くても実行できる形にしたもの である。なぜそれが回帰という形になるのかは、2.1の冒頭で丁寧に追う。この章では次の順序で問題を解いていく。
| 分析の途中で生じる疑問 | 導入する考え方 | それによって分かること |
|---|---|---|
| 同じ条件の人同士で比べたいが、条件が多すぎて比べられない | 層別比較から回帰へ | 回帰分析が効果検証に登場する理由 |
| 「線を引く」操作が、なぜ効果の推定になるのか | 条件付き期待値としての回帰 | 回帰係数が平均の差を表す理由 |
| どの変数をモデルに入れれば偏りが減るのか | 脱落変数バイアス(OVB) | 入れるべき変数の条件と、入れ忘れの影響の大きさ |
| 回帰の結果を「効果」と呼ぶには何を仮定しているのか | CIA(条件付き独立の仮定) | 分析の正当性の根拠と、その限界 |
| 効果と関係する変数なら何でも入れてよいのか | Post treatment bias | 介入の後に決まる変数を入れてはいけない理由 |
| 一つの介入が、どのような経路で効果を生んだのか | 複数のアウトカムへの回帰 | 介入の「しくみ」を探索的に理解する手順 |
| 回帰の係数は、結局どの人たちの効果を表しているのか | 分散による重み付け | RCTと回帰の結果がずれる理由 |
数式が出てきたら、「この式はどの疑問に答えようとしているのか」を確認しながら読むと理解しやすい。
2.1 回帰分析の導入
なぜ回帰分析なのか:「同じ条件の人同士で比べる」を式にする
教科書は、この節をいきなり「点の集まりに線を引く」という単回帰の説明から始める。しかし、効果検証の文脈で回帰分析が出てくる理由は、その説明の中には書かれていない。そこで本ノートでは、第1章の結論から回帰分析に到達するまでの道筋を先に確認しておく。ここを押さえておくと、以降の数式がすべて「同じ条件の人同士で比べる」という一つの目的に向かっていることが見えるようになる。
第1歩:バイアスの原因が分かっているなら、それを揃えて比べればよい
第1章で見た通り、RCTでないデータの単純な平均の差には、効果とセレクションバイアスが混ざっている。
セレクションバイアスは、「介入を受けた人と受けなかった人で、もともとの傾向が違う」ことから生まれる。そして多くの場合、その違いを生んでいる変数には見当がつく。上のHuluの例なら、訴求対象を決めるときに使った「アニメを視聴していたか」がそれである。
原因が分かっているなら、対処は素朴でよい。 その変数の値が同じ人同士で比べればよい 。アニメ視聴者の中だけで訴求あり・なしを比べ、非視聴者の中だけで訴求あり・なしを比べれば、「訴求群にアニメ視聴者が多い」という偏りは比較の中から消える。この方法を 層別比較 と呼ぶ。
小さな例で確かめる。8人のプロフィールについて、 をアニメ視聴者か、 を『名探偵コナン』を訴求したか、 を7日間のコナン視聴分数とする(この表は2.2.2でも再び使う)。
| 人 | (アニメ視聴者) | (訴求) | (分) |
|---|---|---|---|
| p1 | 1 | 1 | 80 |
| p2 | 1 | 1 | 80 |
| p3 | 1 | 1 | 80 |
| p4 | 1 | 0 | 60 |
| p5 | 0 | 1 | 40 |
| p6 | 0 | 0 | 20 |
| p7 | 0 | 0 | 20 |
| p8 | 0 | 0 | 20 |
全員をまぜて比べると、訴求あり4人の平均は70分、なし4人の平均は30分で、差は40分である。一方、層ごとに比べると次になる。
| 層 | 訴求あり平均 | 訴求なし平均 | 層内の差 |
|---|---|---|---|
| アニメ視聴者( ) | 80 | 60 | 20 |
| 非視聴者( ) | 40 | 20 | 20 |
| 全員をまぜた単純比較 | 70 | 30 | 40 |
層ごとに比べると、どちらの層でも差は20分である。単純比較の40分のうち20分は、訴求群にアニメ視聴者が多かったことによる見せかけの差であった。 同じ条件の人同士で比べることで、セレクションバイアスが消えた 。これが、この章全体でやりたいことの原型である。
第2歩:層別比較は、揃えたい条件が増えるとすぐに破綻する
ところが、現実には揃えたい条件は一つではない。訴求対象を決めるルールが「過去90日のアニメ視聴日数が3日以上、かつ契約1か月以上、かつキッズプロフィールでない」だったとしよう。すると、揃えるべき変数は「アニメ視聴日数(0〜90日の整数)」「契約月数」「キッズか」の三つになる。さらに、視聴傾向に関係しそうな「総視聴時間」や「利用デバイス」も揃えたくなる。
条件を厳密に揃えるということは、「視聴日数37日、契約14か月、キッズでない、総視聴時間12.3時間、iOS」のような細かい層を作り、その中で訴求あり・なしを比べることである。しかし、そのような層には人がほとんどいない。訴求ありとなしの両方がそろっている層はさらに少なく、多くの層では差そのものが計算できない。変数が連続値であれば、値がぴったり一致する人はそもそも存在しない。
つまり層別比較は、考え方は正しいが、 条件の組み合わせが増えると、比較に使えるデータが枯渇して実行できなくなる 。
第3歩:層ごとの平均に「形」を仮定すると、人がいない層でも比べられる
行き詰まりを抜ける発想は、層ごとにバラバラに平均を計算するのをやめて、 「条件 と介入 が与えられたときの の平均」に、簡単な式の形を仮定する ことである。
は「 と がこの値の人たちの の平均」であり、層別比較で計算していた「層ごとの平均」そのものである。この式は、その層ごとの平均が次の二つの規則に従うと仮定している。
- が1増えると、 の平均は だけ増える( の影響は直線的である)。
- が0から1になると、 の平均は だけ増える(介入の効果はどの層でも同じである)。
この仮定が、なぜ「人がいない層でも比べられる」ことにつながるのか。層別比較と回帰で、データから決めなければならない数の個数を比べると分かる。
層別比較では、「層の数 × 2」個の平均を、それぞれ別々に求める必要がある。たとえば が0から3までの4通りなら、 の訴求なし平均、 の訴求あり平均、 の訴求なし平均、というように8個の平均を求め、各層でその差を取る。8個の平均はお互いに無関係に計算されるので、8個のマスすべてに人がいなければならない。一つでも空のマスがあれば、その層の差は計算できない。
一方、回帰では、決めなければならない数は の3個だけである。しかも、この3個は8個のマスに散らばった全員のデータを一緒に使って決める。 は「 が1増えると の平均がいくら増えるか」という規則なので、どの層の人からも情報を得られる。 は「訴求で の平均がいくら増えるか」なので、訴求あり・なしの両方がいる層がどこか一つでもあれば決まる。3個の数が決まれば、式に と を代入することで、 人がいないマスの平均も計算できる 。これが「隣の層の情報から式で補える」という意味である。
ワークド例:空のマスを式で埋める
を「過去90日のアニメ視聴日数」(0〜3日)とし、8人のデータを次のように持っているとする。話を単純にするため、誤差のないデータとする。
| 人 | (視聴日数) | (訴求) | (分) |
|---|---|---|---|
| q1 | 0 | 0 | 20 |
| q2 | 0 | 0 | 20 |
| q3 | 1 | 0 | 30 |
| q4 | 1 | 1 | 50 |
| q5 | 2 | 0 | 40 |
| q6 | 2 | 1 | 60 |
| q7 | 3 | 1 | 70 |
| q8 | 3 | 1 | 70 |
これを層別比較の表に並べ替えると、空のマスが二つある。視聴日数0日の人は誰も訴求されておらず、3日の人は全員が訴求されている。訴求ルールが「視聴日数が多い人ほど訴求する」というものであれば、このように両端の層が片側だけになるのは自然なことである。
| 層 | 訴求なし平均 | 訴求あり平均 | 層内の差 |
|---|---|---|---|
| 20 | (人がいない) | 計算できない | |
| 30 | 50 | 20 | |
| 40 | 60 | 20 | |
| (人がいない) | 70 | 計算できない |
層別比較では、 と の層からしか差が得られない。 と の4人は、比較に使えずに捨てることになる。
回帰では、8人全員を使って3個の数を決める。この表のデータは
にぴったり乗っているので、最小2乗法は
、 、
を返す(2.1.1で最小2乗法の計算を確認したあと、2.1.5の ols()
にこの表を入れれば確かめられる)。
- は、訴求なしの列が で20、30、40と10ずつ増え、訴求ありの列が で50、60、70と10ずつ増えていることから決まる。 どちらの列も「1日あたり10分」という同じ規則に従う という仮定があるから、二つの列の情報を合わせて一つの を決められる。
- は、両群がいる と の層内の差20から決まる。
3個の数が決まれば、空のマスを式で埋められる。 の訴求なしの平均は 、 の訴求ありの平均は と計算できる。
| 層 | 訴求なし平均 | 訴求あり平均 | 層内の差 |
|---|---|---|---|
| 20 | 40 (式で補った) | 20 | |
| 30 | 50 | 20 | |
| 40 | 60 | 20 | |
| 50 (式で補った) | 70 | 20 |
「 の訴求なし平均は50」という数は、 の訴求なしの人を一人も観測していないのに得られている。 の訴求なしの人たちが示す「1日あたり10分」という傾きを、 まで延長したからである。これが「隣の層の情報から補う」ということの正確な意味である。
式で補う
式で補う
同じことを、横軸に 、縦軸に を取った散布図で見ると、回帰が何をしているかがはっきりする。訴求なしの人たちと訴求ありの人たちに、同じ傾きの直線を1本ずつ引き、人がいない の位置まで直線を延長しているのである。
この例では の値が4通りしかないので、層別比較でもなんとか差が求まった。しかし共変量が「視聴日数(0〜90)」「総視聴時間」「契約月数」の三つになると、マスの数は数万個に膨れ上がり、ほとんどのマスは空になる。それでも回帰で決めるべき数は と各共変量の係数と の5個だけであり、5個を決めるのに必要なのは「全体として十分な人数」であって「すべてのマスに人がいること」ではない。 これが、条件が多くても比較を続けられる理由である 。
ただし、この「補う」操作は仮定に依存していることも忘れてはいけない。上の例で の訴求なし平均を50と置けたのは、「1日あたり10分という増え方が でも続く」と仮定したからである。もし実際には視聴日数3日の人の視聴分数が頭打ちになっていて45分だったなら、補った値はずれ、 にもずれが入る。だからこそ2.1.2では「共変量の関数の形は分析者が決めなければならない」という話が出てくる。また、層ごとの差が本当に同じかどうかは、2.4.5で改めて問い直す。
そして、この式のもとで「 が同じ人の中での、訴求ありとなしの平均の差」を計算すると、 に関する項は打ち消し合う。
つまり は、 層別比較で求めていた「同じ条件の人同士の差」を、すべての層についてまとめて一つの数で表したもの である。8人の例にこの式を当てると が得られ、層別比較の答えと一致する(計算は2.2.2で確認する)。層ごとの差が同じでない場合に が何を表すかは、2.4.5で扱う。
層別比較
条件の組み合わせごとに層を作り、層の中で介入あり・なしの平均を比べる。
層ごとに独立に平均を出すので、各層に両群の人が必要。
条件が3つ、4つと増えると、人のいない層ばかりになり計算できない。
回帰分析
層ごとの平均に β0 + β1 X + βZ Z という形を仮定する。
人のいない層の平均も、式を通じて隣の層から補える。
「同じ X の中での Z=1 と Z=0 の差」は βZ に集約される。
この節の残りで確認すること
ここまでで、回帰分析が効果検証に登場する理由は説明できた。ただし、この議論は「 に式の形を仮定すれば、そのパラメータを推定できる」という点に依存している。では、その式のパラメータは、手元のデータからどうやって求めるのか。そして、求めた値はなぜ「条件付き期待値」の推定と言えるのか。この二つを確認するのが、教科書が最初に置いている単回帰の説明である。したがって、以下の2.1.1は「線の引き方の説明」ではなく、 「回帰で引いた線は条件付き期待値の推定である」ことを確立するための準備 として読むとよい。それが確立できれば、2.1.3で「条件付き期待値の差 」という結論に、そのままつながる。
2.1.1 単回帰分析:点の集まりに線を引く
回帰分析が「条件付き期待値の推定」であることを確認するために、もっとも単純な 単回帰分析 から始める。目的変数を 、入力となる変数を とする。単回帰分析は、 が1単位増えたときに が平均的にどれだけ変わるかを出力する。図2.1は、そのイメージである。それぞれの点が一人のデータであり、点の集まりに対して「近似的な線」を引く操作が回帰分析である。
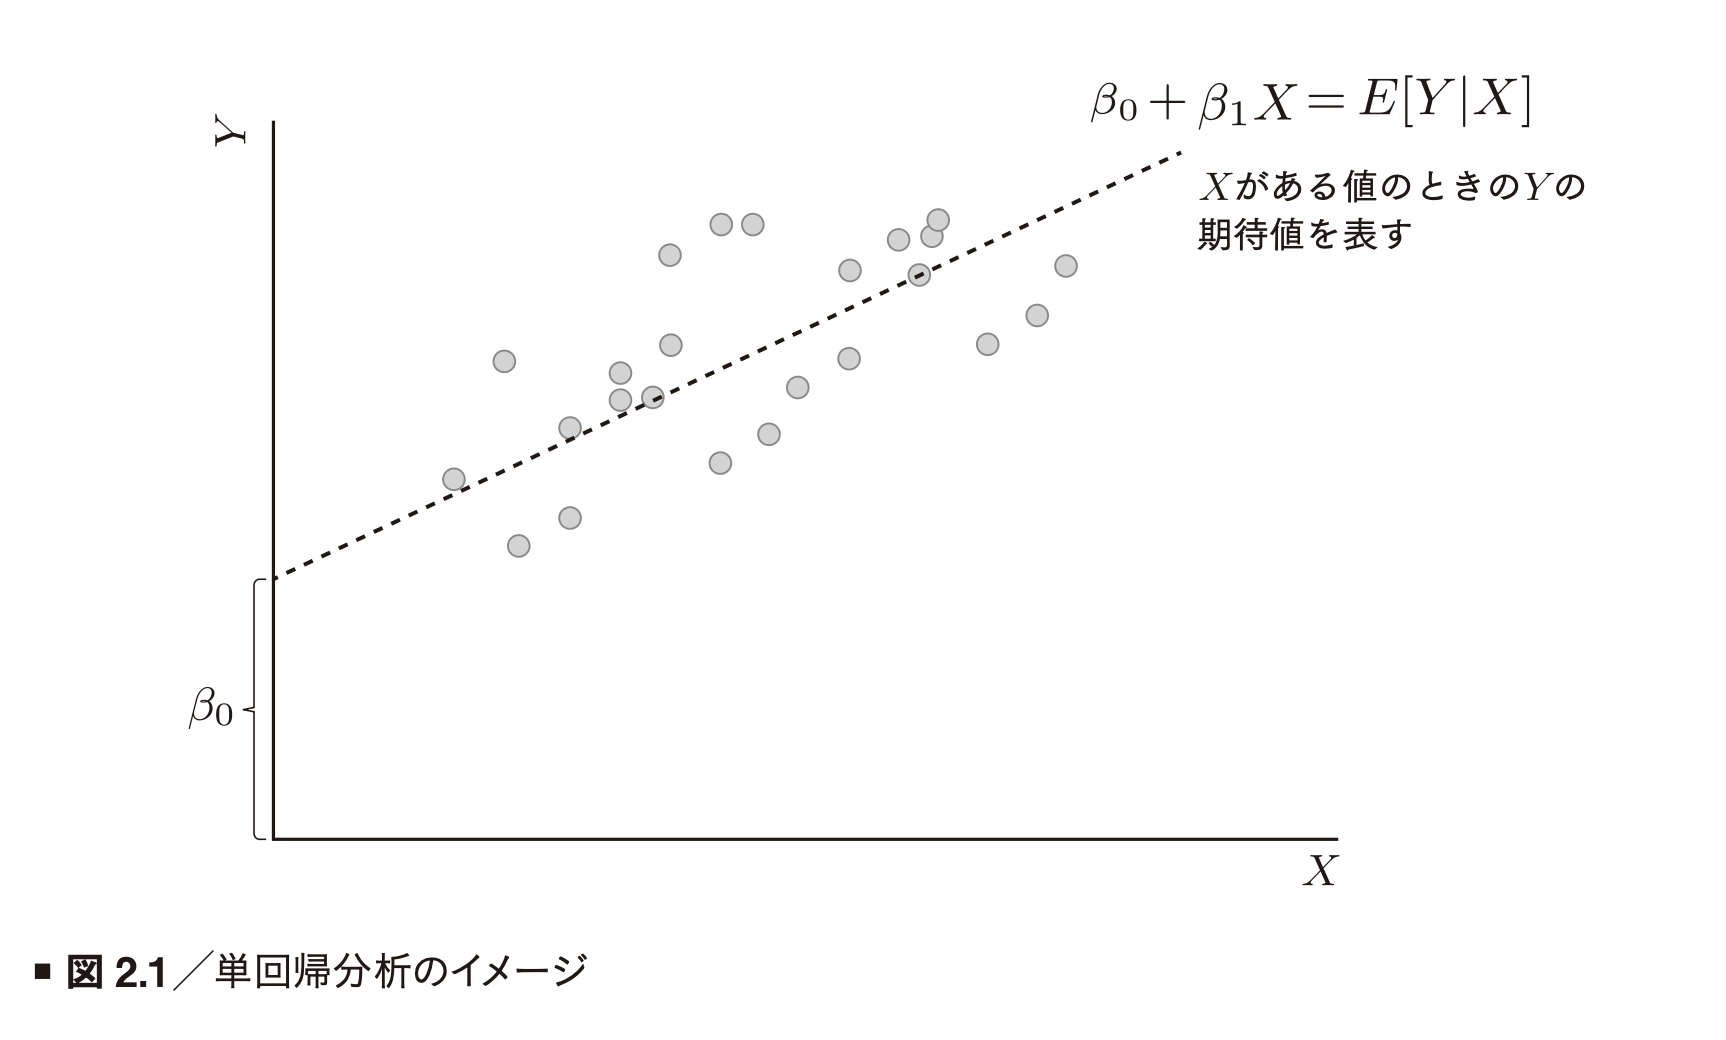
この線は、次の式で表される。
記号の意味を一つずつ確認する。
- は 切片 であり、 のときの の値を表す。
- は 傾き であり、 が1増えたときに の期待値がどれだけ増えるかを表す。
- は 誤差 であり、点と線とのずれを表す。
は「本当の値」を持つパラメータであるが、私たちには分からない。そこで手元のデータから推定した値を と書く。「誤差がもっとも小さくなるように線を引く」とは、誤差 を2乗して足し合わせた値が最小になるように を選ぶことである。
この推定方法を 最小2乗法(Ordinary Least Squares、OLS) と呼ぶ。なぜ2乗するかというと、正負のずれを同じように扱いたいからであり、加えて微分によって解が閉じた形で求まるからである。
ワークド例:4人のデータから傾きと切片を手計算する
抽象的な式を、手を動かして確かめる。Huluのあるプロフィール4人について、 を「過去4週間の視聴日数」、 を「今週の総視聴分数」とする。
| 人 | (日) | (分) | ずれの積 | |||
|---|---|---|---|---|---|---|
| A | 2 | 30 | -3 | -30 | 90 | 9 |
| B | 4 | 50 | -1 | -10 | 10 | 1 |
| C | 6 | 60 | 1 | 0 | 0 | 1 |
| D | 8 | 100 | 3 | 40 | 120 | 9 |
| 合計 | 20 | 240 | 0 | 0 | 220 | 20 |
平均は 、 である。単回帰の傾きは「 と の共分散を の分散で割ったもの」であり、分母と分子の は打ち消し合うので、ずれの積の合計をずれの2乗の合計で割ればよい。
切片は、線が点 を必ず通ることから求まる。
したがって、推定された線は である。「過去の視聴日数が1日多いと、今週の視聴分数は平均して11分多い」と読める。予測値と誤差を確かめると、Aは で誤差は 、Bは で 、Cは で 、Dは で となり、誤差の合計は0になる。これは最小2乗法の解が必ず満たす性質である。
この計算を図にすると次のようになる。4つの点に対して、赤い縦線(残差)の2乗の合計がもっとも小さくなる位置に直線が置かれている。
回帰は「近似の線」であるだけでなく「条件付き期待値」の推定である
ここが2.1.1の難所である。回帰分析は、手元のデータに線を当てるだけの操作ではない。手元のデータで得た は、 母集団で回帰を行ったときに得られるパラメータ の推定値 である。そして母集団では、 と の関係を次のように書くことができる。
は「 がある値のときの の平均」であり、 条件付き期待値 と呼ぶ。この式が言っているのは、次の二つのことである。
- どんな も、「 で決まる平均の部分」と「そこからのずれ 」に分解できる。
- 条件付き期待値 は、 を予測する関数の中で、2乗誤差がもっとも小さくなる関数である。
したがって、最小2乗法で線を引くという操作は、条件付き期待値 を線形の形で近似する操作に一致する。上のワークド例で言えば、「 」は「過去の視聴日数が 日の人たちの、今週の平均視聴分数はおよそ 分である」という条件付き期待値の推定である。この見方が、次節で回帰係数を「効果」として解釈するための土台になる。
2.1.2 効果分析のための回帰分析:三種類の変数
第1章で見た通り、介入の効果は「介入した場合の結果の期待値」と「しなかった場合の結果の期待値」の差 で表される。効果分析のための回帰分析では、データに含まれるセレクションバイアスの影響をできるだけ減らしながら、この差を推定する。
登場する変数は三種類である。
効果を確認したい結果。メールの例では購買額。
Hulu:7日以内に『名探偵コナン』を視聴したか(0/1)。
施策の有無。メールを配信したか(0/1)。
Hulu:上段トレイで作品を訴求したか(0/1)。
セレクションバイアスを生むと分析者が考える変数。昨年の購買額、最終購買からの日数など。
Hulu:過去90日のアニメ視聴日数、総視聴時間、契約月数など。
- 被説明変数 は、介入の効果を確認したい変数である。
- 介入変数 は、施策の有無を表す0/1の変数である。
- 共変量 は、セレクションバイアスを発生させていると分析者が想定する変数である。介入の有無によって分布が異なると考えられる変数、つまり「メールを送る人を選ぶときに考慮した変数」がこれに当たる。共変量は通常、複数ある。
統計学では共変量と介入変数のように を説明する変数をまとめて 説明変数 と呼び、機械学習では 特徴量 と呼ぶ。名前は違うが同じものである。
共変量が複数あり、さらに介入変数 を含めた回帰を 重回帰分析 と呼ぶ。もっとも簡単な形は次の通りである。
単回帰と同じく、 は条件付き期待値と誤差に分解できる。
このとき誤差 は を満たし、 とも とも相関しない。誤差は「モデルで説明できなかった残り」なので、定義上そうなる。パラメータは、単回帰と同じく2乗誤差の最小化で求める。
サンプルサイズが大きくなるほど推定値は母集団の値に近づき、無限大の極限で一致する(一致性)。
共変量の「関数の形」は分析者が決める
重回帰では、 の2乗のような変数を追加できる。
なぜこのようなことが必要になるのか。たとえば、教育方法の年収への効果を推定するときに、共変量として年齢を入れる場合を考える。年収は経験や年齢によって変わるが、その関係は直線ではない。年齢が上がるほど1年分の経験が年収に与える影響は小さくなるとすれば、その関係は2次関数で表される。このような場合、 だけでなく も加える必要がある。
Huluでも同じことが起きる。「過去の総視聴時間」と「今週の視聴確率」の関係は直線ではなく、視聴時間が長い人ほど伸びが鈍る(天井に近づく)ことが多い。したがって、視聴時間をそのまま入れるのではなく、対数を取る、2乗項を入れる、あるいは区分(0時間、1〜5時間、5時間以上など)のダミー変数にするといった工夫が必要になる。どの形が適切かは、データを眺めたうえで分析者が事前知識から決める。
一方で、 介入変数 は0か1しか取らないため、関数の形を考える必要がなく、常に線形のまま扱えばよい 。0と1の2点を通る関係は必ず直線で表せるからである。この点は2.4.2でもう一度出てくる。
2.1.3 回帰分析による効果の推定:差を取ると だけが残る
介入効果の分析で興味があるのは、共変量が同じ人たちの中での、介入した場合としなかった場合の期待値の差 である。ここでは介入変数の係数を、読みやすさのために と書く(教科書では )。回帰で条件付き期待値を近似すると、介入ありとなしの期待値はそれぞれ次になる。
二つの差を取ると、共変量に関する項はすべて打ち消し合う。
つまり、 回帰分析において介入の効果を表すのは だけ である。共変量の係数は、差を取る過程で消えてしまう。これは、2.1の冒頭で見た層別比較の「同じ条件の人同士の差」を、式の上で取り出したことに対応する。共変量が何個あっても、また2乗項のような形を含んでいても、差を取れば の項だけが残るので、層別比較では扱えなかった多数の条件を一度に揃えたうえでの差が、 という一つの数として得られる。
ワークド例:具体的な数値で差を確認する
教科書の数値をそのまま使う。手元のデータで回帰を行い、 、 、 、 が得られたとする。共変量が の人について計算すると、次になる。
差は である。次に の人では、 と で、やはり差は になる。共変量の値がいくらであっても、介入ありとなしの差は で一定である。これが「介入グループでは の平均が非介入グループより0.4高い」という解釈の意味である。
を横軸に取って二つの条件付き期待値を描くと、共変量との関係が曲線であっても、介入ありの曲線は介入なしの曲線を縦にちょうど だけ持ち上げたものになっていることが分かる。
なお、この「差が に依存しない」という性質は、モデルに と の交互作用項を入れていないことの結果である。効果が人によって違う場合の扱いは、2.4.5と追加手法の節で扱う。
2.1.4 回帰分析における有意差検定
は手元のデータから得た推定値であり、データを取り直せば少し違う値になる。そこで第1章と同じく、「母集団の は実は0である」という帰無仮説を検定する。
回帰分析のソフトウェアは、各パラメータの推定値と一緒に 標準誤差(standard error) を出力する。標準誤差は「推定値が偶然によってどれくらい揺れるか」の目安である。推定値を標準誤差で割ったものが t値 であり、帰無仮説のもとでt値がこれほど極端になる確率が p値 である。介入変数の行のt値とp値を見れば、「効果が本当は0である」という可能性を評価できる。解釈は第1章と同じであり、p値が小さいことは「効果が大きい」ことを意味しないし、p値が大きいことは「効果がない」ことの証明にもならない。
第1章の2群の平均差の検定と、 を だけに回帰したときの の検定は、実は同じものである。単回帰の は介入群と対照群の平均の差にちょうど一致し、等分散を仮定したt検定と同じ標準誤差が得られる。回帰分析は、この平均差の比較を「共変量を揃えながら行う」ように一般化したものだと理解すればよい。
2.1.5 Pythonによるメールマーケティングデータの分析(回帰編)
教科書ではRの lm() と broom::tidy()
を使う。本ノートではPolarsで表を加工し、最小2乗法をNumPyで自分で書く。ライブラリに任せずに書くのは、次節以降で「係数がどう計算されているか」を確かめる材料にするためである。実行用ファイルはローカルの
output/ch2_examples.py
にまとめており、リポジトリのルートで次を実行する。
uv run --with numpy==2.5.2 --with polars==1.44.1 --with scipy==1.18.1 python output/ch2_examples.pyメールデータは第1章と同じ data/hillstrom.csv
を使い、なければ公開元から取得する。PACESの割引券データは
data/vouchers.csv
を使い、初回だけGitHubから取得して変換する(この変換にのみ
--with pyreadr が必要になる)。
本ノートの数値グラフは output/ch2_plots.py
が生成する。このスクリプトは ch2_examples.py
の結果をそのまま読み込んで描くので、本文の数値と図の数値は同じ計算から出ている。uv run output/ch2_plots.py
で figs/plotly/ch2_*.html が作り直される。
最小2乗法を自分で書く
計画行列(説明変数を横に並べた行列)を 、目的変数のベクトルを とすると、最小2乗法の解は次の閉じた式で求まる。
標準誤差は、誤差の分散の推定値 (RSSは残差の2乗和、 はパラメータ数)を使って、次の行列の対角成分の平方根として得られる。
これはRの lm()
の既定と同じ計算であり、誤差の分散がどの人でも同じ(等分散)という仮定に基づいている。この仮定が怪しいときの対処は追加手法の節で述べる。
from dataclasses import dataclass
import numpy as np
import polars as pl
from scipy import stats

@dataclass
class OLSResult:
    terms: list[str]
    coef: np.ndarray
    se: np.ndarray
    residuals: np.ndarray
    n: int
    k: int

    @property
    def tidy(self) -> pl.DataFrame:
        # R の broom::tidy() に相当する表を返す
        dof = self.n - self.k
        t_value = np.where(self.se > 0, self.coef / self.se, np.inf)
        p_value = 2 * stats.t.sf(np.abs(t_value), df=dof)
        return pl.DataFrame({
            "term": self.terms, "estimate": self.coef, "std_error": self.se,
            "statistic": t_value, "p_value": p_value,
        })

    def coef_of(self, term: str) -> float:
        return float(self.coef[self.terms.index(term)])


def design_matrix(frame: pl.DataFrame, columns: list[str]) -> tuple[np.ndarray, list[str]]:
    """切片つきの計画行列を作る。文字列列は最初の水準を基準にしたダミー変数へ展開する。"""
    parts = [np.ones((frame.height, 1))]
    names = ["(Intercept)"]
    for col in columns:
        series = frame.get_column(col)
        if series.dtype == pl.String:
            levels = sorted(series.unique().to_list())
            for level in levels[1:]:
                parts.append((series == level).cast(pl.Float64).to_numpy().reshape(-1, 1))
                names.append(f"{col}{level}")
        else:
            parts.append(series.cast(pl.Float64).to_numpy().reshape(-1, 1))
            names.append(col)
    return np.hstack(parts), names


def ols(frame: pl.DataFrame, outcome: str, predictors: list[str]) -> OLSResult:
    used = frame.select([outcome, *predictors]).drop_nulls()   # R の na.omit と同じ
    x, names = design_matrix(used, predictors)
    y = used.get_column(outcome).cast(pl.Float64).to_numpy()
    xtx_inv = np.linalg.pinv(x.T @ x)
    beta = xtx_inv @ x.T @ y
    residuals = y - x @ beta
    n, k = x.shape
    sigma2 = max(float(residuals @ residuals) / (n - k), 0.0)
    se = np.sqrt(np.clip(np.diag(sigma2 * xtx_inv), 0.0, None))
    return OLSResult(names, beta, se, residuals, n, k)
channel のような文字列の列は、Rの lm()
が自動で行うのと同じように ダミー変数
に展開する。水準が「Multichannel」「Phone」「Web」の三つなら、最初の「Multichannel」を基準にして
channelPhone と channelWeb
の二列を作る。三つすべてを列にすると切片と完全に重なってしまい、解が一つに決まらないからである。
Rの操作との対応は次の通りである。
| R | Pythonでの操作 |
|---|---|
lm(data, formula = y ~ z + x) |
ols(frame, "y", ["z", "x"]) |
tidy(model) |
ols(...).tidy |
enframe() と map(lm) と
unnest() |
辞書でモデルを列挙し、pl.concat() で結果を縦に積む |
filter(term == "treatment") %>% pull(estimate) |
.filter(pl.col("term") == "treatment").get_column("estimate") |
str_detect(model_index, "A\|B") |
pl.col("model_index").str.contains("A\|B") |
バイアスのあるデータで回帰を実行する
データの準備は第1章と同じである。男性向けメール群とメールなし群に絞った
male_df
がRCTデータであり、そこから「購買意欲が高そうな人を介入群に多く残す」抽出を行った
biased_df がバイアスのあるデータである。
rng = np.random.default_rng(1)
biased_df = (
    male_df.with_columns(
        ((pl.col("history") > 300) | (pl.col("recency") < 6)
         | (pl.col("channel") == "Multichannel")).alias("high_intent"),
        pl.Series("random_number", rng.random(male_df.height)),
    )
    .with_columns(
        pl.when(pl.col("treatment") == 1)
        .then(pl.when(pl.col("high_intent")).then(1.0).otherwise(0.5))
        .otherwise(pl.when(pl.col("high_intent")).then(0.5).otherwise(1.0))
        .alias("keep_probability")
    )
    .filter(pl.col("random_number") < pl.col("keep_probability"))
)

biased_reg = ols(biased_df, "spend", ["treatment", "history"])
print(biased_reg.tidy)
推定するモデルは、目的変数に購買額、介入変数にメールの有無、共変量に過去の購買額を使った次の式である。
実行結果は次の通りである。
| term | estimate | std_error | statistic | p_value |
|---|---|---|---|---|
| (Intercept) | 0.2822 | 0.1473 | 1.916 | 0.0553 |
| treatment | 0.8531 | 0.1782 | 4.788 | 0.0000 |
| history | 0.00144 | 0.00034 | 4.196 | 0.0000 |
教科書のRの結果では treatment の推定値は0.9026、標準誤差は0.1743であった。PythonとRでは乱数生成器が異なるため、同じシード1でも抽出される行が違い、値が少しずれる。しかし読み方は同じである。介入変数 treatment の推定値は約0.85であり、p値は非常に小さいので、「メール配信の効果はない」という帰無仮説は棄却される。この値は「メールを送ることで売上が平均0.85ほど増加する」と解釈できる。
2.1.6 効果検証のための回帰分析で「行わないこと」
出力には treatment 以外の係数も並んでいる。history の係数は正で有意であり、「過去の購買額が高い人ほど今回の購買額も高い」という解釈をしたくなる。しかし、 効果検証のための回帰分析では、介入変数以外の係数は解釈しない 。理由は次の通りである。
- 共変量を入れる目的は、介入変数の係数からバイアスを取り除くことであり、共変量の係数そのものを正しく推定する努力は一切していない。
- したがって共変量の係数の真の値が0であってもなくても、分析の目的には関係がない。
- 同じ理由で、共変量の有意差検定の結果も一切解釈しない。有意でない共変量を「不要」と判断してモデルから外すのは、むしろ有害になりうる(2.2.2で説明する)。
もう一つの「行わないこと」は、予測である。回帰で得たモデルは条件付き期待値の近似なので、次の式に値を代入すれば購買額の予測値を得ることができる。
しかし本書の分析では購買額の予測は目的ではないので、このモデルの予測精度を評価することも、改善することもしない。予測が目的なら、そのための知見が蓄積されている機械学習の手法を使うべきである。Huluの文脈で言えば、「この人がコナンを見るか」を予測するモデルと、「トレイで訴求したことで視聴が何ポイント増えたか」を推定するモデルは、たとえ同じ回帰の形をしていても目的が違い、評価の仕方も変数の選び方も違う。この点は2.4.1で改めて取り上げる。
2.2 回帰分析におけるバイアス
回帰分析でセレクションバイアスを小さくするには、共変量を正しく選ぶ必要がある。この節では、共変量を追加すると効果の推定値がどう変わるのか、その仕組みは何か、そしてどのような変数を選ぶべきか(選んではいけないか)を学ぶ。
2.2.1 共変量の追加による効果への作用
まず、Pythonで共変量を増やしたときの変化を観察する。比較の基準として、RCTデータでの結果が「望ましい値」になる。
rct_reg = ols(male_df, "spend", ["treatment"])
nonrct_reg = ols(biased_df, "spend", ["treatment"])
nonrct_mreg = ols(biased_df, "spend", ["treatment", "recency", "channel", "history"])
三つの結果を treatment の行だけ並べる。
| データ | モデル | treatment の推定値 | 標準誤差 |
|---|---|---|---|
| RCT | spend ~ treatment | 0.770 | 0.145 |
| バイアスあり | spend ~ treatment | 0.954 | 0.177 |
| バイアスあり | spend ~ treatment + recency + channel + history | 0.819 | 0.182 |
教科書のRでは、上から順に0.770、0.979、0.847であった。RCTの結果は乱数の影響を受けないので完全に一致し、残り二つは抽出の違いで少しずれている。
読み方は次の通りである。RCTデータでの単回帰の結果0.770は、第1章で平均の差として得た値と同じである。一方、バイアスのあるデータで介入変数だけを入れた回帰は0.954となり、効果を過大に推定している。 介入変数だけを回帰に投入しても、セレクションバイアスの問題は何も解決しない 。単回帰の係数は、単純な平均の差そのものだからである。
次に、バイアスを人為的に作るときに使った recency、channel、history の三つを共変量として追加する。
結果は0.819となり、RCTの0.770に近づいた。つまり、 セレクションバイアスを生んでいる変数を共変量として加えることで、バイアスの影響がより少ない推定結果が得られる 。ただし完全には一致していない。この「完全ではない」理由も含めて、次節で仕組みを理解する。
2.2.2 脱落変数バイアス(OVB):共変量を入れると何が変わるのか
共変量を追加すると推定値が変わる仕組みを、式で確認する。この仕組みを理解すると、「どの共変量を入れるべきか」という問いに対して、 「目的変数 と介入変数 の両方に相関のある変数を加えるべき」 という答えが得られる。
二つの回帰モデルを考える。
違いは共変量 を含むか否かだけである。モデルBはセレクションバイアスの影響が取り除かれた「正しい」モデルだとする。介入の効果は、モデルAでは 、モデルBでは である。知りたいのは、 と の差がどのように決まるかである。
モデルAはモデルBから を省いているので、モデルAの誤差 の中には、省かれた とモデルBの誤差 が含まれている。
本来必要なのにモデルから抜け落ちている のような変数を 脱落変数(omitted variable) と呼ぶ。このとき、モデルAの介入効果 は次の関係を満たす。
ここで は、脱落変数 を介入変数 に回帰したときの係数である。
なぜこの式が成り立つのか
教科書では「知られている」とだけ書かれているが、導出は簡単なので確認しておく。モデルBに、 の回帰式を代入する。
最後の括弧の中は、 と相関しない誤差である( は に回帰した残差なので と無相関、 はモデルBの誤差なので と無相関)。したがってこの式は「 を だけに回帰したモデル」の形になっており、その の係数は である。これがモデルAの にほかならない。
この余分な項 を 脱落変数バイアス(Omitted Variable Bias、OVB) と呼ぶ。モデルAで効果を分析すると、得られる推定結果は「本来の効果 + OVB」になってしまう。一方、 を加えたモデルBでは、OVBが取り除かれる。
OVBの直観
はモデルBにおける と の関係であり、 は と の関係である。つまりOVBは、「 と の関係」に「 と の関係」を掛けたものである。直観的には、 省略された共変量が に与える影響が、 との相関を通じて、あたかも の効果のように見えてしまっている ということである。
ワークド例:Huluの8人でOVBを手計算する
抽象的な式を、小さなデータで確かめる。2.1の冒頭で層別比較に使った8人の表をもう一度使う。 は「アニメ視聴者か(1/0)」、 は「『名探偵コナン』を上段トレイで訴求したか(1/0)」、 は「7日間のコナン視聴分数」である。訴求はアニメ視聴者に集中させたので、アニメ視聴者4人のうち3人、非視聴者4人のうち1人が訴求を受けたとする。真の効果は全員 分で、訴求がなければアニメ視聴者は60分、非視聴者は20分見るとする。誤差はない。
| 人 | (アニメ視聴者) | (訴求) | (分) |
|---|---|---|---|
| p1 | 1 | 1 | 80 |
| p2 | 1 | 1 | 80 |
| p3 | 1 | 1 | 80 |
| p4 | 1 | 0 | 60 |
| p5 | 0 | 1 | 40 |
| p6 | 0 | 0 | 20 |
| p7 | 0 | 0 | 20 |
| p8 | 0 | 0 | 20 |
モデルA(単純比較) :訴求あり4人の平均は 、なし4人の平均は である。 だけの単回帰の係数は平均差に等しいので、 となる。真の効果20に対して、2倍に見えている。
モデルB( を追加) :データは誤差なしで に従っているので、回帰は 、 を返す。 は「アニメ視聴者は非視聴者より、訴求の有無をそろえて40分多く見る」という関係である。
モデルC( を に回帰) :訴求あり4人のうちアニメ視聴者は 、なし4人のうちは である。したがって となる。「訴求を受けた群には、アニメ視聴者が50ポイント多い」という関係である。
OVBの式を確かめる。
一致した。単純比較で得た40は、真の効果20に、「訴求群にアニメ視聴者が多い( )」と「アニメ視聴者はもともと40分多く見る( )」の積20が上乗せされたものである。第1章では同じ差を「効果 + セレクションバイアス」と言葉で分解したが、OVBの式はそのセレクションバイアスを、二つの相関の積として定量化してくれる。
この例はPythonでも確認できる。
hulu8 = pl.DataFrame({
    "anime_fan":   [1, 1, 1, 1, 0, 0, 0, 0],
    "recommended": [1, 1, 1, 0, 1, 0, 0, 0],
    "minutes":     [80, 80, 80, 60, 40, 20, 20, 20],
})
model_a = ols(hulu8, "minutes", ["recommended"])
model_b = ols(hulu8, "minutes", ["recommended", "anime_fan"])
model_c = ols(hulu8, "anime_fan", ["recommended"])
alpha1 = model_a.coef_of("recommended")            # 40.0
beta1, beta2 = model_b.coef_of("recommended"), model_b.coef_of("anime_fan")  # 20.0, 40.0
gamma1 = model_c.coef_of("recommended")            # 0.5
print(gamma1 * beta2, alpha1 - beta1)             # 20.0 20.0
有意でない共変量を外してはいけない理由
2.1.6で「共変量の検定結果は解釈しない」と述べた。OVBの式を見ると、その理由がより強い形で分かる。OVBの値 の中には、「 が統計的に有意か」という情報はどこにも入っていない。有意でなくても が0でなければ、その変数を外したときにOVBが発生する。したがって、「有意でないから」という理由で共変量を除外すると、バイアスを含んだ推定結果を得ることになる。共変量の選択は、検定結果ではなく、次に述べる「介入の割り当てがどう決まったか」という知識に基づいて行う。
2.2.3 PythonによるOVBの確認
実際のデータで、OVBの式が成り立つことを確認する。次の二つのモデルを比べる。
差は history を含むかどうかである。history は過去の購買額なので売上と強く相関する。また、バイアスのあるデータを作るときに「history が300を超えると介入が起こりやすくなる」ように加工した。したがって history を外すとOVBが発生する。OVBの式に従えば、次が成り立つはずである。
は、脱落している history を、モデルAに含まれている変数で回帰したときの treatment の係数である。
教科書ではbroomの enframe() と map()
で三つの回帰をまとめて実行し、unnest()
で一つの表にしている。Pythonでは辞書でモデルを列挙し、結果に
model_index 列を付けて縦に積めばよい。
formulas = {
    "reg_A": ("spend", ["treatment", "recency", "channel"]),
    "reg_B": ("spend", ["treatment", "recency", "channel", "history"]),
    "reg_C": ("history", ["treatment", "channel", "recency"]),
}
df_results = pl.concat([
    ols(biased_df, y, xs).tidy.with_columns(pl.lit(name).alias("model_index"))
    for name, (y, xs) in formulas.items()
])

# treatment の係数を A, B, C の順に取り出す
treatment_coef = (
    df_results.filter(pl.col("term") == "treatment")
    .sort("model_index").get_column("estimate").to_numpy()
)
# モデルB の history の係数
history_coef = df_results.filter(
    (pl.col("model_index") == "reg_B") & (pl.col("term") == "history")
).get_column("estimate").item()

ovb = history_coef * treatment_coef[2]       # beta_4 * gamma_1
coef_gap = treatment_coef[0] - treatment_coef[1]   # alpha_1 - beta_1
print(ovb, coef_gap)
結果は次の通りである。
| 量 | 値 |
|---|---|
| (モデルAの treatment) | 0.86004 |
| (モデルBの treatment) | 0.81899 |
| (モデルBの history) | 0.0015025 |
| (モデルCの treatment) | 27.3216 |
| OVB | 0.041050 |
| 0.041050 |
小数点以下6桁まで一致した(教科書のRでは両方とも0.02805398)。 は「他の共変量をそろえたうえで、メール配信群は過去の購買額が平均27.3ドル高い」という意味であり、 は「過去の購買額が1ドル高いと今回の購買額が0.0015ドル高い」という意味である。積の0.041が、history を入れ忘れたときに treatment の係数に乗るバイアスである。 共変量を追加すると推定値が変化するのは、追加によってOVBが消失するからである 。
Huluの8人の例とメールデータの例を並べて、 の分解を図にすると次のようになる。どちらも、共変量を入れないモデルの係数は「本来の効果」の上に「OVB」が積み重なった高さになっている。
2.2.4 OVBが与えてくれる情報
OVBの式は、共変量が不十分なモデルが持つバイアスの「構造」を表している。そこから、実務で役に立つ四つの情報が得られる。
第一に、入れるべき変数の条件が分かる。 バイアスは「脱落変数と の関係」と「脱落変数と の関係」の積である。したがって、介入 の決定に関係があり、かつ目的変数 とも相関がある変数を加えるとバイアスが減る。このように と の両方に関係のある変数を 交絡因子(confounder) と呼ぶ。逆に、どちらか一方としか関係のない変数を加えても、効果の推定値は変わらない。
- と相関するが と無相関な変数( ):予測には役立つが、効果の推定値は変わらない。
- と相関するが と無相関な変数( ):やはり効果の推定値は変わらない。
Huluの例で言えば、「プロフィールの言語設定」が (コナン視聴)と少し相関していても、訴求対象の選定に使われていなければ、入れても推定値は動かない。一方、「過去90日のアニメ視聴日数」は選定に使われ、かつ視聴とも強く相関するので、必ず入れる必要がある。
第二に、どちらかの相関が小さければバイアスは無視できる。 と のどちらかが0でなくても非常に小さいなら、積はさらに小さくなる。すべての交絡因子を完璧に入れなくても、実用上十分にバイアスが小さくなる場合がある。
第三に、すでに入れた変数と相関の強い変数は、追加しても効果が小さい。 追加しようとしている変数と相関の強い変数がすでにモデルに入っていれば、その変数の (他の共変量をそろえたうえでの との関係)は小さくなっている。たとえば「過去90日の総視聴時間」を入れていれば、「過去90日の視聴日数」を追加しても推定値はほとんど動かないだろう。これは、 の割り振りに関係するすべての変数を入れなくても、バイアスが十分小さくなる可能性を意味する。
第四に、手に入らない変数によるバイアスの「向き」を推察できる。 データにない変数 について、 との関係と との関係がそれぞれ正か負かを考えれば、今の推定値が過大か過小かを想定できる。
X_omit が大きいほど Y が大きい
X_omit が大きいほど Y が小さい
介入群に X_omit が多い
過大評価
過小評価
介入群に X_omit が少ない
過小評価
過大評価
たとえばHuluで、「本人のコナンへの潜在的な興味」はデータとして手に入らない。しかし、興味が強い人ほど訴求対象に選ばれやすく( )、興味が強い人ほど視聴しやすい( )と考えられるので、この変数を入れられない限り、推定値は過大評価の側に偏っていると想定できる。逆に、休眠しそうな人に復帰施策を行うような場合は、介入群にもともと視聴しにくい人が集まる( かつ )ので、推定値は過小評価に偏る。
2.2.5 Conditional Independence Assumption(CIA)
効果検証のための回帰分析では、モデルに含まれていない変数によるOVBがすべて0になる状態を目指す。これは、 モデルに含めた共変量で条件付けたとき、介入変数 が潜在アウトカム と独立になっている という状況であり、 CIA(Conditional Independence Assumption、条件付き独立の仮定) と呼ばれる。式で書くと次の通りである。
記号 は「独立」を意味し、縦棒 の右側は「これを固定したうえで」という条件を表す。読み方は「共変量 が同じ人たちの中では、介入 の割り振りは、その人がどのような結果を出しそうか( )とは無関係である」となる。
より直観的に言えば、 共変量の値が同一のサンプルの中では、介入 はランダムに割り振られているのに等しい という状態である。図2.2は、これをメールマーケティングの例で示している。
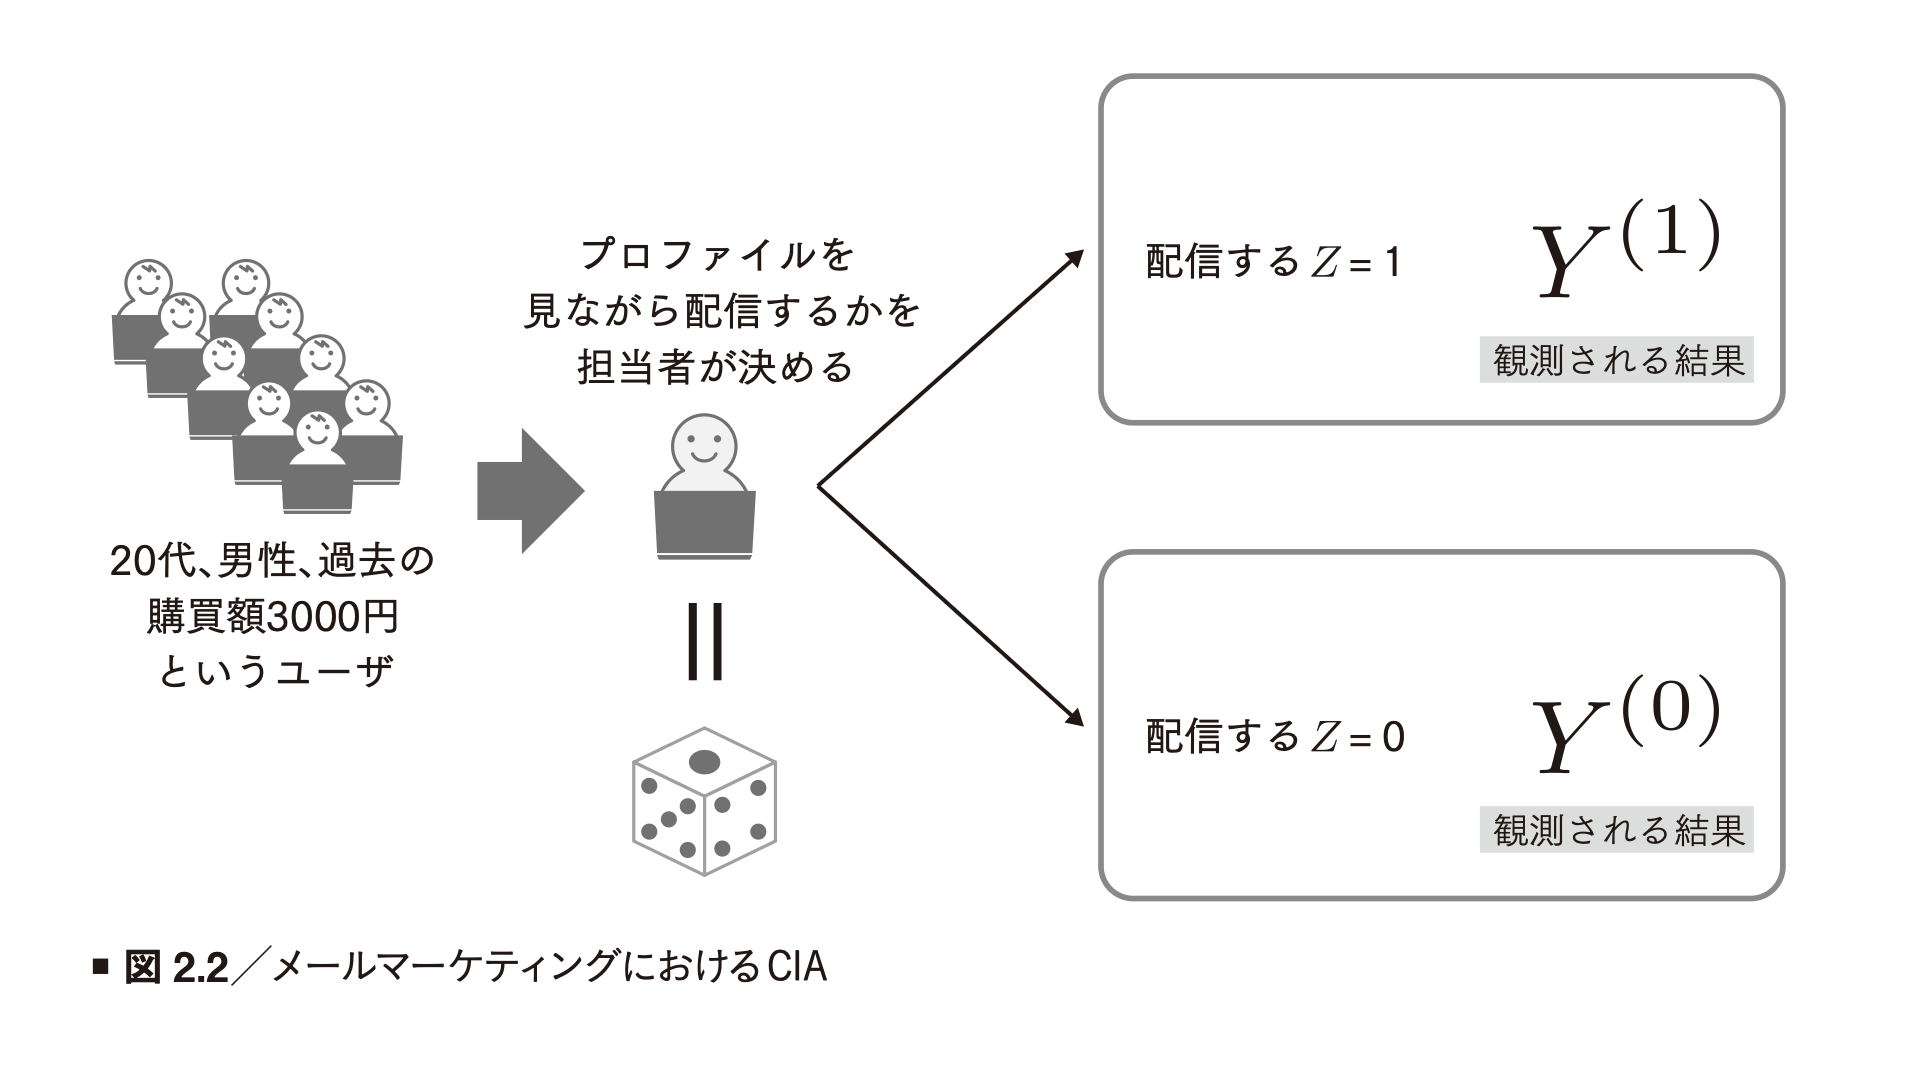
性別と年齢と過去の購買額を共変量としてモデルに投入するとき、私たちは「20代、男性、過去の購買額3000円」という同じプロファイルを持つユーザの中では、担当者がメールを配信するかどうかの判断は、サイコロを振って決めたのと同じだと仮定していることになる。担当者がそれ以外の情報(たとえば直近のサイト来訪)を見て配信を決めていたなら、この仮定は崩れる。
Huluに置き換えると、「過去90日のアニメ視聴日数、総視聴時間、契約月数、キッズプロフィールかどうか」を共変量に入れた回帰の結果を「訴求の効果」と呼ぶとき、私たちは「これらが同じ値のプロフィール同士では、訴求されたかどうかはコナンへの興味とは無関係に決まった」と仮定している。訴求ルールが実際にそれらの変数だけで決まっていたなら、この仮定は妥当である。しかし、たとえばルールの中に「直近7日にコナンの詳細ページを開いた」という条件が含まれていて、その変数をモデルに入れていなければ、仮定は満たされない。
回帰分析で推定した効果が正しいと主張することは、投入した共変量がCIAを満たすと主張することと同じである 。したがって、回帰の結果を見て「これは正しい効果か」と考えるときは、係数やp値を見るのではなく、CIAが満たされているかを考える必要がある。
2.2.6 変数の選び方とモデルの評価
共変量の選択とCIA
回帰分析のモデルは、次のステップで作る。
- 介入の割り当てがどのように決定されたかを考える。 たとえば「去年の購買量が多い人にメールを送っただろう」「最近購買した人に送っただろう」と想定する。Huluなら「アニメ視聴日数が多いプロフィールに訴求しただろう」「新規会員は対象外だろう」と想定する。
- 想定される決定方法を表現できる共変量を選ぶ。 昨年の購買量、直近の購買。Huluなら過去90日のジャンル別視聴日数、契約からの経過月数。
- 選んだ共変量と の関係を考慮して、それぞれの関数の形を決める。 線形か、対数か、2乗項が必要か、区分のダミーにするか。
推定された効果の妥当性を主張するには、作ったモデルの共変量がCIAを満たしていると考える必要がある。しかし、これを主張するうえで二つの問題がある。
問題1:バイアスの評価ができない
一つは、 得られた推定値にどれだけバイアスが残っているかを評価する方法がない という問題である。もし評価できるなら、共変量の組み合わせを試してバイアスが最小になるものを選べばよい。しかし現実にはそれができない。
OVBはバイアスの評価になっているように見えるかもしれない。しかし、OVBは「モデル間でのバイアスの変化」を示すものであり、「残っているバイアスの大きさ」を示すものではない。上の例で history を追加してOVBが0.041減ったことは分かるが、history を追加した後のモデルにどれだけバイアスが残っているかは分からない。
このため、分析者は「セレクションバイアスがどのような理由で発生し、どの変数を含めればコントロールでき、どの組み合わせでCIAが満たされるか」を、データではなく知識に基づいて仮定する必要がある。
問題2:必要な共変量がデータにない
もう一つは、 手持ちのデータに含まれる変数だけでは、バイアスを十分に減らせない可能性がある という問題である。バイアスを生む要因を理解していても、それを表すデータが定義できない、あるいは定義できても入手できない場合がある。
たとえばHuluで、あるトレイの訴求対象が「運用担当者の目視による選定」で決まっていた場合、担当者の判断基準は記録されていない。あるいは、「そのプロフィールがコナンをどれくらい楽しみにしているか」は、視聴履歴から一部は推測できても、完全には測れない。
必要な共変量がデータにない場合、 回帰分析でセレクションバイアスを取り除くことは基本的に不可能である 。得られた推定値は、投入した共変量による影響は取り除けているものの、データにない変数によるOVBを含んでいる。ドメイン知識があれば、そのOVBの大きさや向きを推察することはできるが、それは主観を含む方法であり、分析者の願望が入り込みやすい。
これら二つの問題は、明確な指標を見ながらモデルを選ぶことができず、モデルの限界も定量的に評価できないことを意味する。したがって分析者は、手持ちのデータにどのようなバイアスがあり、選んだ共変量がどのバイアスをコントロールしているのかをよく認識して判断する必要がある。
なお、より応用的な手法を使えば、これらの問題に対処できる場合がある。操作変数法や固定効果モデルは、データが一定の条件を満たすときに、観測できない交絡があっても効果を推定できる。第4章の差分の差分法も、必要な共変量が手に入らないときの対処法の一つである。
Sensitivity Analysis:結果がどれだけ頑健かを確かめる
手持ちのデータにない変数がセレクションバイアスを起こしている可能性は、常につきまとう。回帰分析はデータにある変数しか使えないので、この問題には直接対処できない。したがって、そのようなバイアスが起きていそうかどうかを確認することが重要になる。
そのための方法が Sensitivity Analysis(感度分析) である。経済学の実証論文では、複数の共変量の組み合わせでの推定結果が並べて報告されることが多い。これは、組み合わせごとに推定された効果が大きく変化するかを見るためのものである。
具体的には、分析者が重要だと認識している共変量以外の共変量をモデルから抜いてみて、効果の推定値が大きく変動しないかを確認する。変動が小さければ、回帰の結果は他の変数の影響を受けにくいことを示しており、データにない変数を含めたとしても大きく変化しないだろうと示唆される。逆に、共変量の出し入れで推定値が大きく動くなら、まだ入れていない変数によっても大きく動く可能性が高く、結果の信頼性は低い。
本ノートの例で言えば、treatment の推定値は共変量なしで0.954、recency と channel を入れて0.860、さらに history を入れて0.819と、追加するごとに動いている。これは「まだ動く余地がある」ことの示唆であり、RCTの0.770との差がまさに残っているバイアスである。感度分析をより定量的に行う方法は、追加手法の節で紹介する。
2.2.7 Post treatment bias:介入の後に決まる変数を入れてはいけない
OVBの式を見ると、 と の両方に相関する変数は何でも入れたくなる。しかし、 介入の影響を受ける変数をモデルに入れると、回帰の結果は歪んでしまう 。
メールマーケティングの例で、介入の影響を受ける変数は「サイト来訪 visit」である。ユーザはサイトに来訪しなければ購買できないので、来訪と購買 には相関がある。そしてメールの配信は来訪を喚起するので、 とも相関がある。OVBの条件を満たしているように見える。
実際に、他の共変量をそろえたうえで treatment と visit がどれだけ相関しているかを見る。
cor_visit_treatment = ols(biased_df, "treatment", ["visit", "channel", "recency", "history"])
print(cor_visit_treatment.tidy)
visit の係数は0.147で、p値はほぼ0であった(教科書では0.144)。他の共変量の影響を取り除いても、来訪者は配信群に14.7ポイント多い。OVBは大きそうなので、visit を回帰モデルに追加したくなる。
bad_control_reg = ols(biased_df, "spend", ["treatment", "channel", "recency", "history", "visit"])
print(bad_control_reg.tidy)| term | estimate | std_error | statistic | p_value |
|---|---|---|---|---|
| (Intercept) | -0.736 | 0.383 | -1.922 | 0.055 |
| treatment | 0.249 | 0.181 | 1.378 | 0.168 |
| channelPhone | 0.311 | 0.307 | 1.013 | 0.311 |
| channelWeb | 0.285 | 0.306 | 0.932 | 0.351 |
| recency | 0.019 | 0.026 | 0.718 | 0.473 |
| history | 0.00100 | 0.00038 | 2.655 | 0.008 |
| visit | 7.241 | 0.247 | 29.264 | 0.000 |
メール配信の効果は、visit を含まないモデルの0.819から0.249へと大きく低下し、有意でもなくなった。RCTの0.770から大きく乖離している(教科書では0.847から0.294へ低下)。なぜこのようなことが起きるのだろうか。
仕組み:来訪者の「中身」が群によって違う
ポイントは、メールの配信が もともと購買傾向が弱いユーザの来訪を増やしている ことにある。
- メール配信群の来訪者は、「メールがなくても来訪する購買傾向の強いユーザ」と「メールがあったから来訪した購買傾向の弱いユーザ」の混合である。
- メール非配信群の来訪者は、「もともと購買傾向の強いユーザ」だけである。
したがって、来訪したユーザ同士で比較すると、配信群の方が購買傾向の弱い人を多く含むため、平均売上が低く見える。visit をモデルに入れることは、まさに「来訪者同士で比較する」ことに相当するので、効果が過小に推定される。
ワークド例:数値で確かめる
架空の数値で確認する。RCTで1,000人ずつを配信群と非配信群に分けたとする。ユーザは2種類おり、それぞれ半数ずつである。
| ユーザの種類 | 人数(各群) | 来訪する条件 | 来訪したときの購買額 |
|---|---|---|---|
| 高意欲 | 500 | メールの有無に関係なく来訪 | 10 |
| 低意欲 | 500 | メールがあれば来訪、なければ来訪しない | 2 |
真の効果を計算する。高意欲ユーザにはメールの効果がなく、低意欲ユーザはメールによって来訪し2購買するので、一人当たりの平均効果は である。全員で平均を比較すれば、配信群 、非配信群 で、差は正しく になる。
ところが来訪者に絞ると、次のようになる。
差は である。真の効果は なのに、来訪者同士の比較では と、符号まで逆になった。 介入によって「誰が来訪者になるか」が変わってしまったため、来訪者という条件で揃えることが、比較可能性を壊してしまった のである。
メール配信群の来訪者(1,000人)
平均購買額 = 6
メール非配信群の来訪者(500人)
平均購買額 = 10
群ごとの平均購買額を「全員で比べた場合」と「来訪者だけで比べた場合」で並べると、同じデータから正反対の結論が出ることが一目で分かる。
実際のRCTデータでも同じ構造が見える。来訪率は非配信群10.6%、配信群18.3%であり、メールは来訪を大きく増やしている。そして来訪者に絞った平均購買額は非配信群6.15、配信群7.78である。この差1.63は、全員で比較した効果0.77とは別の量であり、「来訪者の中身が違う」ことの影響を含んでいる。
このように、介入によって影響を受けた変数を分析に入れることで起きるバイアスを Post Treatment Bias と呼ぶ。重要なのは、 これは介入がどのように割り当てられていたとしても発生する ということである。上のワークド例はRCTの設定であった。つまり、メールをランダムに配信していても、そのデータで visit を投入した回帰を行えば、同じ問題に直面する。
対処:介入より前に値が決まる変数だけを使う
この問題を避けるには、 介入よりも後のタイミングで値が決まる変数を分析から除外する 必要がある。介入が割り振られる前に値が決まっている変数は、介入の影響を受けることがないので、この問題は起きない。ただし、どの変数がこれに該当するかの判断は分析者の知識に依存する。
介入前(共変量に使ってよい)
メール:recency、history、channel
Hulu:過去90日の視聴日数・総視聴時間、契約月数、プロフィール属性、利用デバイス
介入
メールを配信する/上段トレイで訴求する
介入後(共変量に入れてはいけない)
メール:visit(来訪)
Hulu:訴求後のアプリ起動回数、トレイのクリック、詳細ページ閲覧、予告編の再生
Huluの推薦施策では、この落とし穴に特に注意が必要である。訴求の効果を測るときに、「訴求後のセッション数」や「トレイをクリックしたか」を共変量に入れると、まさに visit と同じ問題が起きる。訴求は「もともとあまりアプリを開かない人」の起動やクリックを増やすので、これらで条件付けると効果が過小に見える。
データの取得範囲によるPost Treatment Bias
Post Treatment Biasのような問題は、変数の選択以外でも発生する。実際のビジネスでは、 サービスを利用したユーザのログしか残っていない ことがよくある。たとえば、どのユーザが広告を目にしたかは分からないが、広告をクリックして流入したユーザのログは残っている、という状況である。
このとき、サービスへのアクセスを誘発する広告施策を行うと、広告配信グループには購買意向の弱いユーザが多く流入し、非配信グループはもともと購買意向の強いユーザだけがアクセスしている、という状態になる。このデータで分析すれば、先ほどのメールの例と同じく「介入グループの方が平均売上が低い」という結果を得る。割り振りがランダムであっても同じである。
自社サービス内の施策を評価する場合は、すべてのユーザのデータが得られることが多いので、この問題は起きにくい。しかし、自社サービスにユーザを誘引する施策(プッシュ通知、外部広告、メール)を評価する場合、分析するデータの取得は施策を実行するツールに依存するため、大きな問題になる。
Huluで言えば、プッシュ通知の効果を「通知後にアプリを起動した人」のログだけで評価すると、この問題に直面する。通知を受けた群には「通知がなければ起動しなかった人」が混ざり、受けなかった群には「自発的に起動する人」だけが残るからである。 施策を受けたユーザだけでなく、施策の対象になり得たユーザ全体のデータを用意すること が、分析において決定的に重要である。第1章で「視聴ログから始めず、割当台帳を基準に結合する」と述べたのは、この理由による。
2.3 回帰分析を利用した探索的な効果検証
ここでは、回帰分析を使って効果の検証が実際にどのように行われるかを、Angrist et al.(2002)を例に学ぶ。この論文は、コロンビアで行われた私立学校の学費割引券に関する実験を分析した研究であり、ここではその一部を再現する。回帰の計算そのものではなく、 回帰分析を使っていかに介入の効果の全容をとらえるか という部分に着目する。
2.3.1 PACESによる学費の割引券配布の概要
教育に補助を行うとき、学校側に補助するべきか、生徒側に補助するべきかという議論がある。この論文は、コロンビアで行われた「生徒側への補助」である学費割引券の実験データを分析し、受給者の経済的負担に補助を行うことの効果を検証した。
1990年代のコロンビアでは公立学校が上手く機能しておらず、私立学校に通うことがより良い教育を受けるための代表的な手段であった。しかし私立学校は学費が高く、多くの人にとって経済的に通いにくかった。そこでコロンビア政府は、貧困層の子供に良い教育を受けてもらうために PACES というプロジェクトを立ち上げた。約12万人の中等教育の生徒を対象に、応募者の中からランダムに選んだ当選者に、私立学校の学費の半分程度を政府が肩代わりする割引券を配った。
この割引券を介入としたときの特徴は二つある。
- 私立学校の価格を大幅に下げる。 当選グループでは私立学校へ通う割合が高まり、また本来は所得の限界で通えなかった学費の高い学校を選べるので、受ける教育の質が向上すると期待される。
- 落第すると権利を失う。 割引券は留年すると失効する。親にとっては割引券の失効は所得の減少に等しいので、子に一定の成績をおさめさせるインセンティブが生まれる。したがって当選グループでは留年の減少が期待される。
介入はランダムに割り当てられているので、これはRCTである。一見、回帰分析を行う必要はないように思える。しかし実際のデータは、 割り当ての数年後に行われた調査に回答してくれた人 から得られている(図2.3)。
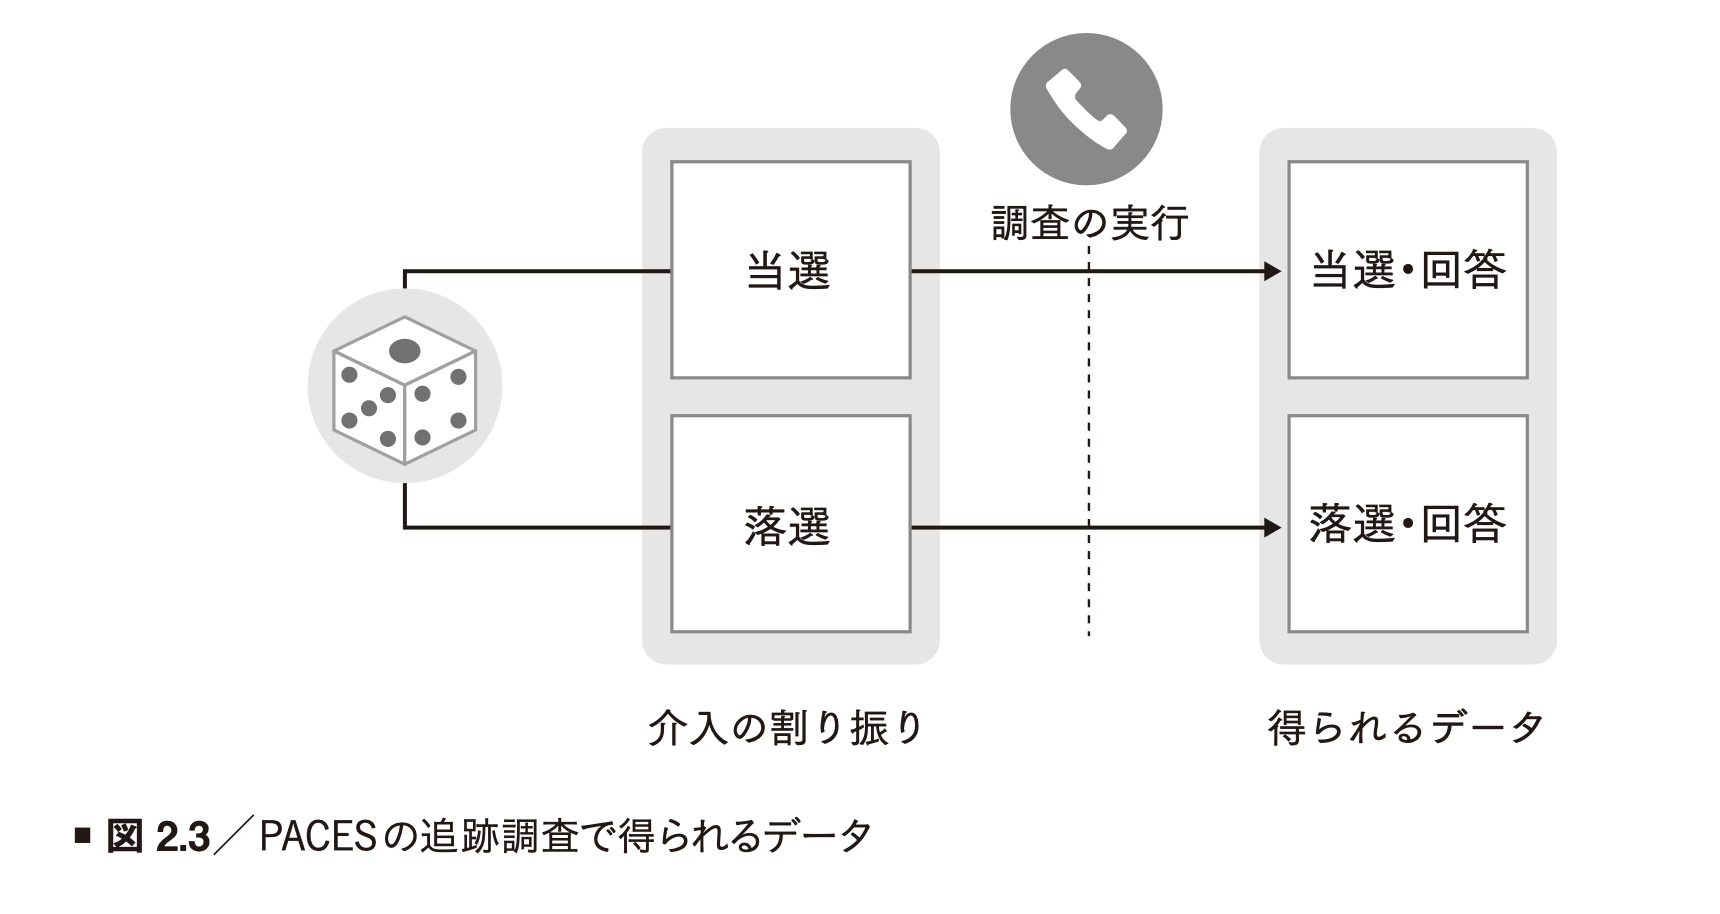
調査に回答するかどうかの傾向が当選グループと非当選グループで異なれば、得られるサンプルの傾向も異なってしまう。たとえば所得が低い人は経済状況について回答したくない傾向があるかもしれない。もし介入が将来の所得を押し上げる効果を持つなら、非当選グループでは回答が得られにくくなる。その結果、回答が得られたデータでは非当選グループの所得が本来より高く見え、介入の効果が大きく推定されてしまう。
これは、 介入の割り振り自体がランダムでも、その後にデータの加工や追加の調査があれば、セレクションバイアスが発生しうる ということである。第1章の「無作為化したデータでも、後からの抽出でバイアスが生まれる」と同じ構造である。したがってここでの回帰分析では、主に調査方法の影響を取り除くような共変量を選ぶ。
| 変数名 | 説明 |
|---|---|
| SVY | 電話による調査が行われたか |
| HSVISIT | 調査が対面で行われたか |
| DMONTH1〜12 | 調査が何月に行われたか |
| AGE | 調査時の学生の年齢 |
| SEX2 | 学生の性別 |
| STRATA1〜6、MS | 調査対象の親の社会的地位の分類 |
SVY と HSVISIT は調査方法の影響を、DMONTH は調査タイミングの影響を取り除く。AGE、SEX、STRATA は、回答が偏っている際にセレクションバイアスを生みそうな変数である。
Huluで似た構造が起きるのは、「アプリ内アンケートへの回答者」だけで施策を評価する場合や、「実験後も契約を継続している人」だけで視聴を評価する場合である。施策が継続率に影響するなら、継続者だけで比較することは介入後の変数で条件付けることになる。
2.3.2 Pythonによる回帰分析の実行
割引券の影響を多面的に見るために、さまざまな目的変数に対して回帰分析を行う。利用するモデルは次の通りである。
添え字 は目的変数の種類を表す。たとえば は生徒 が奨学金を受け取っているか、 は私立学校へ通っているかである。つまり 目的変数の数だけ別々の回帰モデルがあり、それぞれ独立に推定する 。 は当選したか(VOUCH0)であり、興味のある係数は である。
vouchers = pl.read_csv("data/vouchers.csv")

covariates = (
    ["SVY", "HSVISIT", "AGE"]
    + [f"STRATA{i}" for i in range(1, 7)] + ["STRATAMS", "D1993", "D1995", "D1997"]
    + [f"DMONTH{i}" for i in range(1, 13)] + ["SEX2"]
)
outcomes = [
    "TOTSCYRS", "INSCHL", "PRSCH_C", "USNGSCH", "PRSCHA_1", "FINISH6", "FINISH7",
    "FINISH8", "REPT6", "REPT", "NREPT", "MARRIED", "HASCHILD", "HOURSUM", "WORKING3",
]
# Angrist (2002) Table 3 の Bogota 1995 サンプル
regression_data = vouchers.filter((pl.col("TAB3SMPL") == 1) & (pl.col("BOG95SMP") == 1))

def run_many(frame: pl.DataFrame) -> pl.DataFrame:
    rows = []
    for y in outcomes:
        for kind, xs in (("base", ["VOUCH0"]), ("covariate", ["VOUCH0", *covariates])):
            res = ols(frame, y, xs).tidy.filter(pl.col("term") == "VOUCH0")
            rows.append(res.with_columns(
                pl.lit(f"{y}_{kind}").alias("model_index"),
                pl.lit(y).alias("outcome"), pl.lit(kind).alias("model"),
            ))
    return pl.concat(rows).with_columns(
        (pl.col("estimate") - 1.96 * pl.col("std_error")).alias("ci_low"),
        (pl.col("estimate") + 1.96 * pl.col("std_error")).alias("ci_high"),
    )

df_results = run_many(regression_data)
run_many()
は、各目的変数について「共変量なし(base)」と「共変量あり(covariate)」の二つのモデルを推定し、割引券の係数だけを取り出して一つの表にまとめる。model_index
列を見れば、どの目的変数に対するどのモデルの結果かが分かる。教科書の
enframe() %>% mutate(map(lm)) %>% unnest()
に相当する処理である。本ノートの実行では、Bogota
1995サンプルは1,147行であった。
2.3.3 私立学校への通学と割引券の利用についての分析
まず、当選グループで割引券がちゃんと使われたかを確認する。6年生の開始時に私立学校に在籍していたかを示す PRSCHA_1 と、調査期間中に何らかの奨学金を使ったかを示す USNGSCH に対する結果を見る。
using_voucher_results = (
    df_results.filter(pl.col("outcome").is_in(["PRSCHA_1", "USNGSCH"]))
    .select("model_index", "estimate", "std_error", "p_value")
    .sort("model_index")
)| model_index | estimate | std_error | p_value |
|---|---|---|---|
| PRSCHA_1_base | 0.0629 | 0.0169 | 0.0002 |
| PRSCHA_1_covariate | 0.0574 | 0.0170 | 0.0008 |
| USNGSCH_base | 0.5089 | 0.0230 | 0.0000 |
| USNGSCH_covariate | 0.5042 | 0.0230 | 0.0000 |
教科書のRの結果とほぼ完全に一致する(乱数を使わないため)。
PRSCHA_1 の結果は、共変量の有無にかかわらず約6%の効果である。当選グループでは私立学校で6年生を始める比率が6ポイント高まった。確かに正の効果だが、学費が半分になったのに通学が6ポイントしか増えないのは直観に反する。データを確認すると、落選グループでも87.7%の生徒が6年生を私立学校でスタートしている。つまり、 当選してもしなくても、結局ほとんどの生徒が私立学校へ通っている 。
Angrist et al.(2002)はこの傾向について、申請の条件に私立学校の入学許可の提出が含まれていたことが理由だろうと説明している。すでに入学する確率が高い生徒の間で介入をランダムに割り当てたので、通学率での差が出にくかったのである。この結果は、当選の有無で生徒が受ける教育の質は短期的にはそう大きく変わらないことを意味する。したがって、今後の分析で学力などに効果が確認できたとしても、その効果は学習環境を短期的に変えたことで生まれたわけではない、と示唆される。
USNGSCH の結果は、どちらのモデルでも約50%の効果である。落選グループの奨学金利用率は5.7%なので、当選した生徒の多くが割引券を利用し続けていることが分かる。
二つのアウトカムについて、落選グループの水準と、そこに効果を上乗せした当選グループの水準を並べると、「私立学校での開始」には伸びる余地がほとんど残っていなかったことがよく分かる。
まとめると、割引券自体は当選グループでちゃんと使われているが、そもそも私立学校への通学率が高いために、通学率での効果は限定的であった。少なくともこのデータでは、割引券に私立学校へ「通わせ始める」効果は確認されなかった。
Huluの推薦施策でも、最初に確認すべきは「施策はそもそも届いたか」である。上段トレイで訴求しても、対象者がホーム画面を開かなければ表示されない。「訴求対象に選ばれた人のうち、実際にトレイが表示された割合」を先に確認しなければ、視聴への効果が小さかったときに「訴求が効かなかった」のか「訴求が届かなかった」のかを区別できない。
2.3.4 割引券は留年を減らしているか
割引券を継続利用するには留年してはいけないので、当選グループの生徒には勉学に励むインセンティブがある。親にも学費負担の観点から、子に勉強を促すインセンティブがある。したがって、私立学校に入学する比率は大きく変わらなくとも、割引券が留年を減らして私立学校への通学を継続させる効果はありそうだと考えられる。
図2.4は、進学や留年に関連する変数を目的変数とした回帰分析における当選の効果を示したものである。縦軸が効果量、横軸がモデル、点の上下の幅が95%信頼区間である。信頼区間が0にかかっていなければ、5%水準で有意差がある。以降は共変量を含んだモデルのみ解釈する。
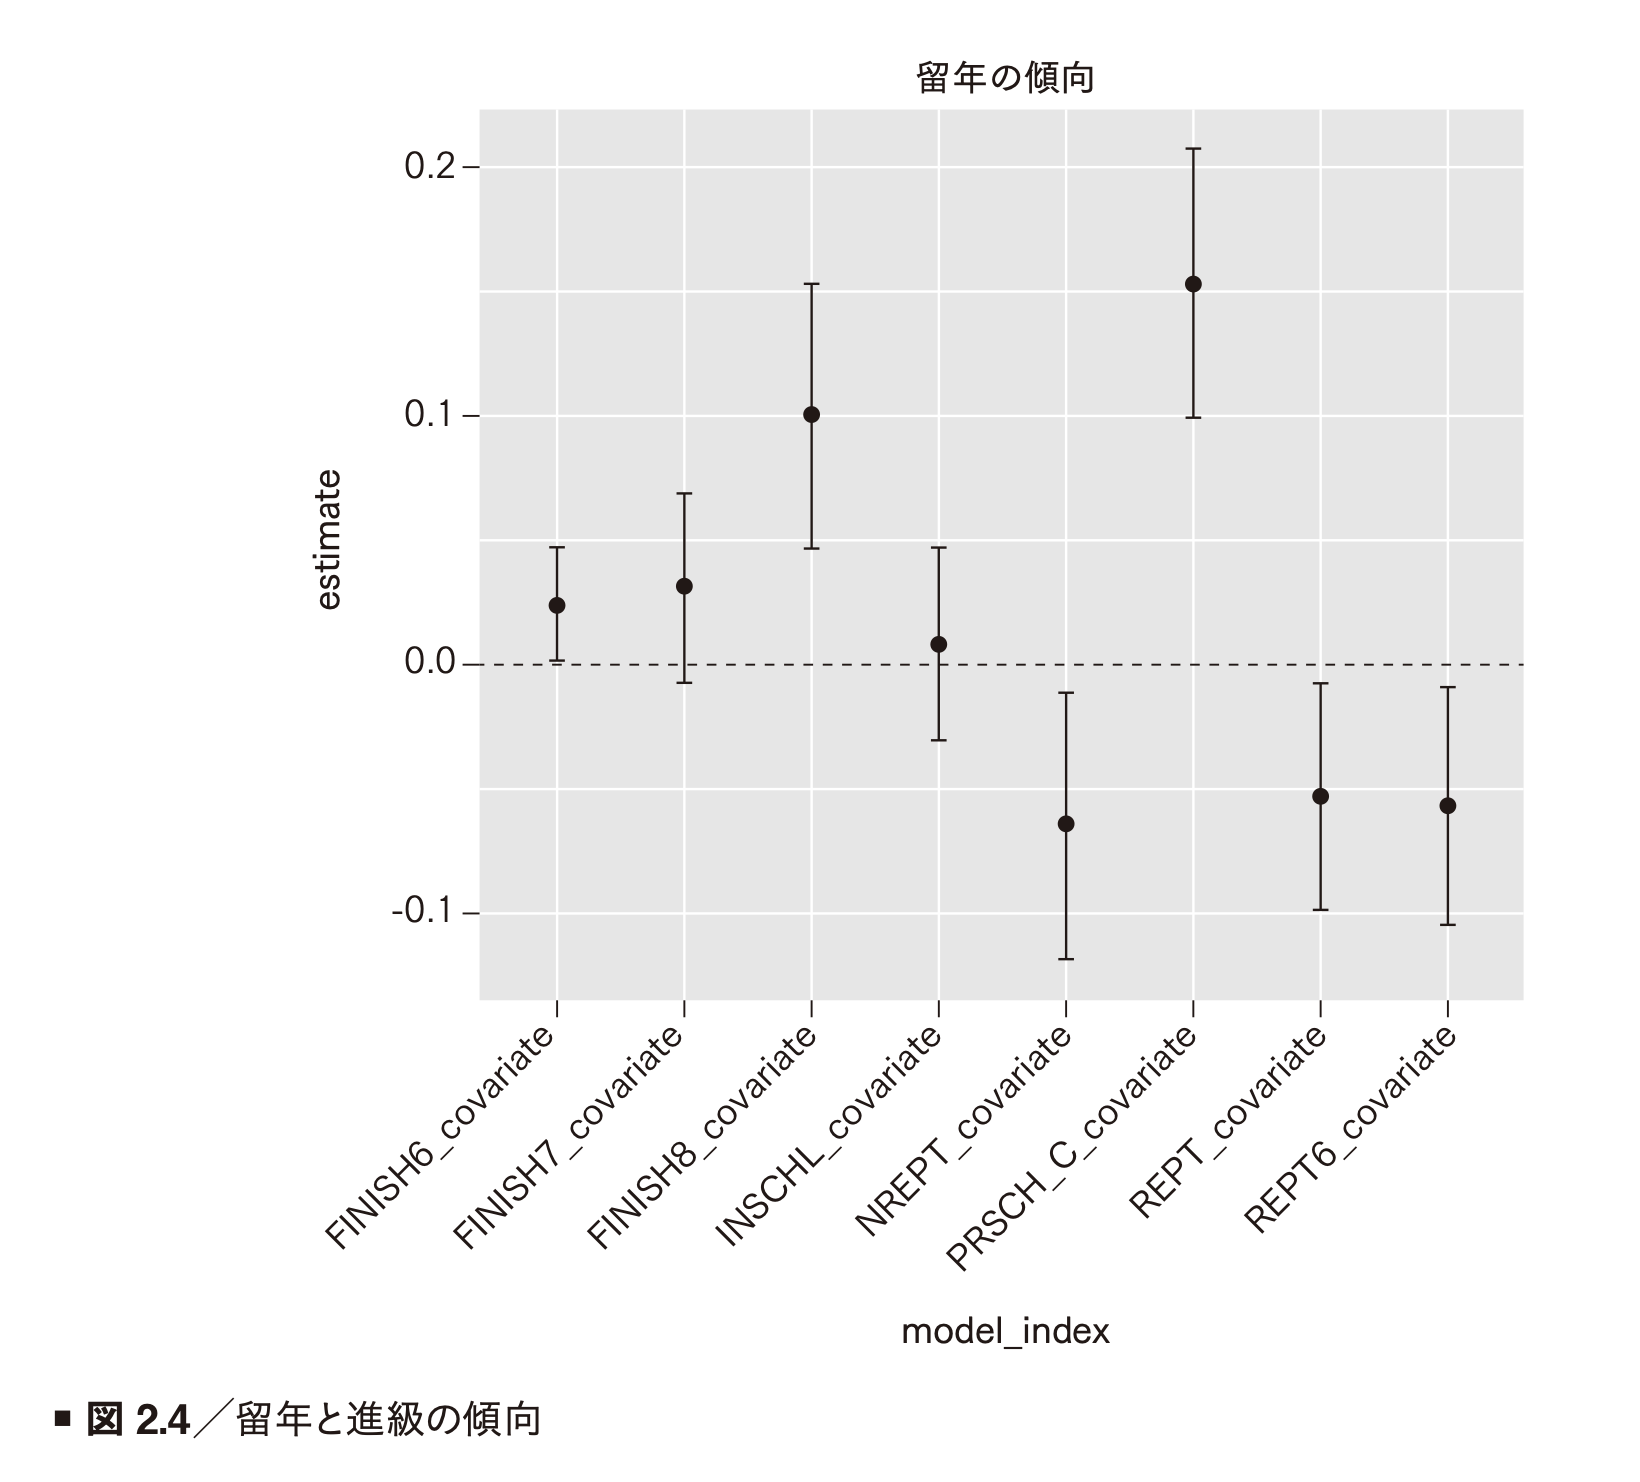
本ノートの実行結果を表にすると次の通りである(図2.4の数値の再現)。
| 目的変数 | 意味 | estimate | 95%信頼区間 | p_value |
|---|---|---|---|---|
| PRSCH_C | 調査時点(3年後)も私立学校に通っているか | 0.153 | [0.099, 0.208] | 0.0000 |
| INSCHL | 私立公立を問わず学校に通っているか | 0.007 | [-0.033, 0.047] | 0.734 |
| REPT6 | 6年生で留年したか | -0.059 | [-0.108, -0.011] | 0.016 |
| REPT | 調査までに一度でも留年したか | -0.055 | [-0.101, -0.009] | 0.020 |
| NREPT | 調査までの留年回数 | -0.067 | [-0.122, -0.012] | 0.017 |
| FINISH6 | 6年生を修了したか | 0.023 | [-0.001, 0.047] | 0.057 |
| FINISH7 | 7年生を修了したか | 0.031 | [-0.008, 0.070] | 0.121 |
| FINISH8 | 8年生を修了したか | 0.100 | [0.047, 0.153] | 0.0002 |
この表を図2.4と同じ形式で描いたものが次の図である。点が推定値、縦棒が95%信頼区間であり、縦棒が0の線をまたいでいなければ5%水準で有意である。
順を追って読む。
PRSCH_C の効果は約0.15であり、当選によって私立学校へ通い続ける生徒が15ポイント増えている。一方 INSCHL の信頼区間は0を含み、推定値も0.01と非常に小さい。つまり、当選によって「何らかの学校に通う」生徒が増えることはなかったが、「私立学校に通い続ける」生徒は増えた。
次に留年である。 REPT6 の推定効果は であり、当選グループでは6年生で留年する確率が6ポイント低い。 REPT と NREPT も有意に減少している。これらは、割引券のインセンティブ設計が想定通りに働いていることと整合する。
進級については、 FINISH6 の効果は2ポイント程度で有意ではなく、 FINISH7 も3ポイントで有意でないが、 FINISH8 は10ポイントで有意である。なぜ学年が上がるほど差が出るのか。6年生の修了は、たとえ一度留年してもその後に修了すればカウントされるので、差が出にくい。一方、調査までの3年間で一度でも留年すると8年生の修了は不可能になるので、差が出やすい。これらの結果は、割引券の当選が留年を減少させるという解釈を支持している。
ここまでの分析結果から、割引券の効果は「私立学校への通学を維持すること」と「留年しないようになること」であることが分かった。ただし注意が必要である。留年が減ったのは、インセンティブ設計のせいなのか、割引券によってより学費が高く教育の質が高い学校に通えたせいなのか、このデータでは区別できない。それを切り分けるには各生徒の学校選択のデータが必要だが、このデータセットには含まれていない。 回帰分析は「効果があったか」には答えられるが、「なぜ効果があったか」には、対応するデータがなければ答えられない 。
2.3.5 性別による効果差
ここまでの結果は、生徒の性別によって異なるだろうか。Angrist et al.(2002)のTable 4とTable 6を再現し、当選効果の性別差を分析する。男女でデータを分割し、それぞれで別々に回帰を行う。
data_tbl4 = regression_data.drop_nulls(
    ["SCYFNSH", "FINISH6", "PRSCHA_1", "REPT6", "NREPT", "INSCHL", "FINISH7",
     "PRSCH_C", "FINISH8", "PRSCHA_2", "TOTSCYRS", "REPT"]
)
df_female = run_many(data_tbl4.filter(pl.col("SEX2") == 0)).with_columns(pl.lit("female").alias("gender"))
df_male = run_many(data_tbl4.filter(pl.col("SEX2") == 1)).with_columns(pl.lit("male").alias("gender"))
df_gender = pl.concat([df_female, df_male]).filter(pl.col("model") == "covariate")
私立学校への入学と奨学金の利用
図2.5は、上が女子生徒、下が男子生徒の結果である。
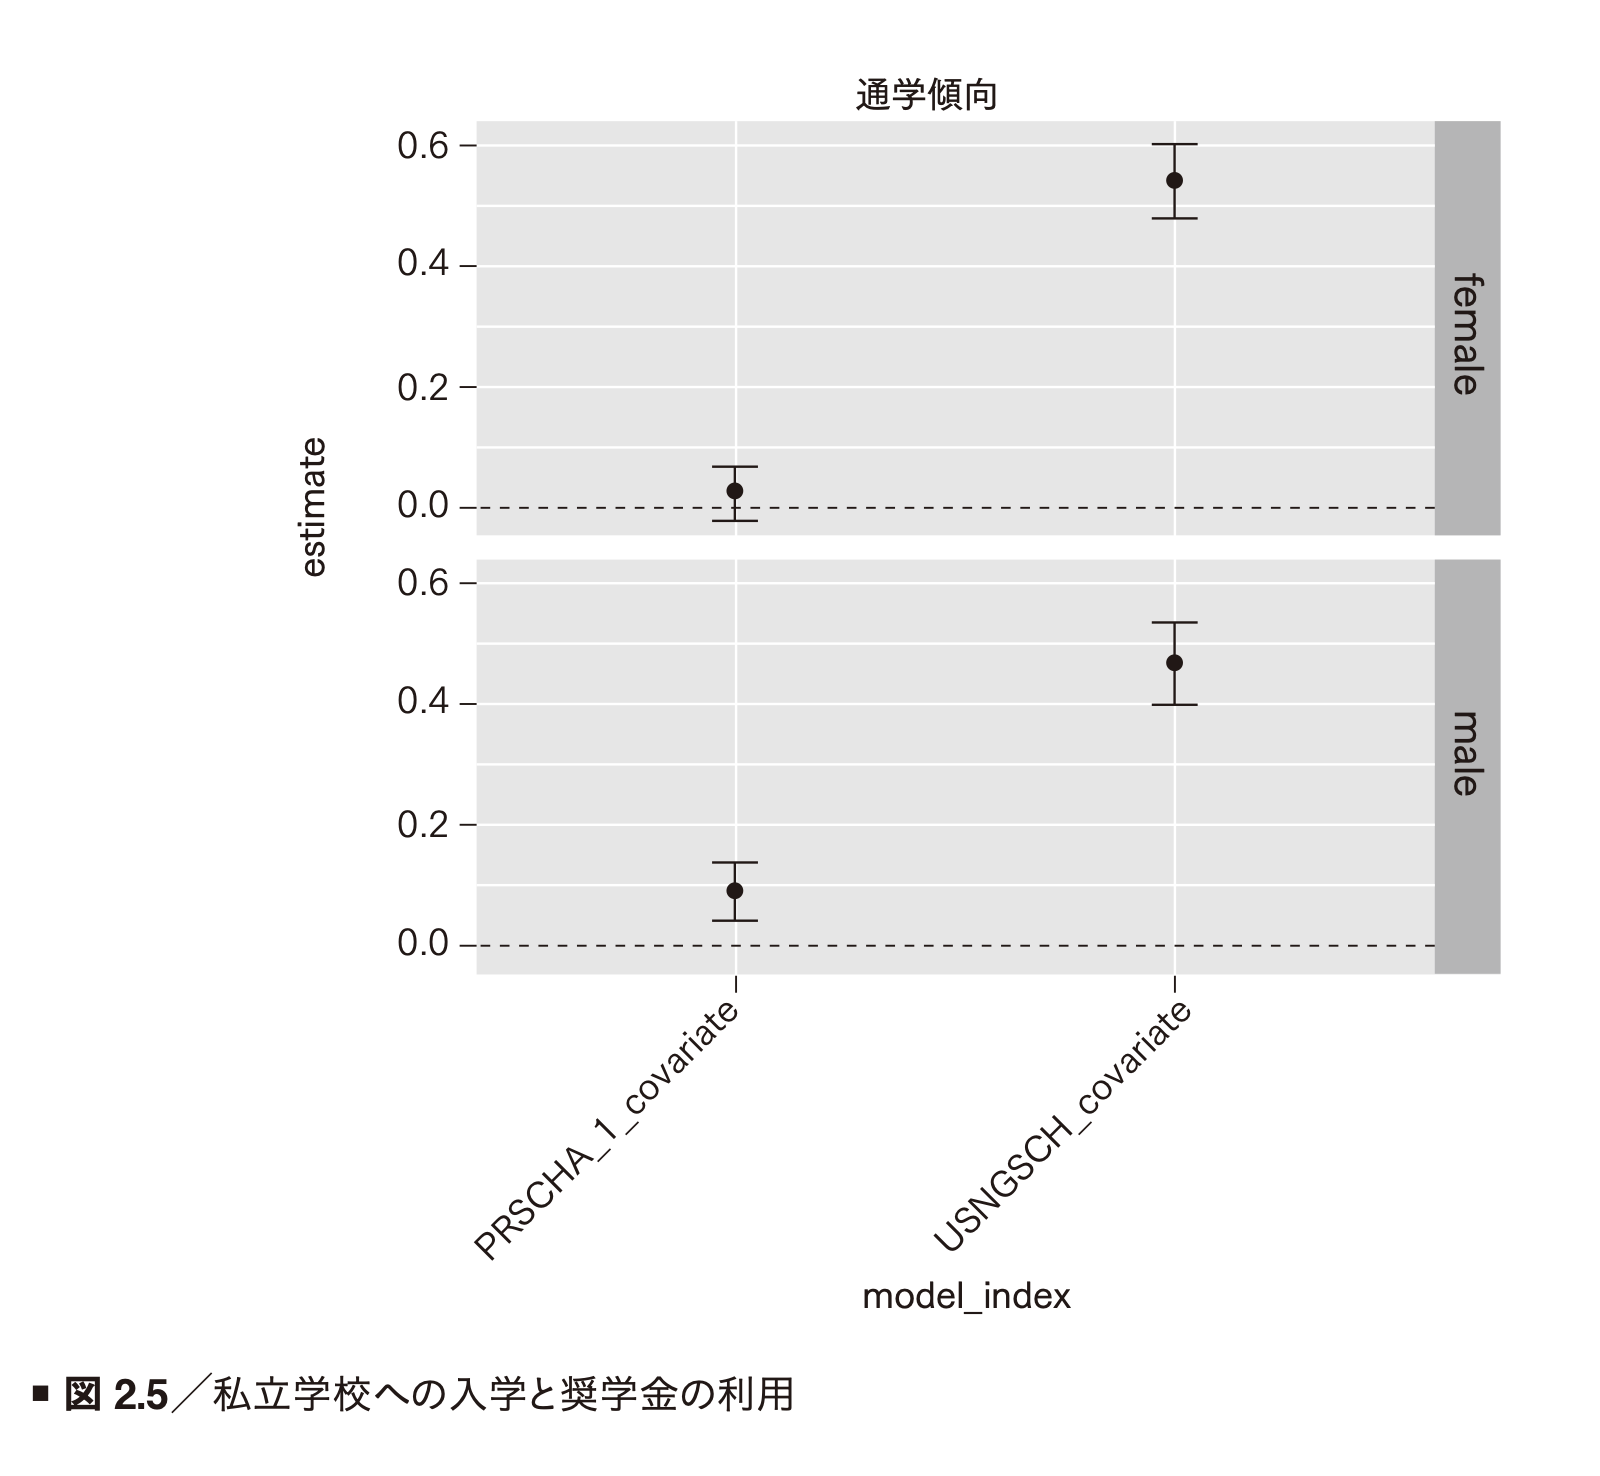
| 目的変数 | 女子 estimate | 女子 p_value | 男子 estimate | 男子 p_value |
|---|---|---|---|---|
| PRSCHA_1 | 0.023 | 0.316 | 0.090 | 0.0005 |
| USNGSCH | 0.544 | 0.0000 | 0.468 | 0.0000 |
PRSCHA_1 では、男子生徒は約9ポイントの有意な効果があり、当選によって私立学校へ通い始める傾向が強くなっている。一方、女子生徒は2ポイントで有意ではないので、「私立学校へ通わせる効果はない」という可能性を否定できない。仮に有意だったとしても効果量は男子の4分の1以下であり、性別によって効果が大きく異なる。
USNGSCH では、男子生徒は約47%、女子生徒は約54%の効果であり、女子生徒の方が当選した際に奨学金を利用する傾向が強い。
通学の継続と留年
次に私立学校へ通い続ける効果と留年への効果を見る(図2.6)。
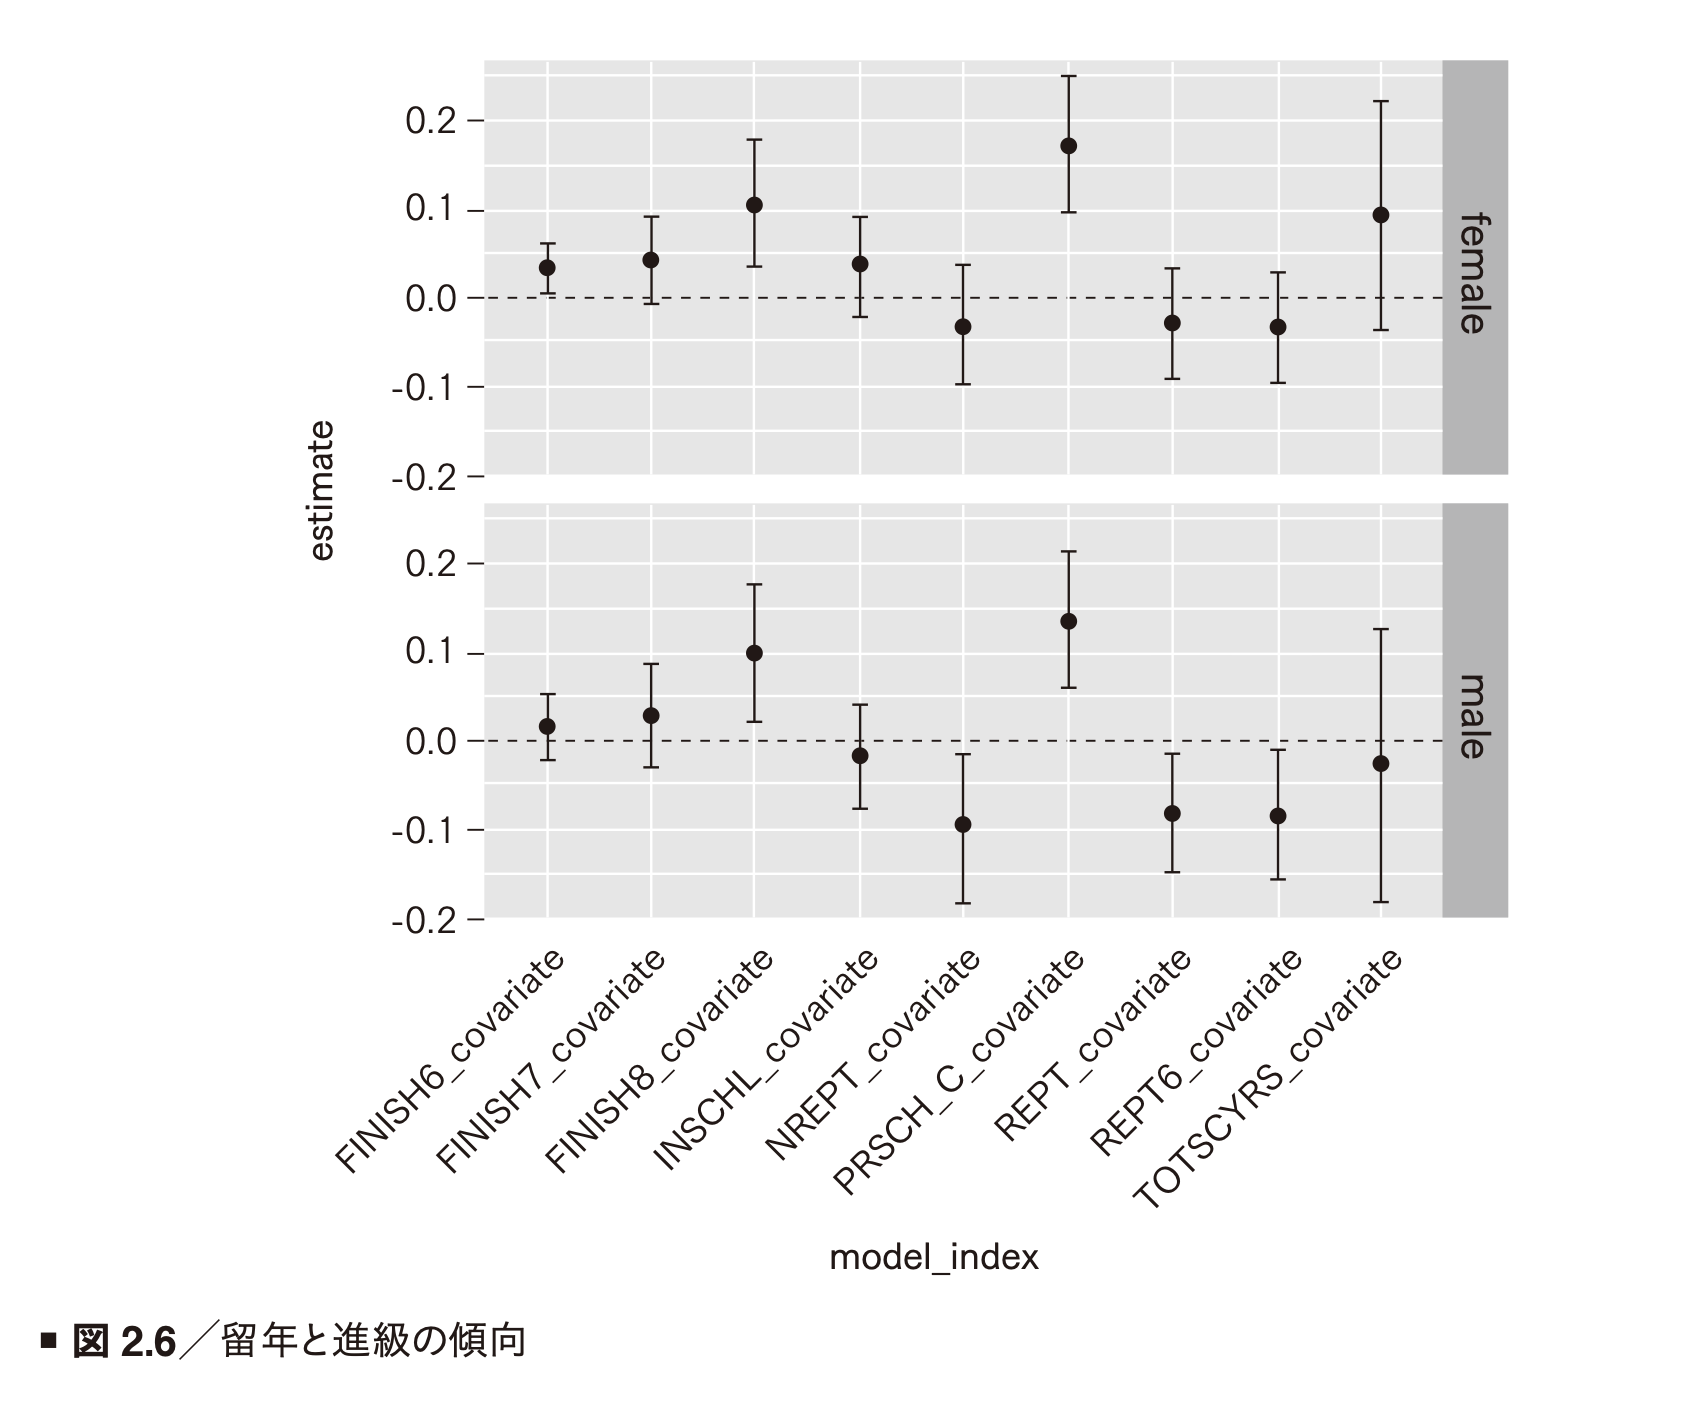
| 目的変数 | 女子 estimate | 女子 p_value | 男子 estimate | 男子 p_value |
|---|---|---|---|---|
| PRSCH_C | 0.171 | 0.0000 | 0.136 | 0.0007 |
| INSCHL | 0.035 | 0.220 | -0.020 | 0.513 |
| REPT6 | -0.036 | 0.253 | -0.087 | 0.025 |
| FINISH6 | 0.032 | 0.024 | 0.014 | 0.466 |
| FINISH7 | 0.041 | 0.107 | 0.026 | 0.390 |
| FINISH8 | 0.105 | 0.005 | 0.095 | 0.019 |
PRSCH_C の効果は男子13%、女子17%であり、私立学校への通学を続けさせる効果は女子の方が高い。 INSCHL は男女ともに有意な傾向がない。
REPT6 では、男子は当選グループで留年が8.7ポイント低く有意だが、女子は3.6ポイントの減少で有意ではない。男子には留年を減らす効果があるが、女子については効果がないことを否定できず、あったとしても男子より小さい。
FINISH6〜8 では、男子は8年生の修了を10ポイント増やす効果があり、6、7年生では有意差がない。女子は6年生の修了が3ポイント増え、8年生の修了は10ポイント増加している。女子も男子と同様に、より高い学年を修了できるようになっている。
男子の結果から描かれるストーリーは、全体のデータでの分析と変わらない。しかし女子の結果は大きく違う。 私立学校への通学を維持する効果は女子の方が高いのに、留年に対する効果はほぼない 。これは、女子生徒が私立学校へ通い続けられない原因が、学力や留年以外の要因にあることを示唆している。
一つの仮説は、女子生徒には家庭内の経済的リソースが分配されにくく、経済的なショックの影響を受けやすいというものである。急な所得減少が起きると、家庭内の男子よりも女子の方から公立への転校を迫られたり、労働によって家計を助けることを求められる可能性がある。この仮説が正しければ、割引券によって私立学校への通学が維持されるとともに、 労働時間の減少 が起きると予想される。
労働時間
労働時間 HOURSUM に対する結果を確認する(図2.7)。
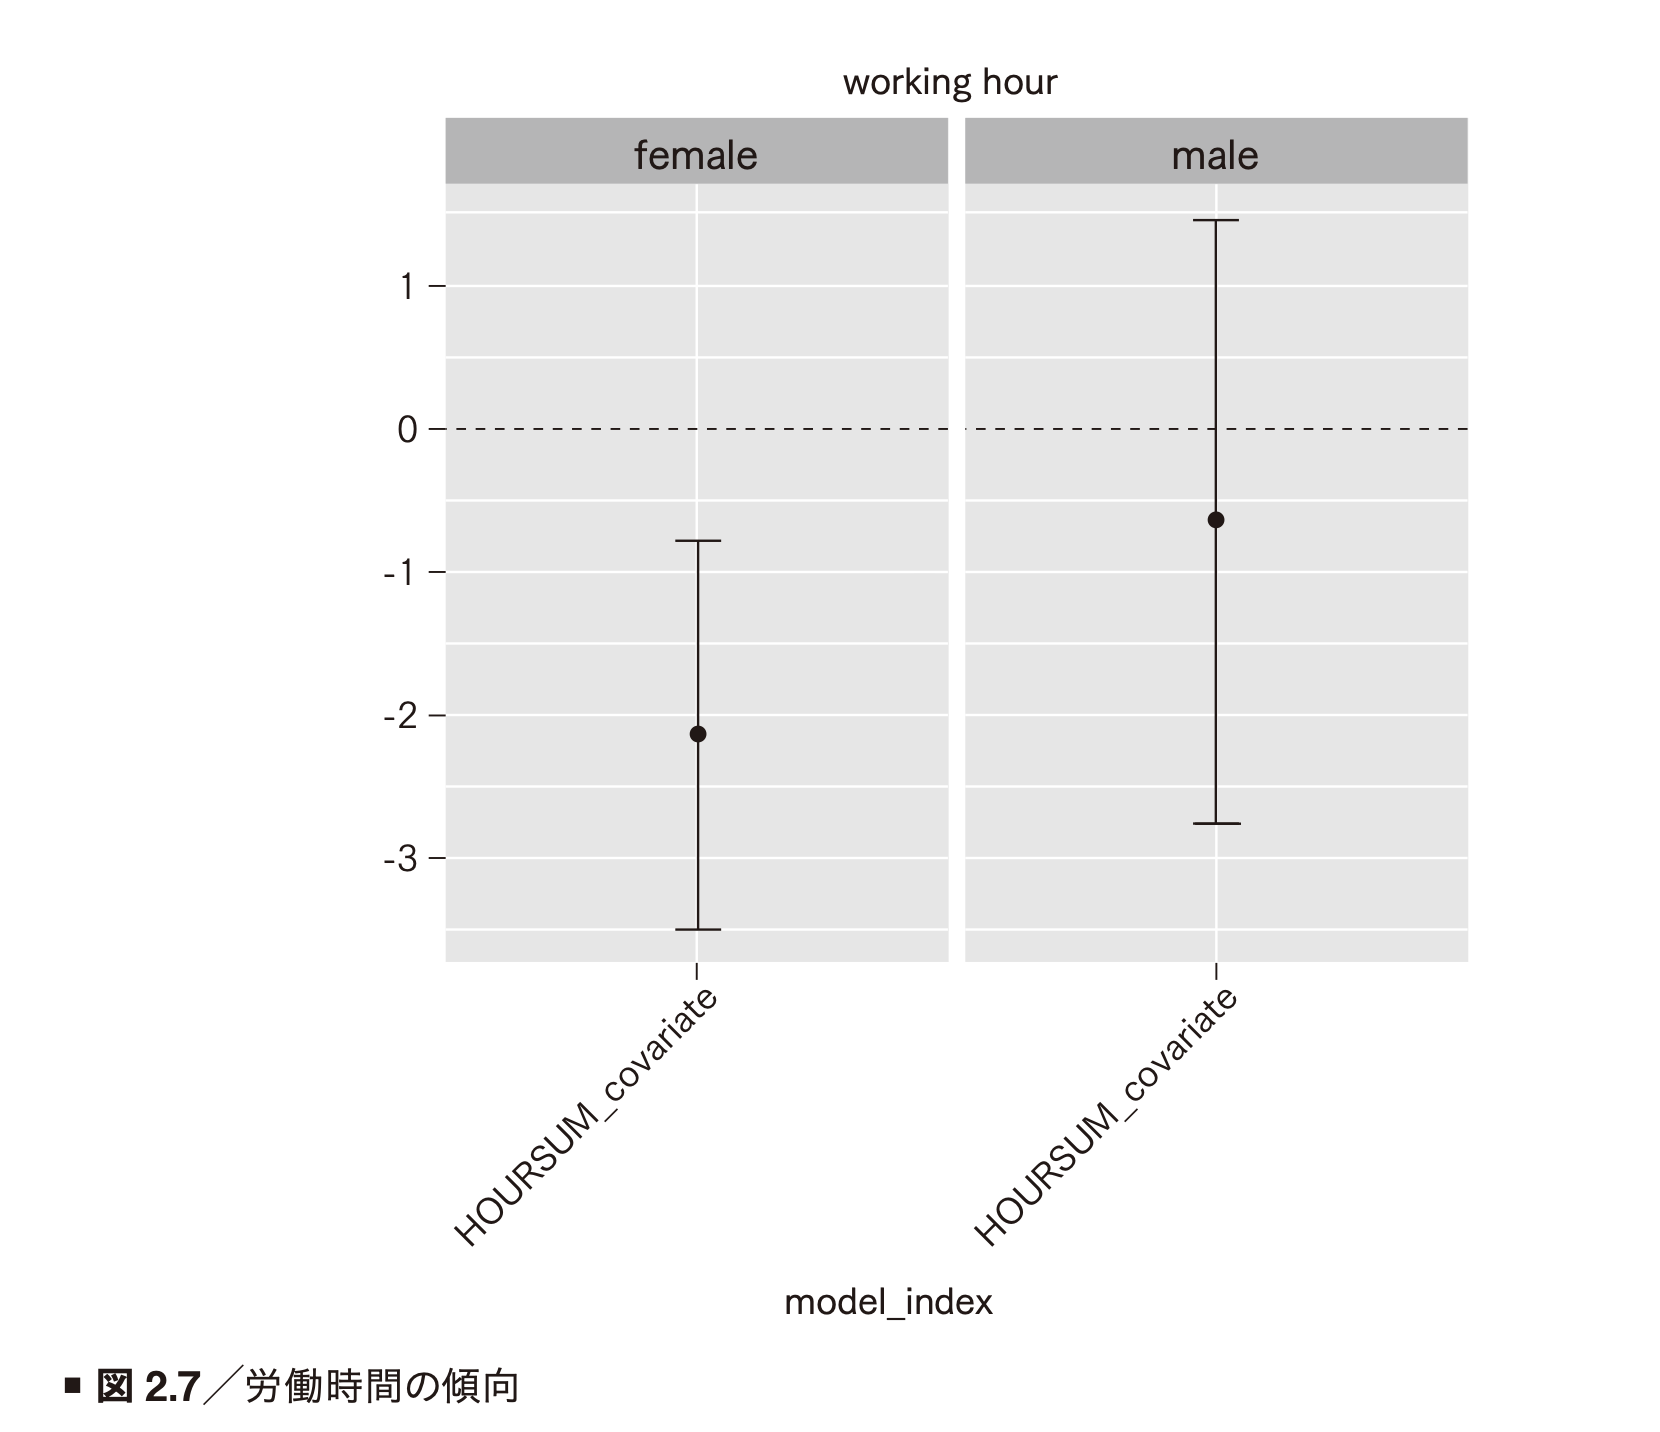
| 性別 | estimate(時間) | 95%信頼区間 | p_value |
|---|---|---|---|
| 女子 | -2.12 | [-3.47, -0.76] | 0.002 |
| 男子 | -0.64 | [-2.74, 1.47] | 0.553 |
男子生徒では0.6時間の減少で有意ではない。一方、女子生徒では2.1時間の減少であり、効果量が大きいうえに有意である。割引券によって経済的な問題がいくらか解決され、その結果として女子生徒が私立学校へ継続して通える状況になった、という解釈と整合している。
図2.5〜2.7の内容を、本ノートの推定値で一枚にまとめると次のようになる。女子(赤)と男子(青)を横に並べているので、どのアウトカムで男女の差が大きいかを見比べやすい。
2.3.6 分析のまとめ
この分析例では、一つのデータセットに対して一つの効果だけを検証するのではなく、さまざまな変数に対する効果を検証した。これにより、割引券という介入について次のことを確認した。
- そもそも利用されているか(USNGSCH)
- 私立学校への通学が維持されるか(PRSCH_C、INSCHL)
- 留年に影響するか(REPT6、REPT、NREPT、FINISH6〜8)
さらにデータを男女で分けることで、介入の作用が性別によって違う可能性も分かってきた。
ビジネスでも、教育のように複雑な事象に介入するケースは多い。そのような状況では、効果の大きさを推定するだけでなく、 それがどのようなしくみを通じて効果を発揮しているのかを考えること が重要である。ただし、このプロセスは「思いついた目的変数を何でも回帰にかけてみる」ことではない。割引券のしくみから仮説を立てたように、介入の事前知識から考え、必要と思った変数に対して順序立てて分析を行う必要がある。
Huluに置き換える:推薦施策の「しくみ」を追う
たとえば「新シーズン配信に合わせた上段トレイでの訴求」の効果を評価するとき、最終的なKPIである「7日以内の視聴」だけを見るのではなく、割引券の分析と同じ順序で複数のアウトカムを見ることができる。
| 問い | Huluでのアウトカム | 対応する割引券の分析 |
|---|---|---|
| 施策は届いたか | トレイの表示(インプレッション)率 | USNGSCH(利用されたか) |
| 直接の行動は変わったか | 当該作品の再生開始率、25%以上視聴率 | PRSCHA_1(通い始めたか) |
| 継続的な行動は変わったか | 2週目以降の同シリーズ視聴継続、次シーズンへの持ち越し | PRSCH_C(通い続けたか) |
| 副作用はあるか | 他作品の視聴が減ったか(共食い)、総視聴時間 | INSCHL(学校全体で見ると変わらない) |
| セグメントで違うか | 新規会員と継続会員、キッズプロフィール、デバイス別 | 性別による効果差 |
「訴求で当該作品の視聴は増えたが、総視聴時間は変わらなかった」という結果が出れば、それは他作品からの置き換えが起きたことを示唆する。「新規会員では効果が大きく、継続会員では小さい」という結果が出れば、対象の絞り込みに使える。このように、 介入がどの経路で効いたかを複数のアウトカムから推理する ことが、探索的な効果検証の目的である。
2.4 回帰分析に関するさまざまな議論
回帰分析は多くの統計分野で使われているため、その妥当性についてはさまざまな視点からの意見がある。しかし多くの場合、他の分野で重視される性質を満たすことと、因果効果を推定することは両立しない。なぜ他の分野で要求される性質を重視しないのかを理解しておくことは、実務で非常に重要である。
2.4.1 予測と効果推定
分析の現場では、「目的変数に対する予測能力の低いモデルは、効果検証としても価値がない」という議論がよく発生する。機械学習のように予測を目的とする分野では、予測能力がモデル評価の中心であり、この視点は自然である。
しかし本章の回帰分析では、予測能力やデータへの説明力を一切考慮しなかった。理由は、 「モデルの説明力や予測能力を高めることが、効果検証において有用であるという保証にはならない」 からである。
具体例で考える。RCTを行ったデータで介入変数だけを入れて回帰すれば、バイアスが非常に小さい効果の推定値が得られる。しかしこのモデルは2種類の予測値しか出力できないので、
に対する予測能力は非常に低い。RCTデータでの
spend ~ treatment
の決定係数は0.1%にも届かない。それでも、このモデルの treatment
の係数は、望みうる中で最も信頼できる効果の推定値である。
OVBの式に戻れば、この点はさらに明確になる。介入変数と結果変数の両方に相関する変数を含めれば、より正確な効果が得られる。しかし、単に の予測を改善する変数を追加しても、その変数が と無相関なら、効果の推定値は改善しない。したがって、「予測能力が一定以上なければ効果検証としてのモデルの価値がない」という批判は、本質を突いたものではない。
Huluで言えば、「この人がコナンを見るか」を高精度に予測するモデル(AUCが高いモデル)を作ることと、「訴求の効果」を正しく推定することは別の仕事である。前者では作品の人気度や曜日といった変数が強力だが、後者ではそれらが訴求の割り当てと無関係なら入れる意味がない。逆に、後者で不可欠な「訴求ルールに使った変数」は、前者では他の変数と冗長かもしれない。
2.4.2 制限被説明変数(Limited Dependent Variable)
予測や説明力を重視する分野では、 の分布に適したモデルを選ぶことが行われる。 が「購入したか否か」のような0/1の値なら ロジスティック回帰 、売上のような0以上の整数値なら ポアソン回帰 を選ぶ、といった操作である。このように目的変数が特定の値しか取らない状態を 制限被説明変数(Limited Dependent Variable) と呼ぶ。
本書では、制限被説明変数の場合でもロジスティック回帰やポアソン回帰を使わず、線形回帰で分析する。これを正当化する理由は、 介入変数 が0か1しか取らないバイナリ変数の場合しか扱わない 点にある。この場合、 がどのようなデータであっても、 と の関係は2点を結ぶ直線で必ず表せる。
Huluの主なアウトカムである「視聴したか(0/1)」はまさに制限被説明変数である。それでも、訴求の有無が0/1なら線形回帰で問題ない。得られる は「視聴確率が何ポイント変わったか」という、そのまま解釈できる量である。ロジスティック回帰だと係数がオッズ比の対数になり、効果をポイントで言うためには追加の変換が必要になる。効果検証では、解釈のしやすさの点でも線形回帰に利点がある。
ただし注意が必要な場合もある。介入変数 が連続値(たとえば「訴求した回数」や「値引き額」)であり、 と非線形な関係を持つ場合、効果の関数を無理やり線形で表すことになる。この場合、線形回帰での効果分析の妥当性は保証されない。
2.4.3 対数を利用した回帰分析
回帰分析では、目的変数や共変量の自然対数( )を取った値を使うことがある。効果分析でも同様である。
- 目的変数の対数を取る場合 、係数の解釈は「 に対して何%の影響があったか」になる。
- 説明変数 の対数を取る場合 、係数の解釈は「 を1%変化させたとき、 にどれだけ影響するか」になる。
これは、対数の差が変化の割合を近似することを利用している。
ワークド例:近似の精度を確かめる
、 (10%の増加)のとき、 であり、変化率0.10とほぼ等しい。一方、 (50%の増加)では となり、0.50からずれが大きくなる。 対数の差による近似は、変化率が小さいときに正確である 。介入効果が数%〜十数%の範囲なら問題ないが、効果が数倍になるような場合は で正確な変化率に戻すべきである。
次のモデルで解釈を確認する。
- なら、介入された場合に目的変数が平均的に約10%高い。
- なら、 が1%増加したときに目的変数が約0.01%増加する。
- なら、 が1増加したときに目的変数が約10%高くなる。
本書の分析で対数を取る理由は二つに絞られる。一つは、 目的変数に対する介入の効果が比率で扱われるべきとき である。たとえばHuluで「訴求が総視聴時間を増やすか」を見る場合、月100時間見るヘビーユーザと月2時間のライトユーザに同じ「+30分」を期待するのは不自然で、「+5%」のように比率で考える方が自然なことが多い。もう一つは、 共変量と目的変数の関係が比率で扱われるべきとき である。本来は比率で影響する共変量を線形のまま入れると、共変量の関数の形が誤っているために、セレクションバイアスが残る可能性がある。
なお、視聴時間のように0を多く含む変数に対数を取るときは、 が定義できないため工夫が必要である。 とすることが慣習的に行われるが、この変換は比率の解釈をゆがめる。0/1の視聴有無をアウトカムにするか、0を含めた線形モデルで効果を「分」で解釈する方が、無理がないことも多い。
2.4.4 多重共線性
一つのモデルから複数の変数の情報を得ることを目的に回帰を使うとき、変数同士の相関に多くの配慮がなされる。 多重共線性 とは、回帰モデルに含まれる変数のうち二つが強い相関を持つ状況を指す。この場合、推定されるパラメータの標準誤差が大きくなり、検定の結果が歪む。
推定値の分散の式を見ると、その仕組みが分かる。
は、変数 を他の説明変数すべてで回帰したときの決定係数であり、「変数 が他の変数でどれだけ説明できるか」を表す。完全に連動する変数は になり、分母が0に近づいて分散が非常に大きくなる。
ワークド例:分散の膨らみ方
他の変数と無相関( )の場合を基準にする。
| 標準誤差の倍率 | ||
|---|---|---|
| 0 | 1 | 1.00 |
| 0.5 | 2 | 1.41 |
| 0.9 | 10 | 3.16 |
| 0.99 | 100 | 10.00 |
なら分散は10倍、標準誤差は 倍になる。信頼区間の幅も3倍以上に広がるので、本当は効果があっても有意にならなくなる。
この倍率を の関数として描くと、0.9を超えたあたりから急激に立ち上がることが分かる。
重要なのは、 多重共線性は関連の強い変数以外には影響を与えない という点である。したがって、介入変数以外の共変量同士で多重共線性が起きていても、興味のある には影響がない。共変量の係数は解釈しないので、その標準誤差が大きくても問題にならない。一方、 介入変数と強く相関する共変量がある場合は の標準誤差が大きくなる ので、注意が必要である。
Huluでこれが起きるのは、たとえば訴求のルールが「過去90日のアニメ視聴日数が30日以上」というしきい値だけで決まっていて、その視聴日数を共変量にも入れる場合である。 が からほぼ決まってしまうと、 と の相関が非常に高くなり、 の標準誤差が大きくなる。この状況は「 が同じ人の中で が異なる人がほとんどいない」ということでもあり、次節の分散重み付けの話とつながる。そして、しきい値で介入が決まる状況を積極的に利用する手法が、第5章の回帰不連続デザインである。
2.4.5 パラメータの計算:回帰係数は「誰の効果」を表しているのか
回帰で推定されたパラメータは、どのような過程を経て算出されているのだろうか。この過程を理解すると、 どのようなデータが推定結果に大きな影響を与えるのか が分かる。また、さまざまな手法の推定結果を比較する際にも重要になる。
残差を使った表現(FWL定理)
重回帰における介入変数の係数 は、次のように書ける。
ここで は、介入変数 を他の共変量で回帰したときの残差である。
つまり は、 のうち 共変量では説明できない部分 だけを残したものである。この残差と の共分散を、残差の分散で割った値が重回帰の になる。この事実はFrisch–Waugh–Lovell(FWL)定理と呼ばれ、重回帰の最小化問題を解くことで導出できる。
直観的には、重回帰は次の2段階を一度に行っている。まず「共変量から予測できる分の介入」を取り除き、次に「予測できなかった分の介入( )」と の関係を単回帰で見る。共変量で完全に決まってしまう人( )は、2段階目に何も寄与しない。
Pythonで確かめる。
first_stage = ols(biased_df, "treatment", ["recency", "channel", "history"])
eps = first_stage.residuals
y = biased_df.select("spend").to_numpy().ravel()
beta_fwl = np.cov(y, eps, bias=True)[0, 1] / np.var(eps)
print(beta_fwl)   # 0.818992 = 重回帰の treatment 係数
結果は0.818992であり、重回帰
spend ~ treatment + recency + channel + history の
treatment の係数と完全に一致する。
飽和モデルでの重み付け平均
共変量がすべて0/1のダミー変数で表され、その組み合わせごとに別々の平均を許すモデルを 飽和モデル(saturated model) と呼ぶ。このとき、上の式は次の形に変形できる。
この式の読み方は次の通りである。 は「共変量が の人たちの中での、介入ありとなしの平均の差」、つまり層ごとの効果である。 は、 層ごとの効果を、その層の介入変数の分散 で重み付けして平均したもの に等しい。
介入変数の分散は なので、 のとき最大の0.25になり、0または1のときは0になる。
重みの形と、それが回帰係数にどう影響するかは、次のワークド例のあとに図で確認する。
したがって、 介入グループと非介入グループの割合が50:50に近い層が、回帰の結果にもっとも影響を与える 。一方、どちらか一方しか含まれない層は推定結果にほぼ影響しない。直観的には、回帰分析は「与えられたデータの中で、より適正な比較が行われていそうな層」の差を効果としてとらえている。
ワークド例:層ごとに効果が違うと、回帰係数はATEとずれる
Huluの架空データで確かめる。共変量 は「ヘビーユーザか(1/0)」、 は訴求の有無、 は7日間の視聴分数とする。
| 層 | 人数 | 訴求された人数 | 層内の効果 | ||
|---|---|---|---|---|---|
| ヘビーユーザ( ) | 10 | 5 | 0.5 | 0.25 | +10分 |
| ライトユーザ( ) | 10 | 1 | 0.1 | 0.09 | +30分 |
ヘビーユーザは訴求がなくてもたくさん見るので効果は小さく(+10分)、ライトユーザは訴求で初めて見るので効果が大きい(+30分)とする。人数は同じなので、 ATE(全員の平均効果)は 分 である。
一方、回帰 minutes ~ recommended + heavy_user
の係数は、分散で重み付けした平均になる。
Pythonでこのデータを作って回帰すると、係数は15.2941となり、手計算と一致する。ATEの20より小さい。 訴求が半々のヘビーユーザ層の効果(+10分)が強く反映され、訴求がほとんどないライトユーザ層の効果(+30分)は軽く扱われた からである。
これが、回帰分析の結果とRCTの結果が同一にならない一つの理由である。RCTでは、どの においても介入割合の期待値は0.5なので、すべての層の重みが等しくなり、回帰はATEを推定する。しかしRCTでないデータでは、介入割合が層によって異なるので、回帰は必ずしもATEを推定していない。ただし重要なのは、 これはセレクションバイアスがうまく取り除けていないという話ではない という点である。回帰分析が「妥当に比較できそうなサンプルに絞り込んで比較する」という特徴を持っていることが原因である。効果が層間で大きく変わらないなら、この問題は起きず、RCTと同じ結果が得られる。
手法ごとに「推定している効果」は違う
因果推論の手法の多くは、手持ちのデータに何らかの重みを付けて妥当な比較を行う構造になっている。どのような重みを使うかによって、どのような効果が推定されているかが異なる。回帰は で重み付けしたもの、第3章の傾向スコアマッチングは介入群の分布に合わせたもの(ATT)、逆確率重み付けは母集団全体に合わせたもの(ATE)というように、狙う効果が違う。したがって、複数の因果推論の方法を使った場合、それらが同じ値を返すことはほとんどない。値が違うからといって、どれかが間違っているとは限らない。
Huluの施策評価で言えば、「ヘビーユーザとライトユーザで訴求の効果が違う」ことが予想されるなら、回帰係数を一つ報告するだけでは不十分である。層別に効果を推定するか、次の追加手法の節で述べる交互作用を入れたモデルを使い、「誰に対する効果か」を明示する必要がある。
教科書にない追加手法:第2章を実務で強化する
第2章の回帰分析は基礎であり、実務では次のような拡張がよく使われる。ここでは、本ノートの例に適用した結果とともに紹介する。
1. 頑健な標準誤差とクラスタ標準誤差
Rの lm() や本ノートの ols()
の標準誤差は、誤差の分散がすべての人で同じ(等分散)という仮定に基づいている。しかし、購買額や視聴時間は「ほとんどの人が0で、一部の人が大きな値」という分布をしており、この仮定は明らかに満たされない。このとき
不均一分散に頑健な標準誤差(heteroskedasticity-robust standard
errors、HC)
を使う。係数の推定値は変わらず、標準誤差だけが修正される。
真ん中の項が各人の残差の2乗で重み付けされているため、ばらつきの大きい人がいればそれが標準誤差に反映される。HC1と呼ばれる版はこれに の小標本補正を掛けたものである。バイアスのあるデータの重回帰に適用すると、次のようになる。
| term | estimate | 等分散の標準誤差 | HC1 標準誤差 |
|---|---|---|---|
| treatment | 0.819 | 0.182 | 0.173 |
| history | 0.00150 | 0.00038 | 0.00056 |
この例では treatment の標準誤差はわずかに小さくなり、history は約1.5倍に大きくなった。どちらの方向に動くかはデータ次第なので、 効果検証では頑健標準誤差を既定にしておくのが安全である 。
さらにHuluで重要なのが クラスタ標準誤差 である。第1章で述べた通り、施策の割り当てがアカウント単位で行われ、分析がプロフィール単位で行われる場合、同じアカウントのプロフィール同士は独立ではない。この場合、アカウントをクラスタとして誤差の相関を許す標準誤差を使う必要がある。上の式の真ん中の項を、個人ごとではなくクラスタごとにまとめた に置き換えればよい。クラスタを無視すると、標準誤差を過小に見積もり、効果を過信することになる。
2. 交互作用つき回帰(Lin, 2013):RCTでの回帰調整
RCTデータに共変量を加えた回帰は、第1章のCUPEDと同じく分散削減の手段として使える。ただし、共変量を単に足すだけの回帰は、介入群と対照群で共変量の効き方が違うときに、わずかに偏ることが知られている。Lin(2013)は、 共変量を中心化し、介入変数との交互作用項をすべて加える ことで、この問題を解決しつつ分散も減らせることを示した。
共変量を中心化しているので、 は「共変量が平均的な人」ではなく「全員の平均」の効果として解釈できる。バイアスのあるデータに適用すると、treatment の係数は0.826(標準誤差0.182)であり、交互作用なしの0.819とほぼ同じであった。交互作用項はいずれも有意でなく、この例では効果の異質性は小さい。
Huluで新モデルのA/Bテストの結果を分析するときは、この形の回帰を使えば、CUPEDと同等の分散削減を、複数の事前共変量に対して一度に行える。
3. 感度分析の定量化:Robustness Value
2.2.6で述べた感度分析は「共変量を出し入れして結果が動くか見る」という定性的なものであった。Cinelli and Hazlett(2020)は、 観測されていない交絡がどれだけ強ければ、推定された効果が消えてしまうか を一つの数値で表す Robustness Value(RV) を提案した。
介入変数のt値を 、自由度を として を計算すると、RVは次で与えられる。
RVの意味は、「観測されていない交絡因子が、介入変数の残差分散と結果変数の残差分散の両方をRVの割合だけ説明するとき、推定値はちょうど0になる」というものである。バイアスのあるデータの重回帰では、treatment のt値は4.492、自由度は31,919であり、RVは0.0248であった。
つまり、 介入と結果の両方について、残差の分散の約2.5%を説明するような未観測の交絡があれば、メールの効果はゼロと区別できなくなる 。これは小さい値である。実際、この例では history という交絡因子ひとつを外しただけで推定値が0.04動いたので、まだ入れていない変数に対して脆弱であることと整合している。RVは「結果が頑健だ」と言うための基準を、分析者の主観からある程度切り離してくれる。
Oster(2019)の手法も、同じ目的で使われる。共変量を追加したときの係数の動きと決定係数の動きから、「未観測の変数が観測された変数と同程度に重要だとしたら、係数はどこまで動くか」を計算する。
4. DAGによる共変量の選び方:交絡因子・中間変数・合流点
2.2.7のPost Treatment Biasは、「介入の後に決まる変数を入れてはいけない」というルールで整理された。因果ダイアグラム(DAG)を使うと、このルールをより一般的に理解できる。変数の役割は三つに分けられる。
X → Z, X → Y
介入の決定と結果の両方に影響する。過去のアニメ視聴日数。
Z → M → Y
介入が結果に届く経路の途中。来訪(visit)、トレイのクリック。
Z → C ← Y
介入と結果の両方から影響を受ける。「調査に回答したか」「継続契約したか」。
- 交絡因子 は と の両方の原因である。これを入れることでOVBが消える。
- 中間変数(mediator) は が に影響する経路の途中にある。これを入れると、その経路を通る効果が消えてしまい、効果が過小に推定される。visit はこれである。
- 合流点(collider) は と の両方から影響を受ける変数である。これで条件付けると、もともと無関係だった と の間に見せかけの関係が生まれる。「調査に回答したか」「アプリを起動したか」でデータを絞ることは、合流点での条件付けに当たる。
DAGの バックドア基準 は、「 から への直接の経路以外の(裏口の)経路をすべて遮断し、かつ の子孫を含まない変数集合」で条件付ければよいと教える。Post Treatment Biasの回避ルールは、この「 の子孫を含まない」に対応する。Huluの施策評価で共変量を決めるときは、変数ごとに「これは訴求の原因か、訴求の結果か」を問い、結果であれば除外する、という手順を機械的に適用できる。
5. Double/Debiased Machine Learning(DML)
FWL定理は、 が「 を で予測した残差」と「 」の関係で決まることを示した。ここで「 で予測する」部分を線形回帰ではなく、勾配ブースティングやニューラルネットのような機械学習モデルに置き換えたものが Double/Debiased Machine Learning(Chernozhukov et al., 2018) である。
は から を予測するモデル、 は から を予測するモデルである。過学習による偏りを避けるために、データを分割して予測モデルの学習と残差の計算を別々のデータで行う(cross-fitting)。
この手法の利点は、2.1.2で述べた「共変量の関数の形を分析者が決める」という難所を、機械学習に任せられる点である。Huluのように共変量が数百次元あり(視聴ジャンル分布、デバイス、曜日別の視聴パターンなど)、しきい値やルールの組み合わせで訴求が決まる場合、線形の関数形は明らかに不十分である。DMLはその非線形性を吸収しつつ、 の推定値には通常の回帰と同じように標準誤差と信頼区間を与えてくれる。PythonではDoubleMLやEconMLといったライブラリで実装できる。ただし、CIAが必要であることは線形回帰と変わらない。DMLは「関数形の誤り」を直すが、「必要な変数がない」問題は直せない。
6. 効果の異質性:サンプル分割よりも交互作用項
2.3.5では男女でデータを分割して別々に回帰した。この方法は分かりやすいが、「男女で効果が違う」ことを直接検定してはいない。女子で有意、男子で有意でないという結果は、男女の効果差が有意であることを意味しない。効果差を検定するには、 一つの回帰に性別と介入の交互作用項を入れる 。
が性別(男子=1)なら、 は女子への効果、 は男子への効果、 がその差である。HOURSUM にこのモデルを適用すると、次の結果になった。
| term | estimate | std_error | p_value |
|---|---|---|---|
| VOUCH0(女子への効果) | -1.85 | 0.90 | 0.040 |
| VOUCH0 × SEX2(男女差) | 1.25 | 1.26 | 0.321 |
女子への効果は有意に負だが、男女差 時間の標準誤差は1.26と大きく、有意ではない。つまり、 「女子では効果があり男子ではない」というストーリーは、データと整合するものの、男女差そのものが統計的に確立されたわけではない 。分割分析だけを見ていると、この点を見落としやすい。
より多くのセグメントで効果の違いを探索したい場合、Causal Forest(Wager and Athey, 2018)のように、効果の異質性を直接学習する手法もある。Huluで「どのユーザ層に訴求すると効果が大きいか」を知りたい場合、これは「誰に推薦するか」というターゲティングの問題に直結する。
7. 多くのアウトカムを見るときの多重比較
2.3では15個のアウトカムそれぞれに回帰を行った。有意水準5%の検定を15回行えば、効果がまったくなくても、少なくとも一つが有意になる確率は に達する。探索的な分析で「有意な結果」を見つけたとき、その一部は偶然である可能性が高い。
対策は二つある。一つは、 主要なアウトカムを事前に一つか二つに決めておき、残りは補助的な位置づけにする ことである。もう一つは、Benjamini–Hochberg法のような 偽発見率(FDR)の制御 を使い、多数の検定の中で「有意」と判定するしきい値を調整することである。2.3.6で「思いついた目的変数を何でも回帰にかけない」と述べたのは、この問題の実務的な対処でもある。Huluで施策評価のダッシュボードに数十個のKPIが並ぶとき、その中の一つが有意に動いたことを施策の成果として報告する前に、この計算を思い出す必要がある。
Huluの推薦施策を回帰で評価する設計
最後に、本章の内容をHuluの実務に落とし込む。RCTが行われなかった施策の効果を、視聴ログから回帰で推定する手順を整理する。
誰が、どの情報を使って訴求対象を決めたかを書き出す。
ルールに使われた変数を、介入日より前のログだけから集計する。
対象者全員を分母にする。頑健・クラスタ標準誤差を使う。
共変量の出し入れ、Robustness Value、層別の効果。
設計例:新シーズン訴求の効果
問い :2026年7月1日に『名探偵コナン』新シーズンの配信が始まり、同日から「過去90日にアニメを3日以上視聴したプロフィール」に対してホーム上段トレイで訴求した。この訴求は、7月1日から7日間の新シーズン視聴率(25%以上視聴)をどれだけ上げたか。
変数の定義 :
| 役割 | 変数 | 作り方 | 参照テーブル |
|---|---|---|---|
| 7日以内の新シーズン視聴(0/1) | 7月1〜7日に当該 series_id を25%以上視聴 |
report.unique_viewed_series |
|
| 訴求対象(0/1) | 訴求ルールの判定結果。表示されたかではなく、対象に選ばれたか | 施策側の割当台帳 | |
| 過去90日のアニメ視聴日数 | 4月2日〜6月30日の primary_genre = "animation"
の視聴日数 |
report.content_viewing |
|
| 過去90日の総視聴秒数 | 同期間の watched_seconds の合計 |
report.content_viewing |
|
| 過去にコナンを視聴したか | 6月30日以前の last_viewing_date |
report.unique_viewed_series |
|
| 契約からの月数、会員ステータス | contracted_at、status_id |
master.zeus_account_subscriptions_YYYYMMDD |
|
| オーナープロフィールか、キッズか | is_owner、is_kids |
master.gene_profiles_YYYYMMDD、personalize.daily_personalize_viewing_kpi |
ここで注意すべき点をまとめる。
- 介入変数は「訴求対象に選ばれたか」であり、「トレイが表示されたか」ではない。 表示は「ホームを開いたか」という介入後の行動に依存するので、表示で定義すると Post Treatment Bias が入る。第1章で述べたITT(割当ベースの分析)の考え方である。
- 共変量は介入日(7月1日)より前のログだけで作る。 7月1日以降のセッション数やクリックは、たとえ と強く相関していても使わない。
- 訴求ルールに使った変数(アニメ視聴日数)は必ず入れ、ルールのしきい値付近の非線形性を吸収するために、視聴日数の区分ダミーや2乗項も検討する。 ルールがしきい値だけで決まっているなら、 が同じで が異なる人はほとんどおらず、回帰は事実上「しきい値付近の人」の比較になる(2.4.5)。その場合は第5章の回帰不連続デザインの方が適している。
- 分母は訴求対象になり得たプロフィール全員である。 視聴ログに現れた人だけで分析すると、「アプリを開いた人」という合流点で条件付けることになる。
Polarsでの分析表の作成 (概略):
pre = pl.date(2026, 4, 2), pl.date(2026, 6, 30)
post = pl.date(2026, 7, 1), pl.date(2026, 7, 7)

covariates_df = (
    content_viewing.filter(pl.col("date").is_between(*pre))
    .group_by("profile_id")
    .agg(
        pl.col("date").filter(pl.col("primary_genre") == "animation").n_unique().alias("anime_days_90d"),
        pl.col("watched_seconds").sum().alias("watch_sec_90d"),
    )
)
outcome_df = (
    unique_viewed_series.filter(
        (pl.col("series_id") == CONAN_SERIES_ID)
        & pl.col("last_viewing_date").is_between(*post)
    )
    .select("profile_id").unique()
    .with_columns(pl.lit(1).alias("watched_7d"))
)
analysis = (
    assignment_ledger                      # 訴求対象になり得た全プロフィールと Z
    .join(covariates_df, on="profile_id", how="left")
    .join(outcome_df, on="profile_id", how="left")
    .with_columns(
        pl.col("anime_days_90d").fill_null(0),
        pl.col("watch_sec_90d").fill_null(0),
        pl.col("watched_7d").fill_null(0),
        (pl.col("watch_sec_90d") + 1).log().alias("log_watch_sec_90d"),
    )
)
result = ols(analysis, "watched_7d", ["treated", "anime_days_90d", "log_watch_sec_90d",
                                       "watched_conan_before", "tenure_months", "is_kids"])
print(result.tidy.filter(pl.col("term") == "treated"))
割当台帳を基準に左結合し、ログにない人を0で埋めている点が重要である。視聴ログから始めると、視聴しなかった人がそもそも表に現れない。
結果の読み方 :treated の係数が0.05なら、「共変量が同じプロフィール同士で比べたとき、訴求対象は7日以内の視聴率が5ポイント高い」と読む。ただしこれを「訴求の効果」と呼ぶには、「これらの共変量が同じなら、訴求対象かどうかはコナンへの興味と無関係に決まった」というCIAを仮定していることを明示する。訴求ルールが実際にこれらの変数だけで決まっていれば、この仮定はかなり妥当である。ルールに記録されていない要素(運用担当者の裁量など)が含まれていれば、その分のOVBが残ることを、Robustness Valueなどとともに報告する。
報告に含めるべきこと :
- 共変量なしの単純比較、ルール変数のみ、全共変量、の三つの推定値(感度分析)。
- 頑健標準誤差、割当がアカウント単位ならクラスタ標準誤差。
- 「訴求対象のうちトレイが実際に表示された割合」(施策が届いたか)。
- 層別の効果(過去にコナンを見た人と見ていない人、など)。
- 副作用のアウトカム(他作品の視聴、総視聴時間)。
理解を確かめる小問
問1:共変量の係数が有意でなければ、モデルから外してよいか
外してはいけない。OVBの大きさ には、 が有意かどうかという情報は入っていない。 が0でなく、かつその変数が と相関しているなら、外すことでOVBが発生する。共変量の選択は、検定結果ではなく「介入の割り当てがどう決まったか」という知識に基づいて行う。
問2:RCTのデータなら、介入後の変数を共変量に入れても問題ないか
問題がある。Post Treatment Biasは介入の割り当て方法とは無関係に発生する。ランダムに配信されたメールのデータでも、来訪 visit を共変量に入れれば、来訪者の「中身」が群によって違うために効果が過小に推定される。介入前に値が決まる変数だけを使う。
問3:回帰の とRCTの平均差が違うとき、回帰にはバイアスが残っているのか
必ずしもそうではない。回帰の は、層ごとの効果を で重み付けした平均であり、介入割合が50%に近い層の効果を強く反映する。層によって効果が異なれば、CIAが完全に満たされていても、ATEとは違う値になる。効果が層間で一定なら両者は一致する。
問4:Huluで「訴求後にトレイをクリックしたか」を共変量に入れると何が起きるか
トレイのクリックは訴求の結果として決まる中間変数であり、これを入れると訴求の効果のうち「クリックを経由して視聴に至った部分」が消えて、効果が過小に推定される。さらに、訴求は「もともとクリックしにくい人」のクリックを増やすので、クリック者同士の比較では訴求群の方が視聴傾向の弱い人を多く含み、符号が逆転することすらある。クリック率自体は「施策が届いたか」を確認するアウトカムとして別に報告する。
問5:予測精度(AUC)が低い回帰モデルの は信頼できないか
予測精度と効果推定の正しさは別である。RCTデータで介入変数だけを入れたモデルは予測精度が極めて低いが、その はもっとも信頼できる効果の推定値である。効果推定の信頼性はCIAが満たされているか(交絡因子が入っているか、介入後の変数が入っていないか)で決まり、 をどれだけ説明できるかでは決まらない。
参考文献
- 安井翔太『効果検証入門:正しい比較のための因果推論/計量経済学の基礎』技術評論社、2020年。第2章。
- Angrist, J. D., Bettinger, E., Bloom, E., King, E., & Kremer, M. (2002). Vouchers for private schooling in Colombia: Evidence from a randomized natural experiment. American Economic Review, 92(5), 1535–1558.
- Angrist, J. D., & Pischke, J.-S. (2008). Mostly Harmless Econometrics. Princeton University Press. 第3章(回帰と条件付き期待値、OVB、飽和モデル)。
- Angrist, J. D., & Pischke, J.-S. (2014). Mastering ’Metrics. Princeton University Press. 第2章(回帰による効果推定、感度分析)。
- Lin, W. (2013). Agnostic notes on regression adjustments to experimental data. Annals of Applied Statistics, 7(1), 295–318.
- Cinelli, C., & Hazlett, C. (2020). Making sense of sensitivity: Extending omitted variable bias. Journal of the Royal Statistical Society: Series B, 82(1), 39–67.
- Oster, E. (2019). Unobservable selection and coefficient stability. Journal of Business & Economic Statistics, 37(2), 187–204.
- Chernozhukov, V., et al. (2018). Double/debiased machine learning for treatment and structural parameters. The Econometrics Journal, 21(1), C1–C68.
- Wager, S., & Athey, S. (2018). Estimation and inference of heterogeneous treatment effects using random forests. Journal of the American Statistical Association, 113(523), 1228–1242.
- Hillstrom, K. (2008). MineThatData E-Mail Analytics And Data Mining Challenge. メールデータの公開元。
- experimentdatar パッケージ(GitHub: itamarcaspi/experimentdatar)。vouchers データセットの取得元。