第1章 セレクションバイアスとRCT:Huluの動画推薦から理解する効果検証
本ノートは『効果検証入門』第1章の1.1〜1.5を解説するものであり、数式の前提、具体的な計算、Pythonによる分析までを一つにまとめている。教科書ではクーポンメールの施策を例にしているが、本ノートではそれをHuluの「推薦によって視聴がどれだけ増えたか」という問題に置き換えて考える。なお、Huluの数値例はすべて説明のために作った架空のデータであり、実際の施策の成果を表すものではない。
この章で身につけたいのは、 観測された成果の大きさと、施策が生み出した増分を区別すること である。増分とは「施策のおかげで増えた分」のことである。たとえば、新しい推薦を受けた人の視聴率が高かったとしても、その人たちは推薦を受ける前からよく視聴する人だったかもしれない。もしそうなら、高い視聴率をそのまま施策の手柄とは言えない。そこで本章では、「誰に介入するかがどのように決まったか」という点に注目しながら、比較が妥当かどうかを考えていく。
この章の出発点:新モデルを全員へ適用する根拠がほしい
Huluの推薦モデルを開発していると、オフラインの評価値が上がり、一部のユーザに試験配信してみると多くの視聴が発生した、という状況によく出会う。そのとき次に必要になるのは、「このモデルを全員へ適用するか」「追加の推論コストや運用負担を引き受けるか」という判断である。この判断をするには、新モデルを適用した場合に得られる成果と、現在のモデルを続けた場合に得られる成果の「差」を知る必要がある。
たとえば、新モデルの計算コストが高くても、視聴を十分に増やせるなら採用する理由がある。反対に、もともとよく視聴する人へ配信したために成果が大きく見えているだけなら、その数字を根拠に投資を増やすことはできない。つまり、 効果検証を学ぶ動機は、観測された数字を、次に何をするかという判断へ正しくつなげることにある 。
そのために、この章では次の順序で問題を解いていく。
| 判断の途中で生じる疑問 | 導入する考え方 | それによって分かること |
|---|---|---|
| モデルを替えた「おかげ」で増えたのはどれだけか | 潜在アウトカム | 比較したい二つの条件と、効果の定義 |
| 新モデル利用者と旧モデル利用者を比べればよいか | 選択バイアスと平均差の分解 | 観測差に、利用者の違いが混ざる理由 |
| 本人の興味をすべて測れなくても比較できるか | RCT | 対象者の選ばれ方を実験で制御する方法 |
| 個人の効果が見えなくても、全体の施策を判断できるか | ATE・ATT | 意思決定の対象に対応した平均効果 |
| 今回の改善は、割当の偶然だけでも起こる程度か | 標準誤差・検定・信頼区間 | 推定値の揺れ幅と、判断に残る不確実性 |
| 実験結果を正しく、効率よく得るにはどうするか | ITT・集計設計・層別化・CUPED | 比較可能性を保ち、必要な精度を得る手順 |
後に出てくる数式は、この一連の問いを曖昧にしないために導入するものである。したがって、式変形を読むときは「この操作は、どの疑問に答えようとしているのか」を確認しながら進むと理解しやすい。
1.1 セレクションバイアスとは
1.1.1 効果は「施策がなかった場合」との差である
なぜ、施策後の視聴率そのものではなく「差」を求めるのだろうか。それは、新モデルを採用するという意思決定の裏側には、旧モデルを使い続けるというもう一つの選択肢が残っているからである。旧モデルでも起こったはずの視聴を差し引いて初めて、モデル変更によって追加された価値を考えることができる。したがって、効果を定義するときは「何と比べて新モデルを選ぶのか」という比べる相手、すなわち比較対象を決めることから始まる。
まず、測りたい問いを具体的にする。たとえば「ホームの推薦モデルを従来モデルから新モデルへ変更すると、その後7日間に対象シリーズを視聴するプロフィールの割合がどれだけ変わるか」という問いである。
ここで用語を整理しておくと、新モデルを適用することを 介入・処置 、従来モデルを適用することを 対照 、7日間の視聴の有無を アウトカム (結果)と呼ぶ。注意したいのは、対照が「何も表示しない」である必要はないことで、新旧モデルの比較であれば、対照群でも旧モデルによる推薦は続いている。
具体例で考えよう。新モデル適用後に、1,000人中300人が『名探偵コナン』を視聴したとする。ただし、同じ1,000人に従来モデルを使っていたとしても250人は視聴したはずだとすると、新モデルによる増分は次のようになる。
新モデルで視聴した300人から、旧モデルでも視聴したはずの250人を引くと、増えたのは50人であり、1,000人で割れば0.05である。つまり、効果は視聴率の 5パーセントポイント上昇 である。以下、パーセントポイントを pp と略す。一方、従来の25%を基準にした相対増加率は次の通りである。
25%から30%への増加は、元の25%と比べれば2割の増加なので、「5 pp」と「20%の相対増加」は同じ変化を別の尺度で表しているだけである。ここで大切なのは、観測された300人全員を「新モデルが新たに生み出した視聴者」と数えてはいけないという点で、300人のうち250人は新モデルがなくても視聴していたからである。
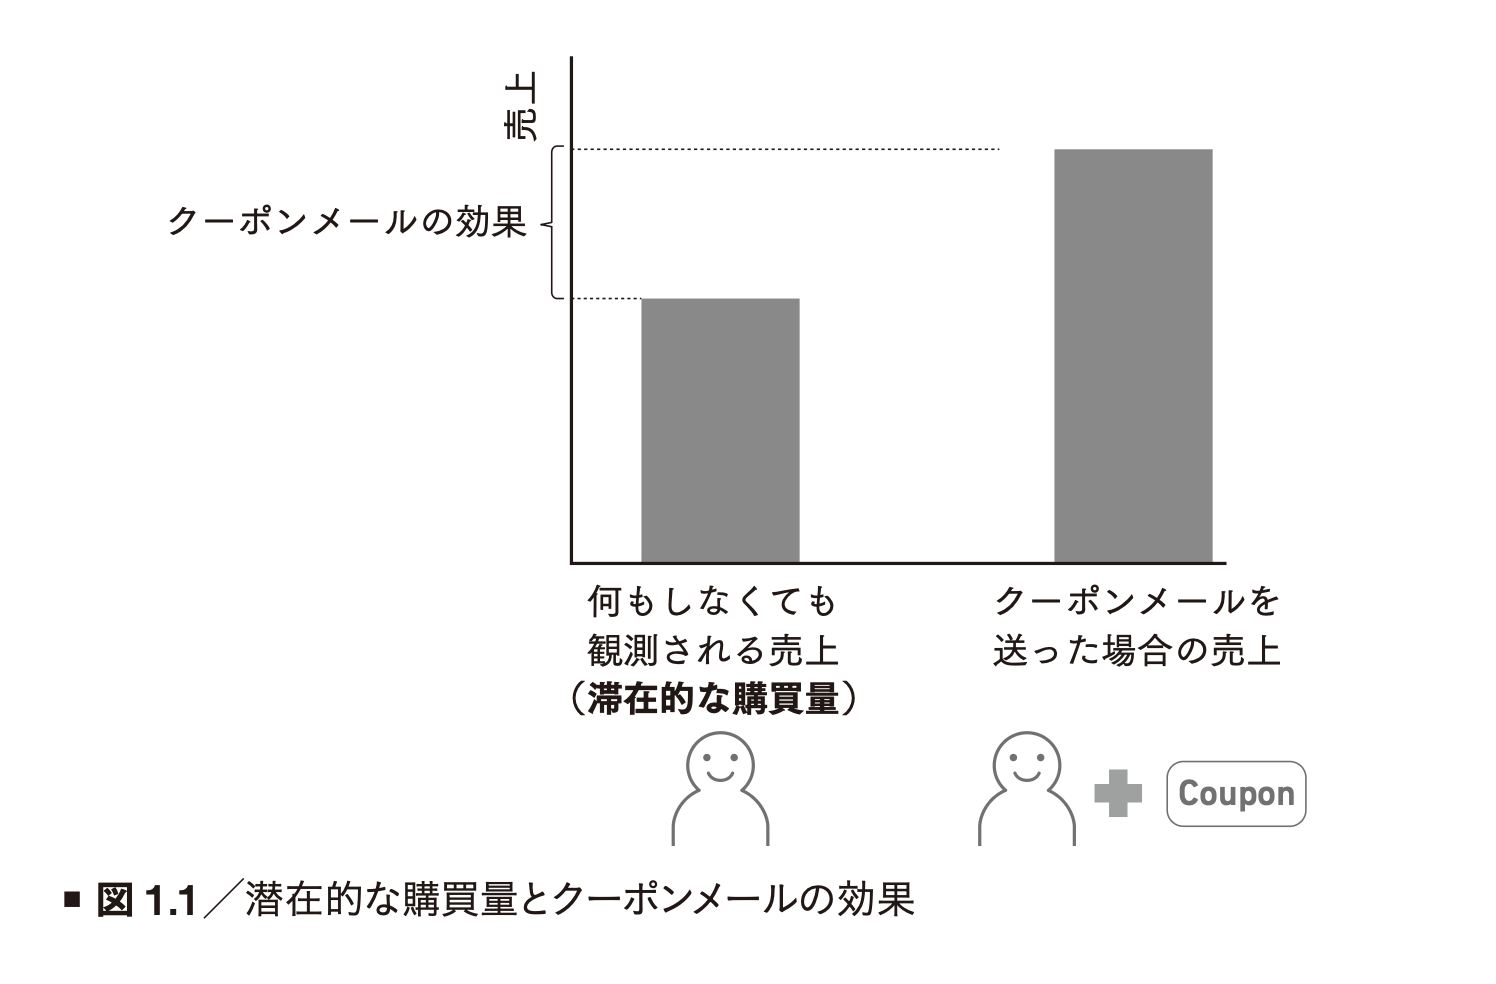
次の図は、「もともと見ていた人」の上に「新モデルで増えた人」を積み上げたものである。
教科書の図1.1も同じことを描いており、メールがなくても発生する購買と、メールによって増えた購買を分けて示している。
1.1.2 潜在的な購買量を、潜在的な視聴に置き換える
「メールがなかった場合の購買額」とは、前月の購買額のことではなく、 メールを送るかどうかを決めた、その同じ時点から始まる観測期間において、メールを送らなかった場合に生じたはずの購買額 である。つまり、「同じ期間に、別の選択をしていたら」という考え方である。
Huluでも同じく、「新モデルを適用しなかった場合の今週の視聴」が必要になる。ここで、先週の視聴と今週の視聴を比べればよいと思うかもしれないが、先週と今週では、新エピソードの公開、休日、広告、季節性など、モデル以外の条件も変わっている。たとえば先週の視聴率が20%、今週が30%だったとしても、旧モデルのままでも今週は28%に上がったはずなら、新モデルの効果は10 ppではなく2 ppである。
このように、現実には選ばれなかった条件のもとで生じたはずの結果を 反実仮想 (もし別の選択をしていたら起きたはずの結果)と呼ぶ。過去の実績は反実仮想を考えるための材料にはなるが、それ自体が反実仮想の正解ではないことに注意したい。
1.1.3 視聴しそうな人に推薦すると、比較が歪む
視聴率の高い推薦対象者が見つかったとき、次に知りたいのは「この推薦方法を広げれば、さらに視聴を増やせるか」である。しかし、視聴率が高かった理由が対象者自身の視聴意欲の高さにあるなら、推薦方法を他の人に広げても同じ成果が得られるとは限らない。そのため、成果の数字を見るだけでは足りず、 誰が、どの情報を使って、その人を推薦対象に選んだか を調べる必要がある。選択バイアスという概念は、この「選ばれ方」を比較の問題として扱うために導入する。
推薦システムは通常、ユーザの履歴や興味に応じて作品を選ぶので、ある作品の推薦を受けた人と受けなかった人では、推薦する前からその作品への興味が違いやすい。
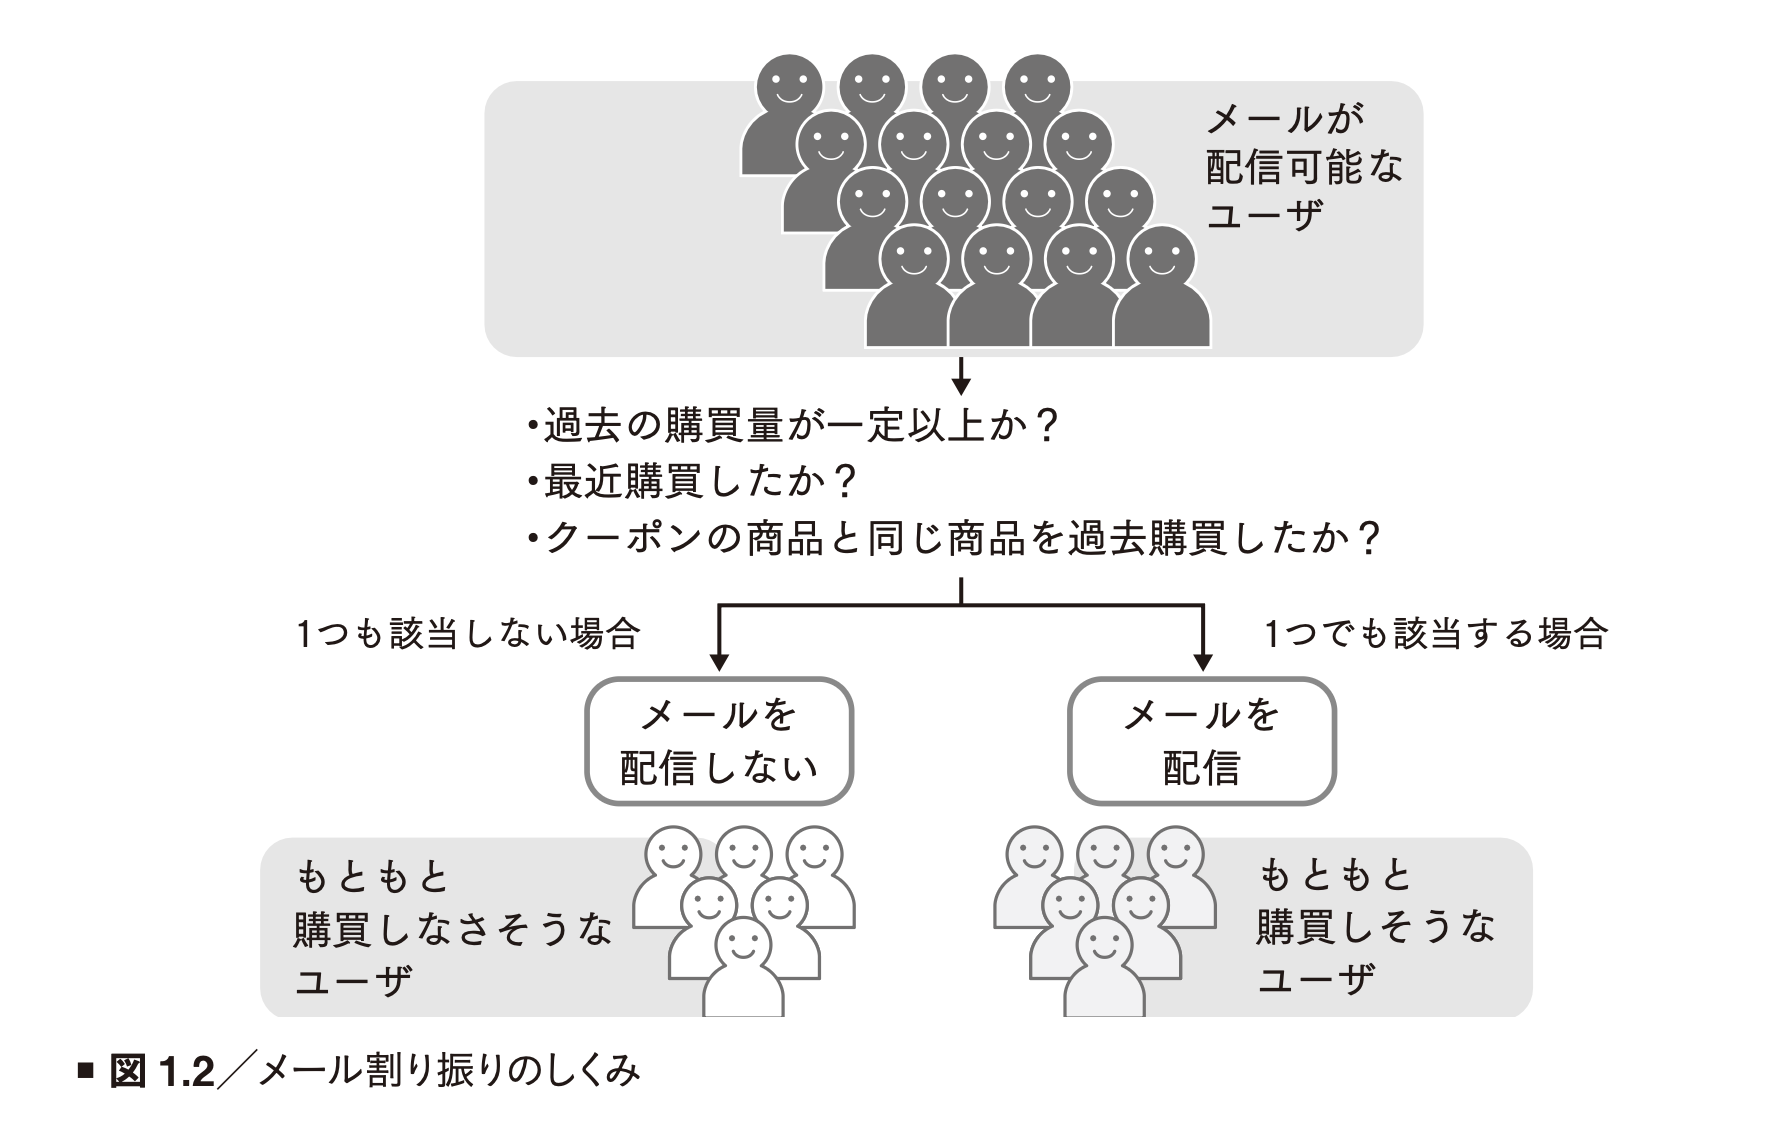
教科書の図1.2では、過去の購買や最近の購買に応じてメールを配信している。Huluに置き換えると、「アニメをよく見る」「最近『名探偵コナン』を見た」といった条件で推薦対象を選ぶことに対応する。
以下では各グループの人数を1,000人とし、表の各値は説明のために設定した平均・期待値とする。
| グループ | 新しい推薦がなくても視聴する割合 | 推薦による増分 | 実際に観測する視聴率 |
|---|---|---|---|
| 推薦対象に選ばれた、興味の強い人 | 40% | 5 pp | 45% |
| 推薦対象に選ばれなかった、興味の弱い人 | 10% | 今回は介入なし | 10% |
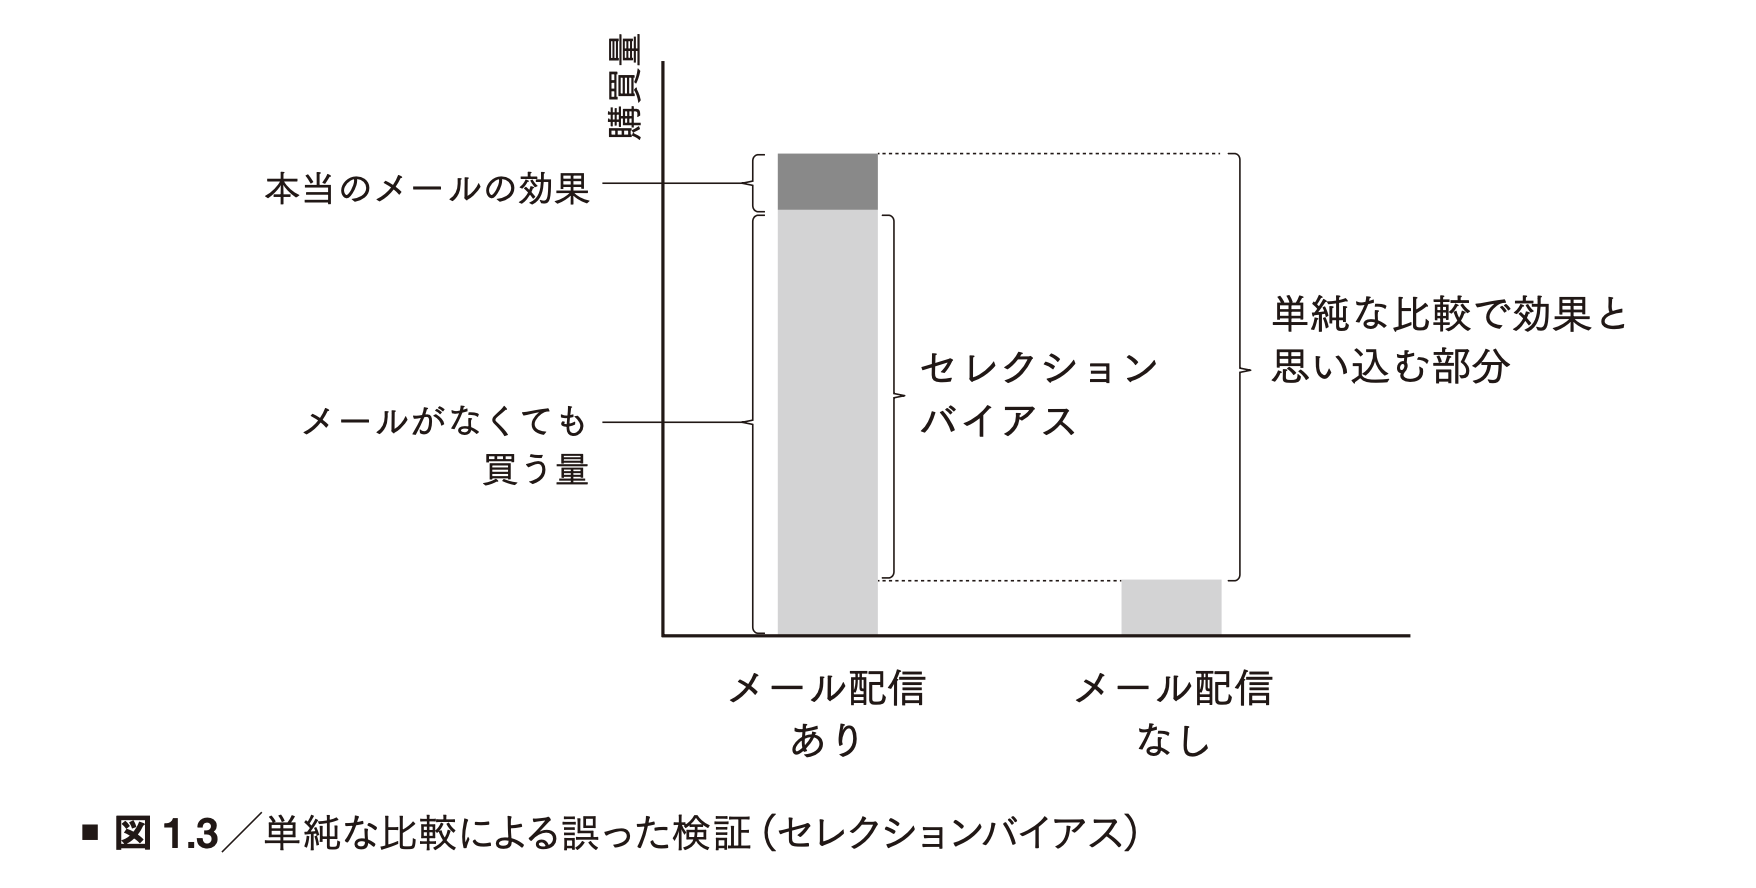
観測した視聴率をそのまま引くと35 ppの差があるが、推薦された人への本当の効果は5 ppにすぎない。この35 ppは、次のように二つの部分に分けられる。
観測された35 ppの差は、推薦が生んだ5 ppと、推薦がなくても最初からあった30 ppの差を足したものであり、後半の30 ppがこの比較に含まれる セレクションバイアス(選択バイアス) である。つまり、推薦がなくても存在していた差が、効果の中に混ざり込んでいる。図1.3の棒の高さも、効果と元来の購買傾向の違いを合わせて示している。
なお、バイアスは過大評価だけを意味するわけではなく、過小評価の方向に働くこともある。たとえば、休眠しそうな人へ復帰を促す施策では、もともと視聴しにくい人に介入が集中する。介入対象者の無介入時の視聴率が5%で施策により10%になり、非対象者の視聴率が30%だったとすると、観測差は となる。対象者に対しては5 pp改善しているのに、単純比較では20 pp悪化したように見えてしまうのである。
過大評価の例と過小評価の例を並べると、次のようになる。
補足として、統計学でいう推定量のバイアスとは「推定を繰り返したときの平均的なずれ」であり、1回の推定値と真値との差には、この系統的なずれに加えて偶然の誤差も含まれる。
1.2 RCT:比較できるグループを実験で作る
1.2.1 同じ人の二つの結果は、同時には見られない
あるプロフィールについて、同じ週に「新モデルを使った結果」と「旧モデルを使った結果」の両方を観測できれば、効果を直接計算できる。しかし現実には、どちらか一方しか実現しない。これが 因果推論の根本問題 と呼ばれるものである。
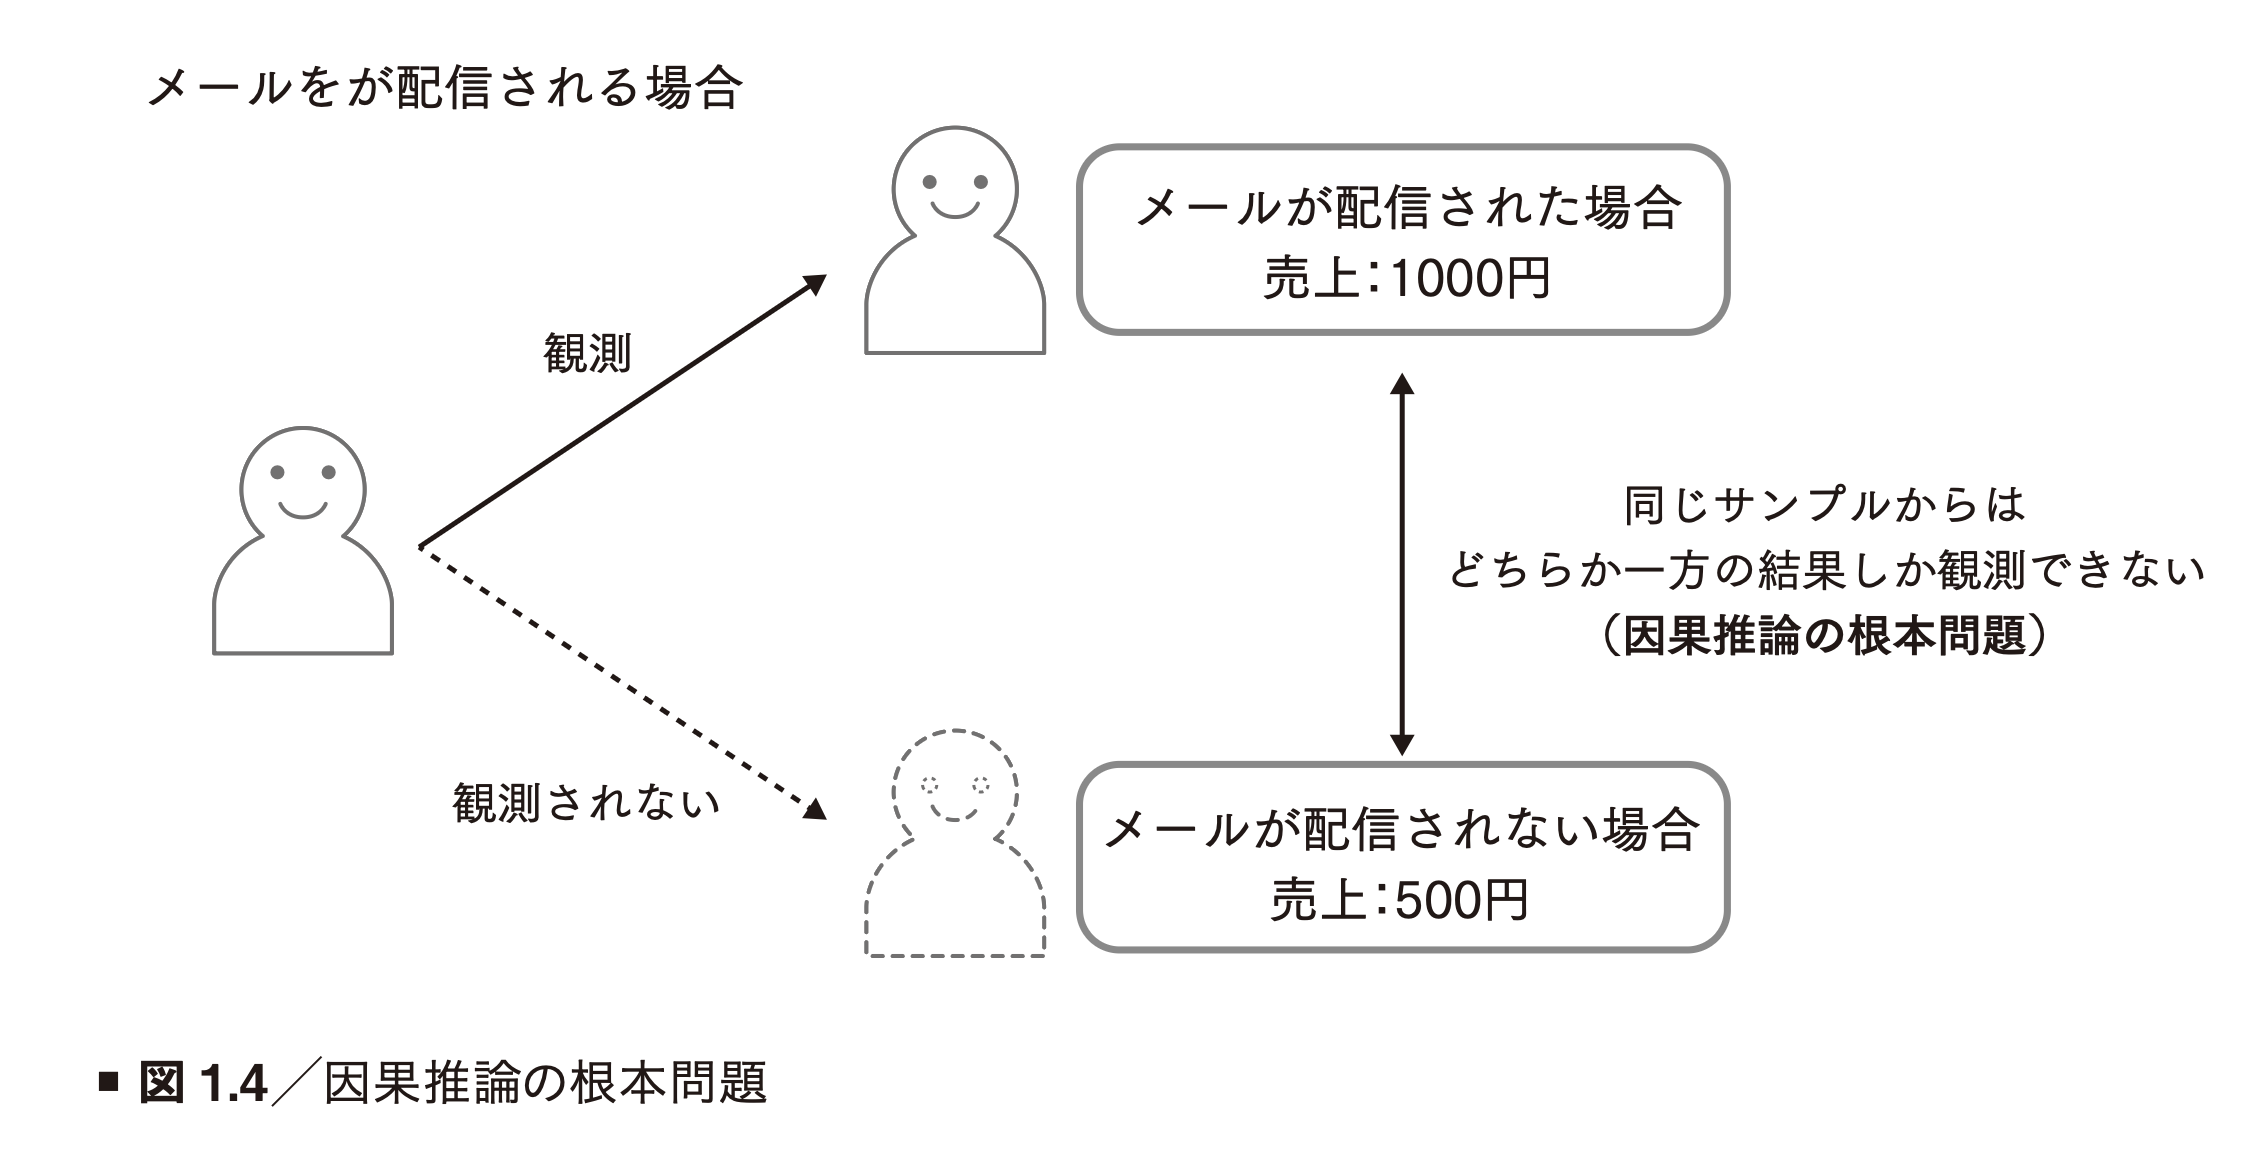
「翌週にモデルを戻して同じ人を観察すればよいのではないか」と思うかもしれないが、翌週には時間も、配信されている作品も、本人の興味も変わっている。加えて、今週の推薦をきっかけに見始めた作品を翌週も見続けるという「持ち越し」もありうる。したがって、単純な前後比較では、同じ条件の二つの世界を再現できない。
1.2.2 RCTは、平均の比較を可能にする
興味や視聴意欲が違うことが問題なら、過去の視聴日数とジャンルを揃えるなど、似たユーザを集めて比べたくなる。しかし、それだけでは「今週は仕事が忙しい」「新エピソードを楽しみにしている」といった、記録されていない違いまでは揃えられない。
ここで発想を変える。誰がどれだけ興味を持つかを完全に予測する代わりに、モデルの割当をその興味から切り離してしまえばよい、というのが無作為化(ランダム化)を行う動機である。無作為に割り当てると、測れた特徴についても測れていない特徴についても、片方の群へ意図的に人を集める仕組みがなくなる。つまり、 ランダムにするのは、比較に必要な条件を、分析の前のデータ生成の段階で作ってしまうためである 。
RCT(Randomized Controlled Trial、無作為化比較試験)では、事前に決めた対象者をランダムに介入群と対照群へ割り当てる。Webサービスでよく行われるランダム割当のA/Bテストは、RCTの一種である。
たとえば「実験開始時に対象条件を満たす2万人」を、1万人ずつ新モデル群と旧モデル群へ無作為に分けるとしよう。好きなジャンル、視聴意欲、可処分時間などを割当の判断に使わなければ、片方だけに視聴意欲の高い人を集める仕組みは存在しなくなる。
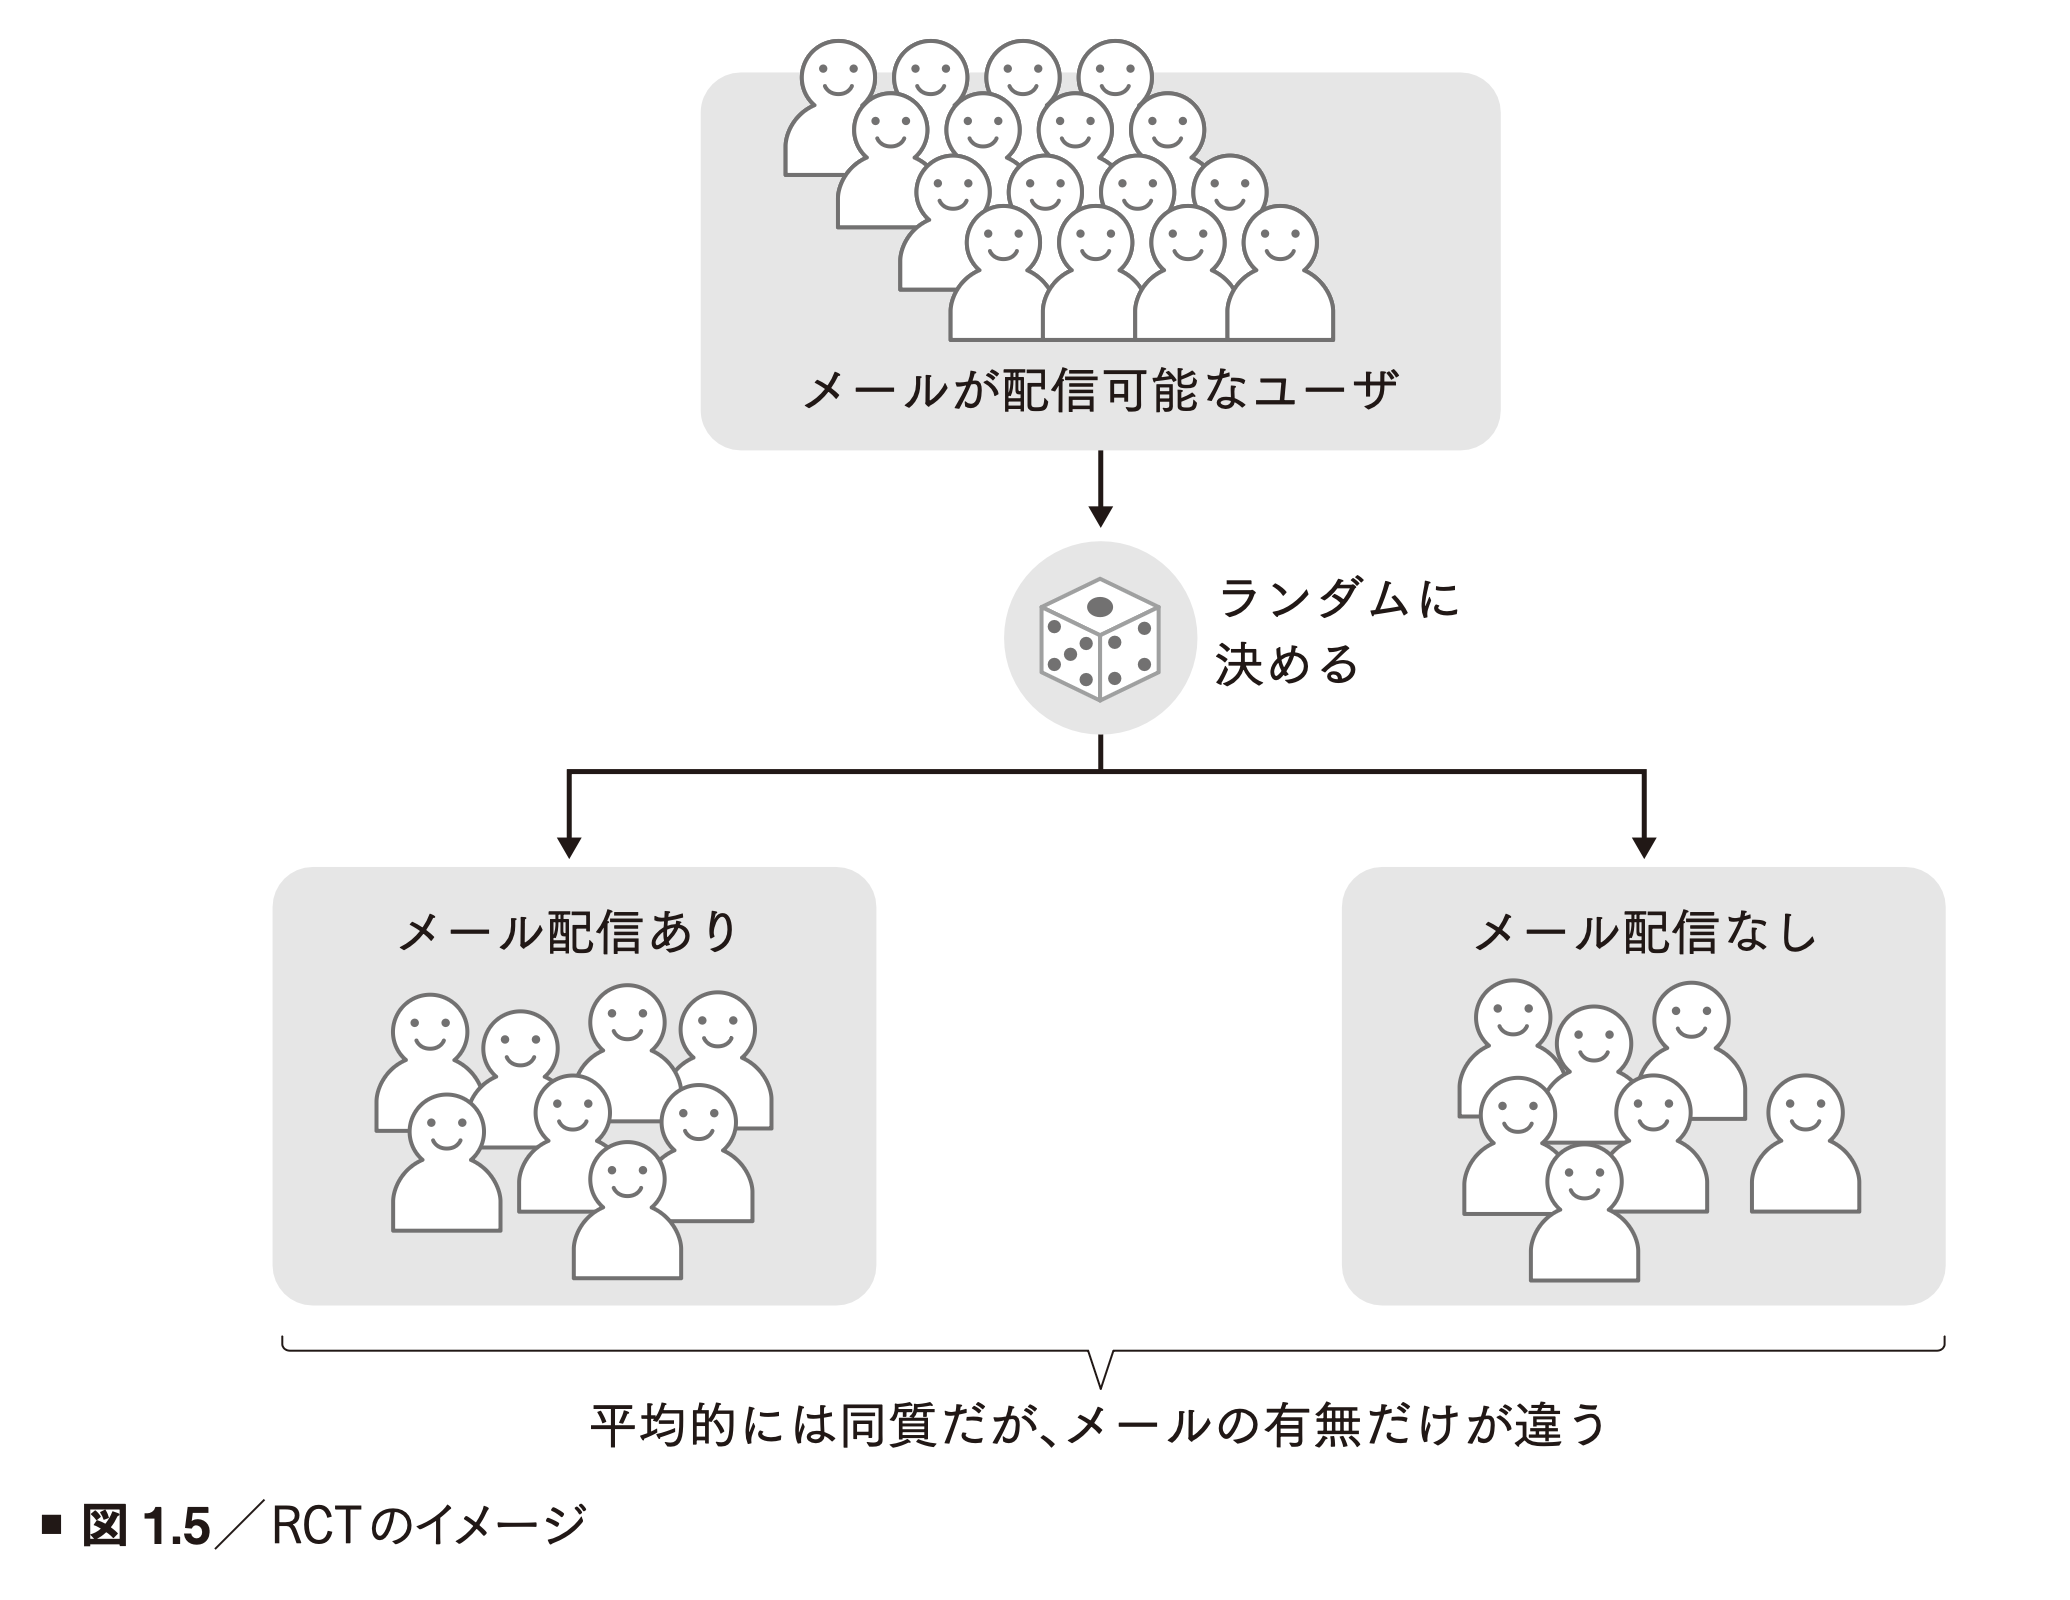
ここで重要なのは、 一度の実験で、二つの群の特徴が完全に一致するわけではない ことである。ランダムに分けても、新モデル群にアニメ好きが少し多く入ることはあるが、無作為化が防ぐのは、その偏りが特定の方向へ系統的に生まれることである。残った偶然の変動は、後で説明する標準誤差や信頼区間で扱う。
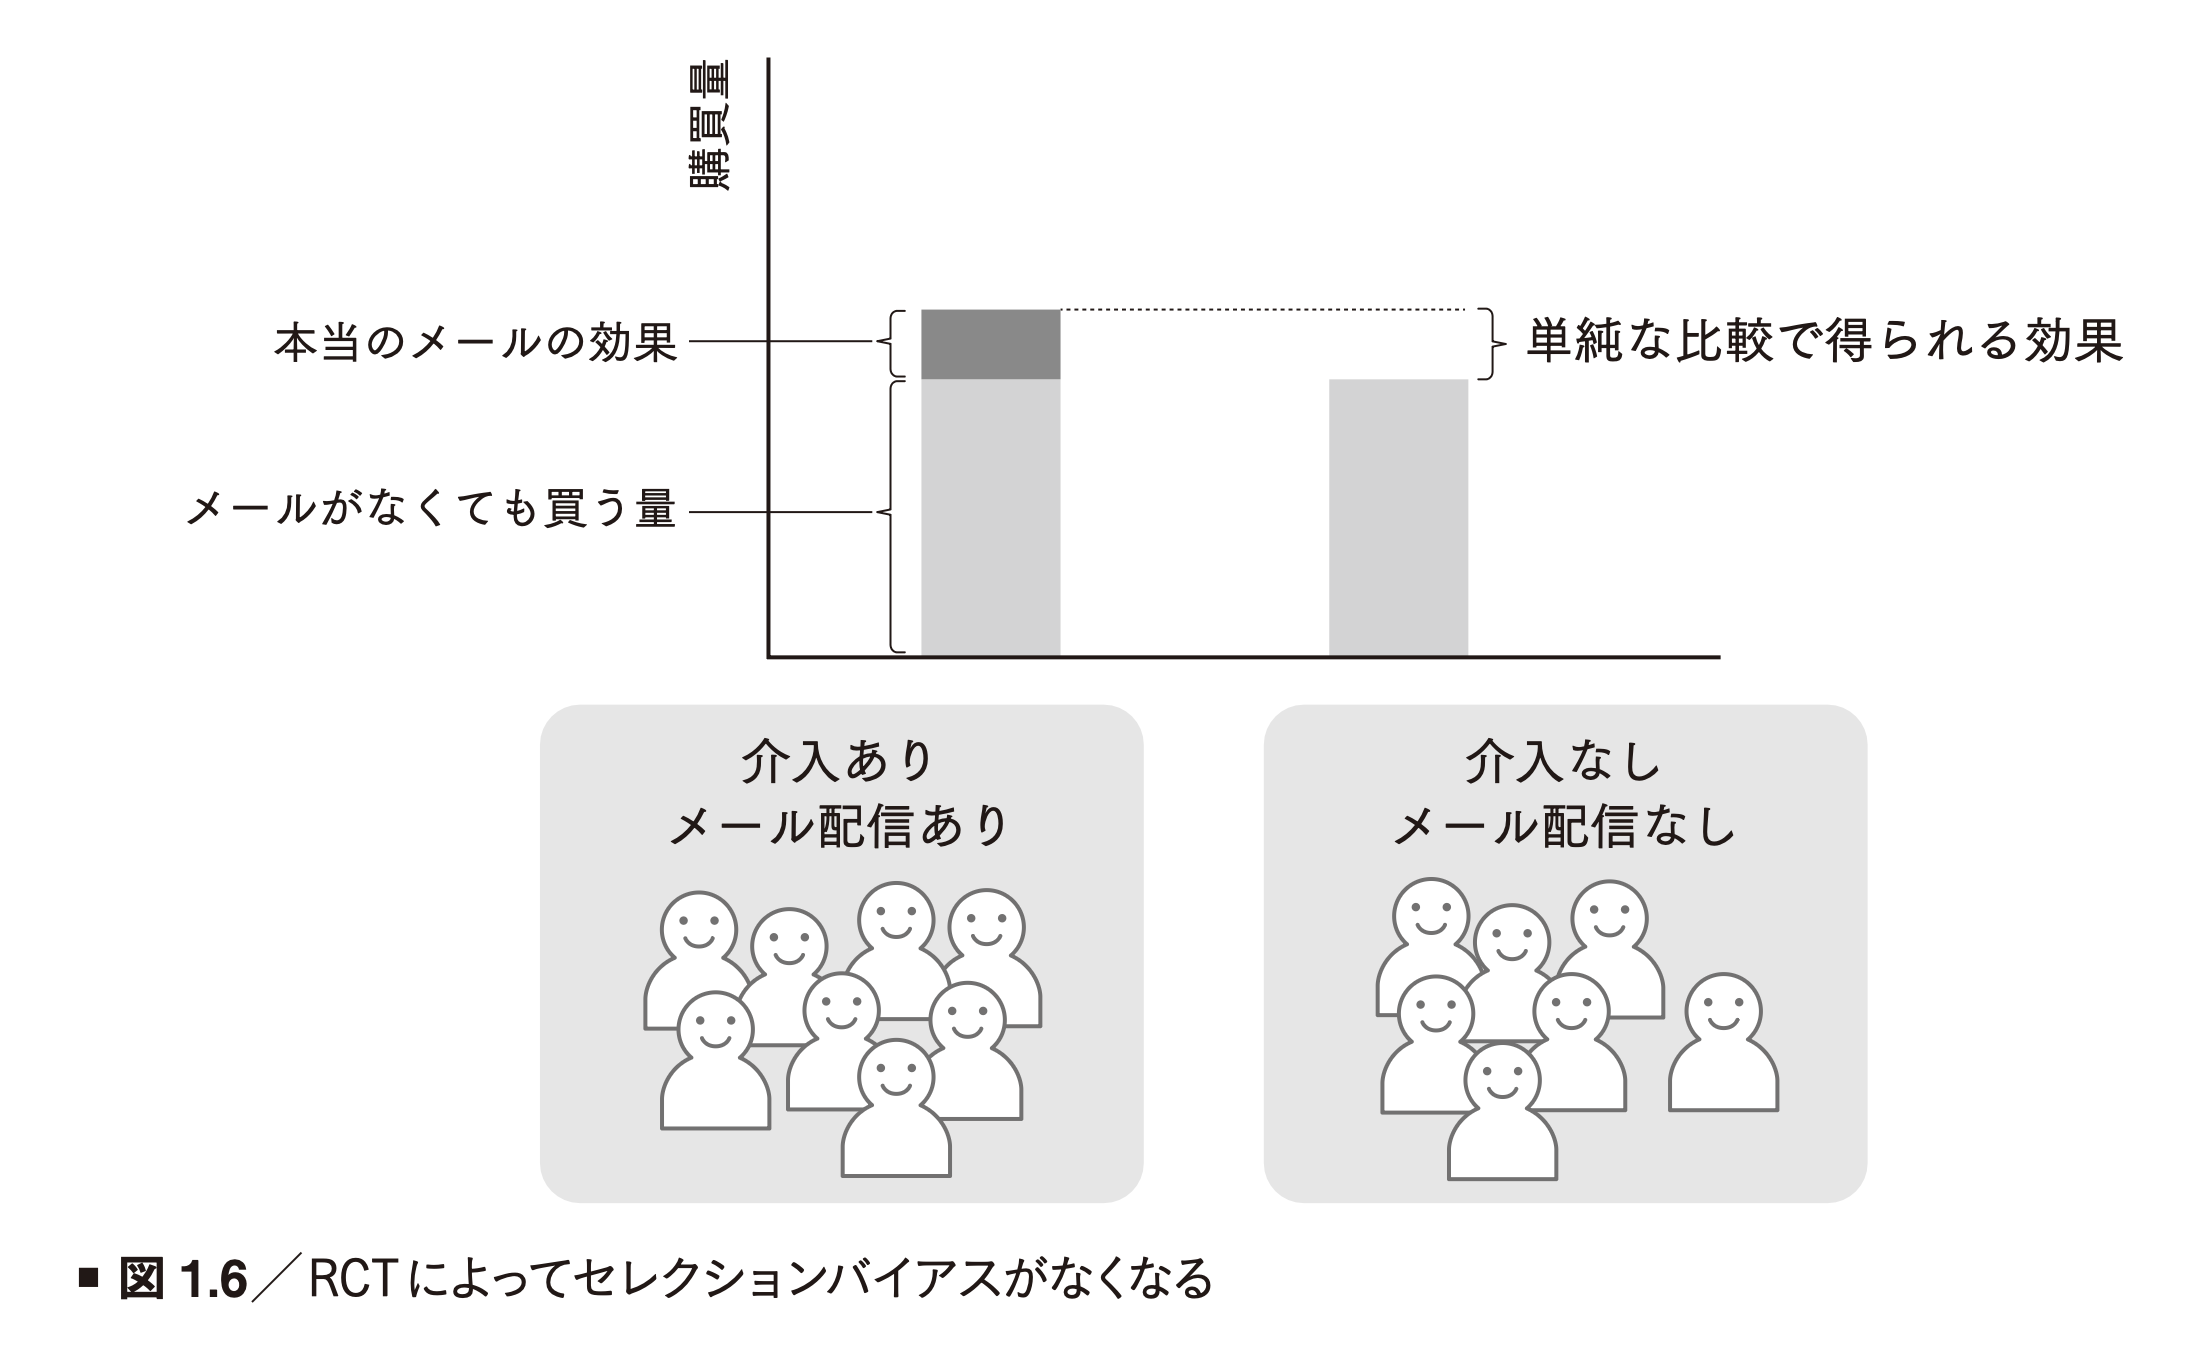
図1.6は、平均的に偏りがなくなることを理想化して描いた図なので、「RCTなら各回の標本で必ずバイアス項がちょうどゼロになる」という読み方はしない。
1.3 潜在アウトカム、平均効果、推定の不確実性
1.3.1 母集団、標本、無作為割当の違い
モデルを「誰に」展開するかによって、知りたい平均は変わる。TV利用者への展開を判断するならTV利用者での効果が必要であり、全会員への展開なら全会員での効果が必要になる。ここで母集団と標本を分けて考えるのは、手元で測れた人たちの結果と、最終的に意思決定したい人たちの結果を、同じものとして扱わないためである。
母集団 は効果を知りたい対象の全体であり、 標本 は手元で実際に観測する対象である。たとえば「実験開始時に有料会員である対象プロフィール全体」を母集団とし、その中で実験に参加した2万人を標本とする。
ここで二つの操作を区別しておきたい。母集団から誰を実験に含めるかを決めるのが 抽出 であり、実験参加者を新旧モデルに分けるのが 割当 である。無作為割当は実験の中での比較を妥当にするが、TV利用者だけで行った実験からスマートフォン利用者にも同じ効果があると結論するには、対象の違いを別に考える必要がある。
なお、全対象者を実験に含めた場合でも、一人の潜在アウトカムの片方は観測されないため、有限の対象者に対して割当を変えれば推定値が動くという不確実性は残る。ただし、これは「RCTでもデータを増やして推定精度を高めることはできない」という意味ではない。
ワークド例:RCTの参加者平均を、そのまま全会員平均にできない理由
ここでは、実験に参加した人と全対象会員で利用デバイスの構成だけが違い、デバイスごとの平均効果は分かっているものとする。これは計算練習用の設定である。
| デバイス | デバイス内の平均効果 | 実験参加者の割合 | 全対象会員の割合 |
|---|---|---|---|
| TV | 8 pp | 80% | 20% |
| スマートフォン | 2 pp | 20% | 80% |
実験参加者におけるATE(平均処置効果。詳しくは1.3.3で説明する)は、各デバイスの効果を実験参加者の割合で重み付けして求める。
TVの効果8 ppに参加者の8割を、スマートフォンの効果2 ppに参加者の2割を掛けて足している。一方、全対象会員におけるATEは次のようになる。
同じ効果の値に、今度は全対象会員の割合(TV 2割、スマートフォン 8割)を掛けている。たとえば全対象会員が10,000人なら、増える視聴者数の期待値は 人であるが、実験で得た6.8 ppをそのまま掛けると680人となり、360人も多く見積もってしまう。無作為割当がうまくいっていても、「誰の平均を取るか」が違えば効果の値は違うのである。
構成比の違いが平均効果をどう変えるかは、次の図を見ると分かりやすい。
ただし、この重み付けで全会員へ一般化できるのは、「同じデバイス内なら、実験参加者と対象会員の平均効果は同じ」という設定を置いているからである。デバイス構成を揃えただけで、実験に参加していない人の効果まで必ず分かるわけではない。
1.3.2 記号を一つずつ定義する
実際には見えない結果に、なぜわざわざ記号を付けるのだろうか。それは、観測ログだけを眺めていると、「表示された作品を見た」という事実と、「表示したから見た」という因果的な主張を、同じ列で表してしまいやすいからである。
二つの潜在アウトカム(介入あり・なしのそれぞれで起きるはずの結果)を用意すると、知りたい差を計算するのに必要な値と、そのうち実際に記録できる値を区別できる。これは架空の正解ラベルを分析に投入する操作ではなく、 何が観測できず、その不足をどの比較や仮定で補うのかを明らかにするための定義 である。
以下では教科書の を
と書き、Pythonの treatment に対応させる。
| 記号 | 意味 | Huluの例 |
|---|---|---|
| 分析対象の番号 | プロフィール番号 | |
| 介入の割当。1か0 | 新モデルなら1、旧モデルなら0 | |
| 介入ありで生じる潜在アウトカム | 新モデルなら、7日以内に対象作品を視聴するか | |
| 介入なしで生じる潜在アウトカム | 旧モデルなら、7日以内に対象作品を視聴するか | |
| 実際に観測するアウトカム | 割り当てたモデルの下での視聴の有無 | |
| 個人の因果効果 | 新旧モデルによる視聴有無の差 |
潜在アウトカムは「観測されない側」だけを指すものではなく、 と の 両方が潜在アウトカムであり、実際に受けた処置に対応する一方だけが観測される 。また、元資料には介入あり・なしと添字の対応が逆転している文章があるが、本ノートでは1を介入あり、0を介入なしに統一する。
観測値は次の式で表せる。
新モデル群の人( )については が、旧モデル群の人( )については が記録に残る、という意味である。たとえば 、 の人が新モデル群にいれば、 を代入して となり、同じ人が旧モデル群にいれば である。この式は観測できる側をスイッチで選んでいるだけで、二つの値をログから同時に計算できるという意味ではない。
個人の効果は次の通りである。
つまり、その人が新モデルで視聴するかどうかと、旧モデルで視聴するかどうかの差である。視聴の有無を0/1で定義すると個人効果の値は1、0、-1の3種類になり、潜在アウトカムの組み合わせで見ると次の4通りである。
| 解釈 | |||
|---|---|---|---|
| 0 | 1 | 1 | 新モデルによって視聴が生まれる |
| 1 | 1 | 0 | どちらでも視聴する |
| 0 | 0 | 0 | どちらでも視聴しない |
| 1 | 0 | -1 | 新モデルによって視聴しなくなる |
新モデル群で視聴した人には、最初の行の人(新モデルによって視聴が生まれた人)と2行目の人(どちらでも視聴する人)が混ざっているが、ログ上の「視聴した」という事実だけでは、どちらなのかを判別できない。ここに、「視聴を予測すること」と「増分効果を予測すること」の違いがある。
この人の記録は「1」である。
視聴していたなら効果0。視聴していなかったなら効果1。
なお、潜在アウトカムを考えるために「人の未来が哲学的に完全に決まっている」と主張する必要はない。これは、比較したい介入と期間を定義し、それぞれの条件に対応する結果を考えるための枠組みにすぎない。
1.3.3 個人の効果から平均処置効果へ
一人ずつの効果が観測できないと聞くと、施策の判断も不可能に思えるかもしれない。しかし、新モデルを対象者全体へ展開するかどうかを判断するときは、誰の視聴を新たに生んだかを特定できなくても、全体として何人分の視聴が増えるかが分かれば役立つ。
たとえば対象者が10,000人で、対象集団の平均効果が3 ppなら、全員を新モデルにした場合と旧モデルにした場合の視聴者数の差は、期待値で 人となる。ここで、効果を受ける個人を一人ずつ当てる必要はない。そこで、まずは意思決定に直結し、適切な実験によって推定できる「平均効果」を目標にする。
ATEとATTという二つの平均効果を分けるのも、展開判断の範囲を合わせるためである。現在の推薦対象者に施策を続ける価値を考えるなら、その対象者での平均効果が関心になる一方、これまで対象にしていなかった人へも広げるなら、広げた後の対象集団についての平均効果が必要になる。
個人効果を直接観測できなくても、母集団全体で平均した効果なら推定できる場合がある。平均処置効果(Average Treatment Effect、ATE)は次の量である。
は期待値、つまり母集団での平均を表すので、ATEは全員について新旧の差を取って平均したものである。「同じ人について差を取ってから平均する」と「同じ母集団の二つの潜在アウトカムをそれぞれ平均してから引く」は、結果が一致する。
たとえば1,000人のうち、新モデルでのみ視聴する人が80人、旧モデルでのみ視聴する人が20人で、残り900人は視聴の有無が変わらないとする。
ATEは6 ppであるが、これは全員の視聴確率が一律に6 pp増えることを意味しないし、「効果があった60人」を特定できることも意味しない。
実際に介入された人だけを対象とした平均効果は、ATT(Average Treatment Effect on the Treated、処置群における平均処置効果)と呼ぶ。
記号 は「介入群に属する人に限って」という条件を表すので、ATTは新モデルを実際に割り当てた人たちだけで新旧の差を平均したものである。たとえばアニメ好きだけに介入して、その人たちでの平均効果が8 pp、アニメ好きでない人での効果が0 pp、母集団では両者が半々だとしよう。このときATTは8 ppだが、ATEは 、すなわち4 ppである。
このように、 誰についての効果を求めるのか を決めずに「本当の効果」とだけ呼ぶと、異なる量を比べてしまうことになる。
1.3.4 実際に計算する平均の差
介入群の人数を 、対照群の人数を とすると、データから実際に計算する値は次の通りである。
介入群の観測値の平均から、対照群の観測値の平均を引くだけの計算である。ハット は手元のデータから得た推定値であることを示す記号で、ここでの は介入群で実際に観測した値の平均であり、母集団全員の の平均ではない。
教科書の疑似データは、次の2タイプにまとめられる。
| タイプ | 人数 | 割当 | ||
|---|---|---|---|---|
| もともと購買が少ない | 5 | 300 | 400 | 全員対照群 |
| もともと購買が多い | 5 | 500 | 600 | 全員介入群 |
各人の効果は100であるはずなのに、実際に計算した平均の差は となる。なぜこうなるのかというと、介入群からは購買の多い人の を拾い、対照群からは購買の少ない人の を拾っているためである。
1.3.5 平均の差を分解する:なぜATTが現れるのか
平均差の分解で知りたいのは、「観測差のどこまでが処置の効果で、どこからが人の違いなのか」である。新モデル群と旧モデル群の平均をそのまま引くと、「使っているモデル」と「比較している人」が同時に変わってしまう。そこで、一度に変えるものを一つにするために、間に「新モデル群の人が旧モデルを使った場合」という中間の状態を挟む。
先ほどの視聴率の例で考えよう。出発点は新モデル群の45%、終点は旧モデル群の10%で、この間に新モデル群の人が旧モデルを使った場合の40%を置く。すると、45%から40%への差は「同じ人たちについてモデルだけを変えた差」となり、40%から10%への差は「旧モデルに揃えたときの、人たちの違いによる差」となる。
数式で同じ項を引いて足すのは、この中間の比較を作るためであり、値を変えずに差の意味を二段階へ分けている。ただし、中間の40%は現実には直接観測できないので、この式だけで効果を数値として取り出せるわけではない。分解によって分かるのは、どの未知の量に対してRCTなどの根拠が必要になるかである。
観測された平均の差に対応する母集団の量を とすると、観測値と潜在アウトカムの関係から次のように書ける。
介入群で観測した平均は介入群の の平均であり、対照群で観測した平均は対照群の の平均である。ここで、「介入された人が介入されなかった場合の平均」 を一度引いてから足すと、足し引きが相殺されるため式の値は変わらない。
最初の差は「介入された人」という同じ対象について二つの世界を比較しているのでATTであり、後半の は両群をともに無介入にした場合でも残る差、言い換えると「もともとの差」である。
観測された差は、介入された人への効果と、もともとの差の合計であり、これが一般に成り立つ分解である。ATEを基準にしてずれを考えるなら、さらに次の項が必要になる。
つまり、観測差とATEのずれは「もともとの差」と「ATTとATEの差」の二つからできているので、「平均の差=ATE+選択バイアス」と直ちに書けるのは、ATTとATEが等しくなる条件があるときだけである。全員の効果が同じ場合や、潜在アウトカムと独立に無作為割当する場合がそれに当たる。
先ほどの購買例では 、 なので、 となる。Huluの例なら、 である。
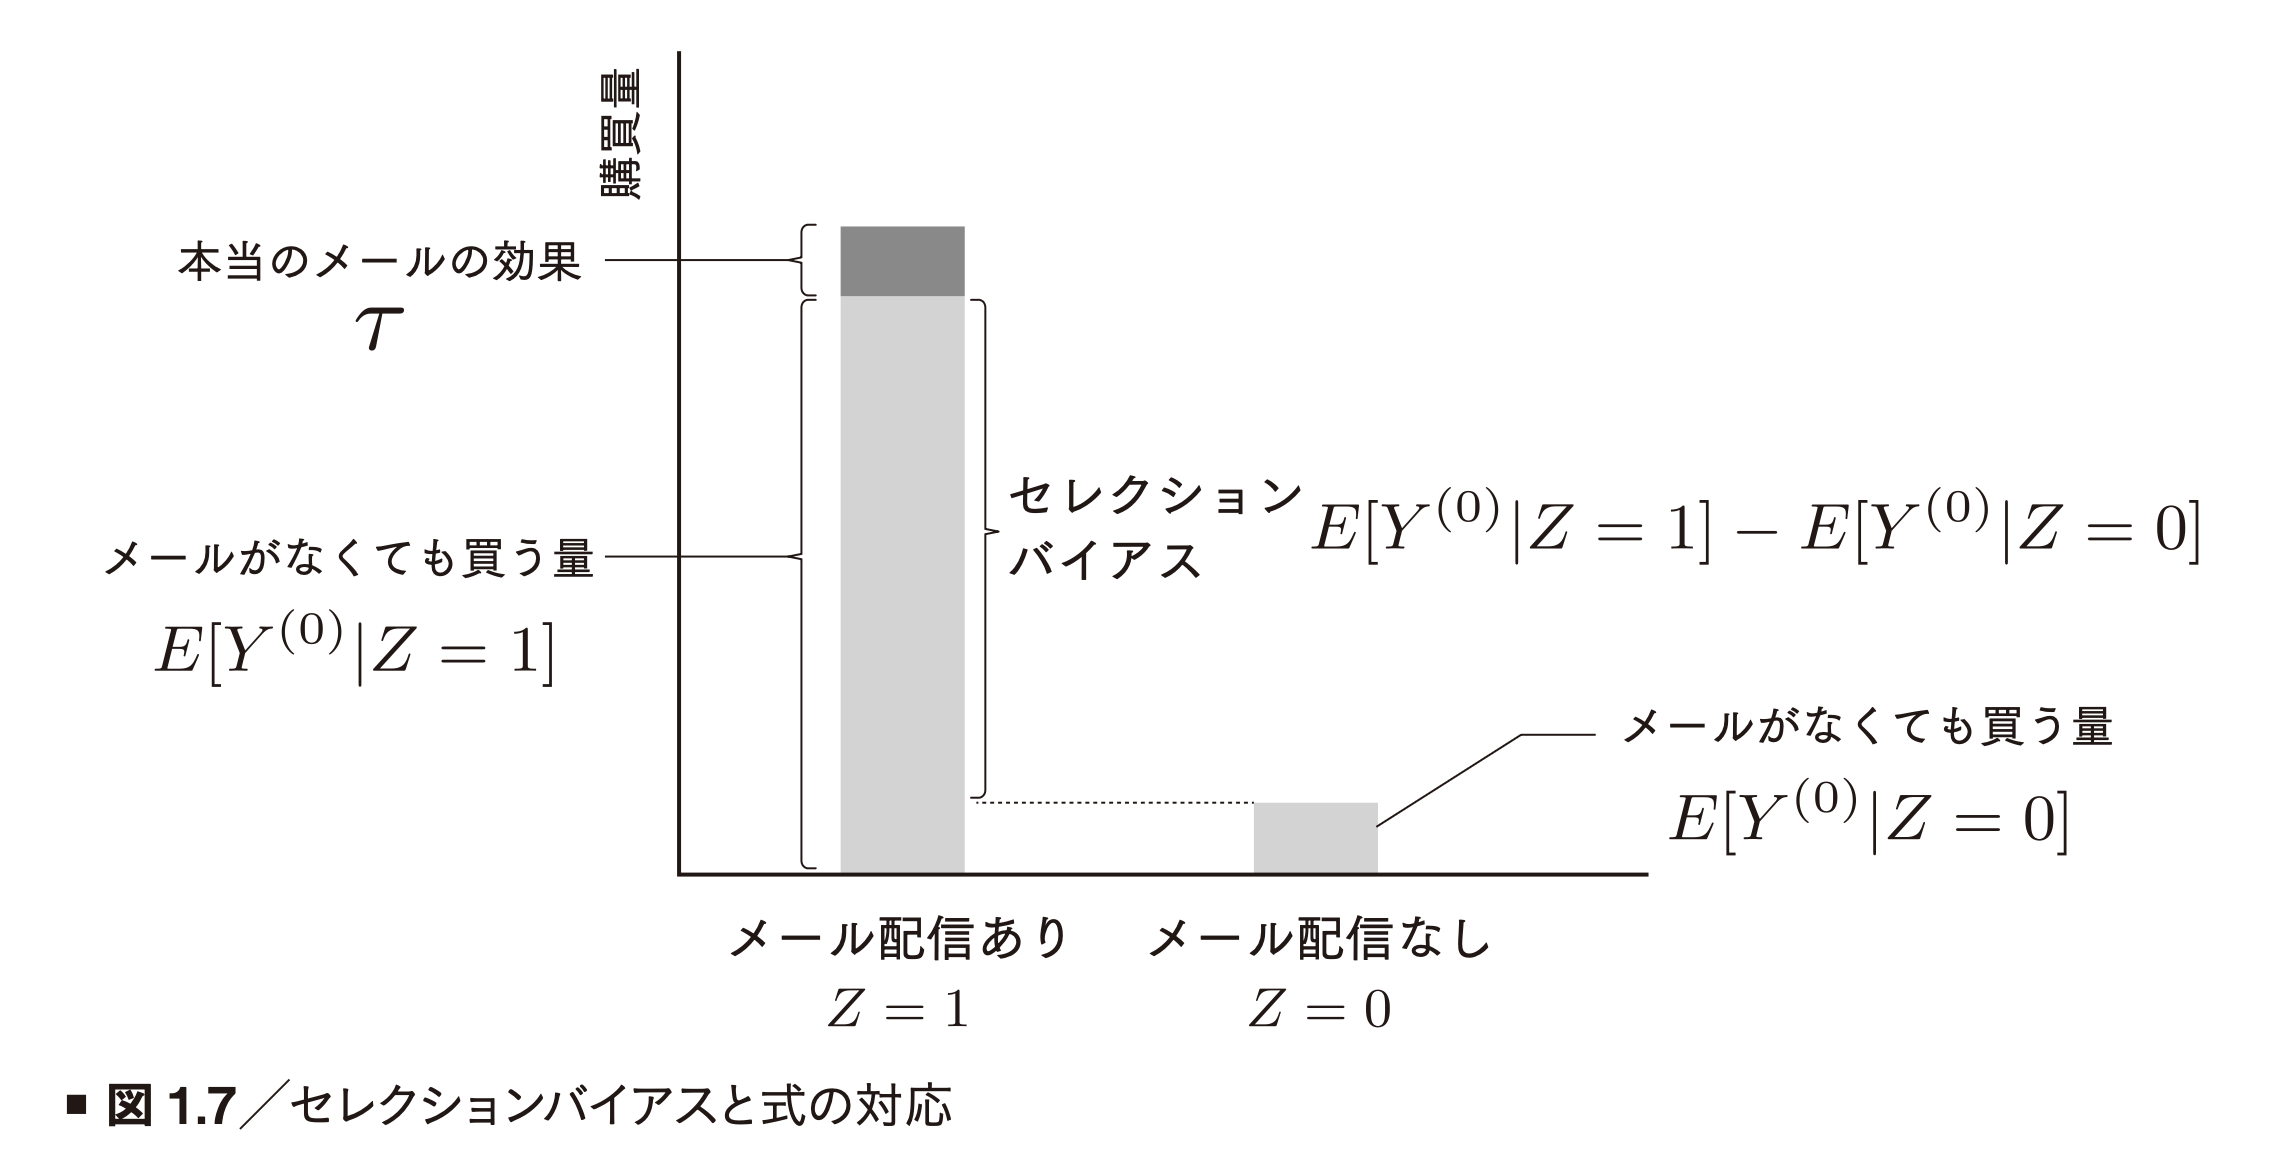
図1.7の左の薄い部分は「介入群の無介入時の平均」であり、実際には介入しているため直接観測できない。図のように棒を描くことはできても、ログにバイアスを計算するための列が揃っているわけではない。
ワークド例:8人の表から、条件付き期待値・ATT・ATEを計算する
条件付き期待値が難しく感じられるなら、まず「条件に合う行だけを残し、その列を平均する」と読めばよい。次の8人を母集団全体とし、一人ずつ同じ重みを持つとする。両方の潜在アウトカムを表に載せられるのは、説明用の仮想データだからである。
| 人 | 個人効果 | 観測する | |||
|---|---|---|---|---|---|
| A | 1 | 1 | 1 | 0 | 1 |
| B | 1 | 0 | 1 | 1 | 1 |
| C | 1 | 0 | 1 | 1 | 1 |
| D | 1 | 0 | 0 | 0 | 0 |
| E | 0 | 1 | 1 | 0 | 1 |
| F | 0 | 0 | 0 | 0 | 0 |
| G | 0 | 0 | 0 | 0 | 0 |
| H | 0 | 0 | 0 | 0 | 0 |
最初に のA〜Dだけを残し、 列を平均する。
次に、同じA〜Dについて、今度は 列を平均する。ここでのポイントは、「介入されなかった人を選び直す」のではなく、 選んだ人を固定して、見る列を変える ことである。
最後に のE〜Hを残し、 列を平均する。
したがって、観測差、ATT、無介入時の選択バイアス項は、それぞれ次のようになる。
一方、ATEは8人全員の効果を平均するので、次になる。
観測差は50 ppだが、ATEは25 ppである。分解式にも実際の数値を入れると、次のように一致する。
この例では、無介入なら両群とも視聴率25%であり、元来の視聴率は揃っている。しかし、推薦に反応するBとCだけが介入群に入っているため、 無介入時の平均が等しいだけでは、全員に適用したときの平均効果までは識別できない 。現実のRCTは、こうした「反応のしやすさ」の違いも含めて、割当から切り離す設計になっている。
1.3.6 データを増やしても、比較のずれは消えない
推定結果が信用しにくいとき、次に取れる行動は少なくとも二つある。一つは対象者を増やして偶然の揺れを小さくすることであり、もう一つは対象者の選び方や比較の方法を変えて、系統的なずれを減らすことである。どちらが必要かを判断するために誤差を分解して考えるのであって、原因が選択バイアスであるのに実験期間やデータ量だけを増やしても、必要な改善にはつながらない。
推定値の誤差を概念的に分けると、次のようになる。
推定値と本当に知りたい値のずれは、狙いそのもののずれ(バイアス)と、偶然による揺れの二つに分かれる。独立なデータを増やすと通常は後半の変動を小さくできるが、興味の強い人だけを介入群に集める仕組みをそのまま維持すれば、前半のずれは残る。たとえば真のATTが5 ppで、観測差が35 ppへ近づく仕組みなら、データを増やしても「35 pp付近」をますます精密に測ることになるだけである。
ワークド例:データを100倍にすると、誤った値の区間だけが狭くなる
全員への効果も介入者への効果も5 ppである一方、対象者の選び方によって観測差が35 ppへ近づく状況を考える。最初の分析で推定値が35 pp、標準誤差が2 ppなら、95%区間は次になる。
次に、独立な対象者を100倍に増やしたとしよう。各群の割合や分散が変わらないとすると、標準誤差はおおよそ になるので、推定値も説明のため同じ35 ppだったとすると、区間は次になる。
区間は31.08〜38.92 ppから34.608〜35.392 ppへ狭くなったが、本当に求めたい5 ppには少しも近づいていない。この区間が扱っているのは観測された群間差の不確実性であって、処置効果について妥当な区間になったわけではない。
区間が狭くなっても真の効果には近づかない様子を、次の図に示す。
1.3.7 RCTで平均の差がATEに対応する理由
ここまでで、平均の差を計算する方法と、それが効果からずれる理由が分かった。次に必要なのは、「どの条件があれば、計算した平均差を因果効果と解釈してよいのか」という根拠であり、独立性の式を導入する目的はこの根拠を明示することにある。単純な集計だから弱い分析なのではなく、その集計に意味を与える割当の条件が成立しているかどうかが重要なのである。
全員に同じ確率で無作為割当を行う理想的なRCTでは、次の独立性が成立する。
これは「割当を知っても、その人がどちらのモデルでどのような結果になるかについて、系統的な情報は増えない」という意味である。たとえば、新モデル群に入ったと知っても、その人がコナンを見やすい人かどうかは分からない。したがって、母集団では次の等式が成り立つ。
つまり、介入群の の平均は全員の の平均と同じであり、対照群の の平均は全員の の平均と同じなので、これらを代入すれば平均の差がATEになる。
教科書の表1.2では、もともと購買が多い人と少ない人が、介入群に2人ずつ、対照群に3人ずつ入っているため、次の計算でちょうど100になる。
しかし、これは無作為割当のすべての実現で起きることではない。仮に介入群4人が「高購買3人、低購買1人」だったとすると、介入群平均は550、対照群平均は約366.7となり、差は約183.3である。割当を繰り返した平均では100になるが、一回の実験では誤差が残る。
無作為化を因果効果につなげるには、介入と観測の定義も必要である。たとえば「新モデル」がプロフィールごとに全く異なる未記録の処理を意味するなら、何を比較したのかが曖昧になる。また、他人への割当が自分の視聴を変える場合には、その干渉を実験設計に織り込む必要がある。これらは一致性や干渉の問題として整理される。潜在アウトカムと識別条件の補足:Hernán・Robins, Causal Inference: What If
1.3.8 標準誤差、t値、p値、信頼区間
標準偏差と標準誤差を区別する
新モデル群の視聴率が5 pp高かったとしても、その差はたまたま視聴意欲の高い人が新モデル群に多く入っただけかもしれない。実験をやり直したら結果がどれくらい動きそうかが分からないと、「改善した」と言って全員へ展開する判断には進みにくい。そこで、その揺れ幅を数字で表すために 標準誤差 (実験をやり直したときに推定値がどれくらい揺れるかの目安)を求める。
ここで大事なのは、「ユーザごとの視聴時間はバラバラか」という問いと、「群の平均はどれくらい揺れるか」という問いが別物だという点である。たとえば一人ひとりの視聴時間が0分から数百分まで大きく散らばっていても、独立な対象者を十分に多く集めて平均すれば、群の平均はかなり正確に決まる。だからこそ、個人の散らばりを表す 標準偏差 と、平均差という推定値の揺れを表す 標準誤差 を分けて考える必要がある。
言い換えると、標準偏差は「ユーザごとの結果がどれだけ散らばるか」を表し、標準誤差(Standard Error、SE)は「同じ設計でデータ収集や割当を繰り返したとき、推定値がどれだけ動くか」を表す。注意したいのは、標準誤差が「今回の推定値と真の値との距離」を直接測ったものではなく、あくまで「繰り返したときの揺れ幅」だという点である。
まず、群 (新モデル群なら 、旧モデル群なら )の 標本分散 を次のように定義する。
その群の一人ひとりについて群平均からのずれを二乗して足し、人数から1を引いた値で割ることで、群の中での個人の散らばりの大きさを一つの数字にしている。
次に、独立な2群について平均差の標準誤差を求める。ここでは Welchの方法 (2群のばらつきが違ってもよい、t検定の計算方法)を使う。
計算は三段階である。まず各群の分散を人数で割って「個人のばらつき」を「群平均のばらつき」に変え、次に独立な2群の分散を足し合わせ、最後に平方根を取って元の単位に戻す。なお、有限母集団の完全無作為割当では、個人効果が人によって違うことに由来する観測できない項があるため、この形の分散推定は一般に保守的(実際より大きめ)になりうる。ただし入門段階では、「独立な分析単位による2群比較」として理解しておけばよい。
なぜ平均からのずれを二乗するのかというと、ずれをそのまま足すとプラスとマイナスが打ち消し合って必ずゼロになってしまうからである。二乗すれば、散らばりの大きさだけを集計できる。また、分母を人数そのものではなく人数から1を引いた値にしているのは、同じデータから推定した平均を基準にすると散らばりを少し小さめに評価してしまうためで、偏りのない分散推定では分母を一つ小さくする。
最後に平方根を取るのは、単位を揃えるためである。分散の単位は視聴時間なら「分の二乗」になっているが、平方根を取れば「分」に戻り、効果の推定値と同じ単位で比べられるようになる。このように、数式の各操作には、集計したい性質と単位を揃えるという役割がある。
教科書の等分散t検定では、両群に共通する分散を プールして (まとめて)使う。
両群の分散を人数の重みで平均して一つの分散 を作り、それを両群の人数で割って足し、平方根を取るという手順である。元資料の はこのプールした個々の観測値の分散に対応し、平均差そのものの分散は である。
ワークド例:4人ずつの視聴時間から分散と標準誤差を手計算する
0/1の視聴指標に進む前に、計算の中身が見やすい「視聴時間」の例で手を動かしてみよう。旧モデル群の視聴時間を 分、新モデル群を 分とする。これは計算練習用の小さな標本であり、実際の視聴時間の分布にこの人数でt検定を適用することを勧める例ではない。
まず、群平均は次になる。
次に、平均からのずれを二乗し、足して、人数から1を引いた値で割る。
単位は「分の二乗」なので、個人の標準偏差は旧モデル群で 分、新モデル群で 分となる。一方、平均差の標準誤差は、各群の分散を人数4で割ってから足し合わせて求める。
平均差は 分なので、t値は となり、観測された差は「揺れ幅1個分」しかない。つまり、差が3分あるだけでは十分な証拠とは言えず、差そのものではなく、その差が推定の揺れ幅に対してどれくらい大きいかを見る必要があるのである。
なお、この例でプールした分散を使うと となり、標準誤差は 分である。ここでWelchの方法と標準誤差が一致したのは両群の人数が等しいからであって、等分散であることが確認できたわけではない。実際、Welchの自由度は次のようになり、等分散t検定の自由度6とは違う。
したがって、人数が少ないときは、標準誤差が同じでもp値や信頼区間が異なることがある。
視聴率で最後まで計算する
今度は、Huluの本題である「視聴したか(0/1)」で最後まで計算してみよう。旧モデル群1,000人のうち200人、新モデル群1,000人のうち250人が『名探偵コナン』を視聴したとする。
0/1変数の分散はおおよそ で表せる(視聴率 のとき、視聴した人は だけ、しなかった人は だけ平均からずれるためである)。したがって、人数が多いときの近似では次のようになる。
標準誤差は約1.86 ppである。次に、「平均差はゼロである」という 帰無仮説 (『効果はゼロだ』という、いったん置いてみる仮定)に対するt値を求める。
これは、観測された差5 ppが推定値の典型的な揺れ幅(1.86 pp)の約2.68倍ある、という意味であり、人数が多いときの両側p値は約0.0074となる。
p値は「帰無仮説が正しい確率」ではない
効果の推定値を標準誤差で割ってt値を求めるのは、結果を「通常の揺れ幅の何倍か」という共通の尺度へ変えるためである。たとえば同じ5 ppの差でも、標準誤差が1 ppなら5倍、10 ppなら0.5倍であり、前者は「揺れではまず起きない差」、後者は「揺れの範囲内の差」なので、証拠の強さは大きく違う。
ただし、t値が何倍なら「珍しい」と言えるかは、帰無仮説のもとでその統計量がどう分布するかによる。そこで「効果はゼロ」という基準を仮に置き、そのうえで今回以上に極端な統計量がどれくらいの割合で生じるかを確率へ変換する。それが p値 を求める目的である。事前に有意水準(たとえば5%)を決めておけば、効果がない状況で「改善らしい結果」を拾ってしまう頻度を、検定の前提のもとで管理できる。
まとめると、両側p値とは、 帰無仮説と検定の前提が正しいとしたとき、今回以上に極端な検定統計量が得られる確率 である。
読み方は「効果ゼロの世界( )で実験を繰り返したとき、検定統計量の絶対値が今回観測した値以上になる確率」である。ここで は検定統計量であり、処置の割当 とは別物なので混同しないよう注意する。
ここで誤解しやすい点を確認しておく。p値0.0074は「効果がゼロである確率が0.74%」を意味しない。p値は「効果がゼロだと仮定した世界での、データの珍しさ」であって、「効果がゼロである確率」ではないからである。また、「今回の差ちょうどが出る確率」でもなく、それ以上に極端な結果をすべて含めた確率である。
さらに注意したいのは、観察データで平均差の検定が有意になったとしても、そのとき検出しているのは効果とバイアスが混ざった「群間差」かもしれないことである。たとえばアニメ好きだけに推薦した結果の35 ppの差は、人数を増やせば簡単に有意になるが、その35 ppの大半はセレクションバイアスであった。 検定は、比較対象の選び方を修復してくれない 。
ワークド例:6通りの割当を数えて、p値を求める
p値の「今回以上に極端な結果を数える」という意味を、計算機なしで確認しよう。4人のうちAとBは視聴し、CとDは視聴しないとして、「全員について処置の効果がゼロ」という 鋭い帰無仮説 を置く。つまり、誰を新モデルへ割り当てても、各人の結果(AとBは視聴、CとDは未視聴)は変わらないとする。
4人から2人を新モデル群へ無作為に選ぶ方法は 通りなので、一つずつ書き出す。
| 新モデル群 | 新モデル群の視聴率 | 旧モデル群の視聴率 | 差 |
|---|---|---|---|
| A・B | 1 | 0 | 1 |
| A・C | 0.5 | 0.5 | 0 |
| A・D | 0.5 | 0.5 | 0 |
| B・C | 0.5 | 0.5 | 0 |
| B・D | 0.5 | 0.5 | 0 |
| C・D | 0 | 1 | -1 |
実際の割当がA・Bだったとすると、観測差は1、つまり100 ppである。両側で「それ以上に極端な差」とは差の絶対値が1以上のものなので、表では最初の行(A・B)と最後の行(C・D)の2通りがそれに当たる。したがって、p値は次になる。
6通りの割当のうち、今回と同じくらい極端な差が出る割当は2通りあるので、確率は3分の1である。差が100 ppもあっても、4人しかいなければ、効果がないという仮定のもとでもこの程度に極端な割当は珍しくない。なお、「A・Bを選ぶ確率」の だけを数えると、逆方向に同じだけ極端なC・Dを落としてしまうので注意する。
6通りの差を並べると、どれを「極端」と数えたのかが見える。
これはt分布を使う検定ではなく、可能な割当を全部列挙する 無作為化検定 の例である。また、「全員の効果がゼロ」は「平均効果がゼロ」より強い仮説であり、たとえば効果が の人と の人が半々なら平均はゼロだが、その場合には各人の結果を固定して上の表を作ることはできない。
信頼区間は効果の大きさと不確実性を一緒に示す
p値によって「ゼロとの差」は評価できるが、導入判断に必要な「どれくらい改善しそうか」は、p値だけでは十分に分からない。たとえば、最低3 ppの改善がないと採算が合わない施策では、推定値が5 ppであっても、推定の不確実性が大きいか小さいかで判断が変わる。 信頼区間 は点推定(5 ppという一つの値)と揺れ幅を同じ単位で示すので、ゼロだけでなく事業上の閾値(3 pp)とも比較できる。
たとえば、同じ手続きで95%区間が1〜9 ppなら、3 ppを下回る効果も区間内に残っている。一方、4〜6 ppなら区間全体がその閾値より上にある。どちらも点推定は5 ppだが、後者の方が「必要な大きさの改善がある」という判断を支える情報が多い。
三つの区間を横に並べたのが次の図で、点推定が同じでも幅によって判断が変わることが分かる。
先ほどの視聴率の例で、人数が多いときの近似による95%信頼区間を求めると次の通りである。
点推定5 ppの前後に標準誤差の1.96倍(約3.65 pp)ずつ幅を取っているので、結果は約1.35〜8.65 ppである。人数が少ないt検定では、1.96の代わりに自由度に応じたt分布の分位点を使う。
ここで「95%」の意味を確認しておく。これは「この区間を作る手続きを何度も繰り返したとき、そのうち約95%の区間が真の値を含む」という意味であり、「今回得た一つの区間に真の値が入る確率が95%だ」という意味ではない。真の値は一つに決まっていて、揺れるのは区間の方だからである。これが頻度論的な解釈である。
同じ両側検定と、それに対応する95%信頼区間を使えば、「0が区間に含まれないこと」と「5%水準で棄却されること」は対応する。ただし、有意でない場合にも効果ゼロが証明されたわけではなく、たとえば区間が -2〜8 ppなら、改善の可能性も悪化の可能性も十分に残っている。
さらに、統計的な有意性と事業上の有用性は別である。実装費用に見合う最低効果が3 ppなら、上の区間(1.35〜8.65 pp)はその閾値より小さい効果も含んでいるし、逆に大人数で0.01 ppの差を有意に検出したとしても、それだけで採用すべきとは決まらない。
最後に、中心極限定理(多くの独立な値の平均は正規分布に近づくという定理)も無条件に使えるわけではなく、独立性や有限分散などの条件が重要である。たとえば、同じ人の視聴イベントを何千件も「独立な人」として扱うと、標準誤差を実際より小さく見積もるおそれがある。
1.4 Pythonによる疑似データとメール施策の分析
この節のPythonコードは上から順番に実行できる。NumPyで数値計算と乱数、Polarsで表の加工、SciPyで検定を行う。実行用ファイルはローカルの
output/ch1_examples.py にもまとめてあり、Python
3.14の環境で実行を確認している。リポジトリのルートで次を実行する。
uv run --with numpy==2.5.2 --with polars==1.44.1 --with scipy==1.18.1 python output/ch1_examples.pyメールデータは初回に公開元から data/hillstrom.csv
へ保存するが、既にCSVを持っている場合は環境変数
CH1_EMAIL_CSV
にそのパスを指定できる。依存ライブラリはこのコマンドの実行環境へ追加するため、サイト用の
pyproject.toml を変更する必要はない。
本ノートの数値グラフは output/ch1_plots.py
が生成する。このスクリプトは ch1_examples.py
の結果をそのまま読み込んで描くので、本文の数値と図の数値は同じ計算から出ている。uv run output/ch1_plots.py
で figs/plotly/ch1_*.html が作り直される。
1.4.1 小さなデータで、300と100の違いを再現する
本番データでは真の効果が分からないため、計算が終わっても「何をどのくらい間違えたのか」を直接確認できない。そこで最初は、作成者が正解を知っている小さなデータを使い、同じ計算式でも割当を変えると答えが変わることを確かめる。さらに、すべての割当を列挙してみると、「ある一回の結果」と「割当を繰り返した平均」を区別できる。これは、分析コードの出力を統計的にどう読むかを練習するための手順である。
まず、教科書の10人の潜在アウトカムを作る。疑似データなので、現実では観測できない二つの潜在アウトカムを両方持たせることができる。
from itertools import combinations
from pathlib import Path
import os
from urllib.request import urlopen

import numpy as np
import polars as pl
from scipy import stats

y0 = np.array([300, 500, 500, 300, 300, 500, 500, 300, 500, 300])
y1 = y0 + 100

def observed_difference(treatment: np.ndarray) -> float:
    observed = np.where(treatment == 1, y1, y0)
    return float(observed[treatment == 1].mean()
                 - observed[treatment == 0].mean())

targeted = (y0 == 500).astype(int)
textbook_rct = np.array([0, 1, 0, 1, 0, 0, 1, 1, 0, 0])
print("真の平均効果:", (y1 - y0).mean())
print("高購買者へ集中:", observed_difference(targeted))
print("教科書のRCT割当:", observed_difference(textbook_rct))

# 10人のうち4人へ割り当てる全210通りを、同じ確率で考える。
all_differences = []
for selected in combinations(range(10), 4):
    treatment = np.zeros(10, dtype=int)
    treatment[list(selected)] = 1
    all_differences.append(observed_difference(treatment))

print("全割当の平均:", np.mean(all_differences))
print("全割当の最小・最大:", min(all_differences), max(all_differences))
出力は次のようになる。
真の平均効果: 100.0
高購買者へ集中: 300.0
教科書のRCT割当: 100.0
全割当の平均: 100.0
全割当の最小・最大: -66.66666666666669 266.6666666666667
この結果が示しているのは、「RCTで得た推定値は毎回正解する」と「RCTの推定量は割当に関して平均的に正しい」の違いである。全割当の平均はちょうど100で真の効果に一致するが、10人では正の効果があるのに負の推定値が出る割当もある。したがって、人数の少ない実験の点推定だけを見て、効果の符号を確定してはいけない。
210通りの割当の結果は、次のように散らばる。
1.4.2 Hillstromのメール実験データを準備する
疑似データで仕組みを理解した後は、現実に近いデータでも同じ考え方を使えるかを確認する。現実のデータは「大半は購入せず、一部の人だけが購入する」という形をしており、購入の有無はHuluの視聴の有無と同じ0/1指標なので、購入率の集計を理解すると視聴率の集計へ対応付けやすい。加えて、ランダム割当された元データと意図的に抽出した後のデータを比べることで、検定の出力だけでは比較の質を判定できないことを体験できる。
公開元の実験では、直近12か月以内に購買した64,000人を、男性向け商品メール、女性向け商品メール、メールなしの3群へ無作為に割り当て、その後2週間の行動を記録している。 男性向け商品メールという名前は、受信者を男性だけに限定したことを意味しない 。データ作成者による実験と変数の説明
| 列 | 意味 | 分析上の役割 |
|---|---|---|
recency |
最後の購入からの経過月数 | 介入前の特徴 |
history / history_segment |
過去1年間の購買額 / その区分 | 介入前の特徴 |
mens / womens |
過去1年間に男性向け / 女性向け商品を買ったか | 介入前の特徴 |
zip_code |
地域区分。元資料では zipcode と表記 |
介入前の特徴 |
newbie |
過去12か月以内の新規顧客か | 介入前の特徴 |
channel |
過去の購買チャネル | 介入前の特徴 |
segment |
割り当てたメールの種類 | 処置 |
visit |
施策後2週間に来訪したか | アウトカム |
conversion |
施策後2週間に購入したか | アウトカム |
spend |
施策後2週間の購買額。非購入者も0で含む | アウトカム |
ここでは教科書に合わせ、男性向け商品メールとメールなしの2群に絞る。注意したいのは、第三のランダム割当群(女性向けメール群)を比較から外すことと、配信後に購入した人だけを残すことが、まったく別の操作だという点である。前者は比較の妥当性を壊さないが、後者は介入の影響を受けた結果によって対象を選んでしまう。
csv_path = Path(os.environ.get("CH1_EMAIL_CSV", "data/hillstrom.csv"))
if not csv_path.exists():
    # 教科書・公開元の配布リンクはHTTPである。
    url = (
        "http://www.minethatdata.com/"
        "Kevin_Hillstrom_MineThatData_E-MailAnalytics_"
        "DataMiningChallenge_2008.03.20.csv"
    )
    with urlopen(url, timeout=60) as response:
        csv_bytes = response.read()
    csv_path.parent.mkdir(parents=True, exist_ok=True)
    csv_path.write_bytes(csv_bytes)

email_data = pl.read_csv(
    csv_path,
    schema_overrides={"history": pl.Float64, "spend": pl.Float64},
)
required = {"segment", "conversion", "spend", "history", "recency", "channel"}
if not required.issubset(email_data.columns):
    raise ValueError("必要な列がない。公開元のCSVであることを確認する。")
if email_data.select(pl.any_horizontal(pl.col(sorted(required)).is_null()).any()).item():
    raise ValueError("欠損があるため、原因を確認してから分析する。")
if not email_data["conversion"].is_in([0, 1]).all():
    raise ValueError("conversionは0/1でなければならない。")

male_df = (
    email_data.filter(pl.col("segment").is_in(["Mens E-Mail", "No E-Mail"]))
    .with_columns(
        (pl.col("segment") == "Mens E-Mail").cast(pl.Int8).alias("treatment")
    )
)

def summarize(frame: pl.DataFrame) -> pl.DataFrame:
    return (
        frame.group_by("treatment")
        .agg(
            pl.len().alias("count"),
            pl.col("conversion").mean().alias("conversion_rate"),
            pl.col("spend").mean().alias("spend_mean"),
        )
        .sort("treatment")
    )

print("RCTの集計")
print(summarize(male_df))
CSVの spend
は0が多いため、先頭の行だけで型を推定すると整数列と判定され、後から現れる29.99などを読めない場合がある。そこで、購買額の
history と spend は
schema_overrides
で浮動小数点型を明示する。ここでやりたいのは、たとえば
[0, 0, 29.99] を読んで平均
を計算することであり、小数の行を読み飛ばすことではない。
Rの操作は、次のように対応させている。
| R | Pythonでの操作 |
|---|---|
read_csv() |
pl.read_csv() |
filter() |
.filter(条件式) |
mutate() |
.with_columns() |
if_else() |
pl.when().then().otherwise()、または真偽値の型変換 |
group_by() と summarise() |
.group_by().agg() |
pull(spend) |
.filter(条件式).get_column("spend").to_numpy() |
set.seed() と runif() |
np.random.default_rng() と .random() |
t.test() |
stats.ttest_ind() |
conversion
は0/1なので、その平均がそのまま購入率になる。一方、spend
は購入者だけに限定せず、割当対象者全員で平均する。購入者だけの平均購入額は別の指標であり、「メールが一人当たり売上を増やしたか」という問いに直接答えるものではない。Huluで言えば、「視聴した人の平均視聴時間」と「割当者全員の平均視聴時間」の違いに当たる。
Polarsの式を、4行の表で読み解く
pl.col("conversion")
は列に対する処理を表す式であり、.mean()
と組み合わせるとその列の平均を指定できる。group_by("treatment").agg(...)
の中では、各群の行だけを使って式が評価される。Polars公式:group_by
| treatment | conversion | spend |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 10 |
| 1 | 1 | 6 |
| 1 | 1 | 8 |
この表へ summarize()
を適用すると、対照群(treatment=0)では人数2、購入率
、平均購買額
になり、介入群(treatment=1)では人数2、購入率
、平均購買額 になる。
また、with_columns((pl.col("segment") == "Mens E-Mail").cast(pl.Int8).alias("treatment"))
は、メール種別が一致すれば真、一致しなければ偽という列を作り、それを1/0に変換して
treatment
と名付ける、という三段階の操作である。この操作は新しい表を返すので、追加した列を後で使うときは、返り値を受け取って処理をつなぐ。Polars公式:with_columns
最後の .sort("treatment")
は結果を0、1の順に表示するためのもので、推定値には影響しない。役割分担としては、乱数はNumPy、集計はPolars、検定はSciPyが担当し、SciPyに渡す時点で対象列をNumPy配列に変換する。
1.4.3 平均差と信頼区間を計算する
教科書の var.equal = TRUE に忠実に対応するのは
equal_var=True
であり、等分散を仮定しないWelch検定を使うには明示的に
equal_var=False
とする。ここでは両方を出力し、符号を「介入群−対照群」に統一する。SciPyでは、検定結果から信頼区間も取得できる。SciPy公式:ttest_ind
def compare_means(
    frame: pl.DataFrame, outcome: str, *, equal_var: bool = False
) -> dict[str, float]:
    treated = (
        frame.filter(pl.col("treatment") == 1)
        .get_column(outcome).cast(pl.Float64).to_numpy()
    )
    control = (
        frame.filter(pl.col("treatment") == 0)
        .get_column(outcome).cast(pl.Float64).to_numpy()
    )
    if min(len(treated), len(control)) < 2:
        raise ValueError("両群に少なくとも2件必要である。")
    if not (np.isfinite(treated).all() and np.isfinite(control).all()):
        raise ValueError("欠損・無限大を除外する前に、その発生理由を確認する。")
    result = stats.ttest_ind(
        treated, control, equal_var=equal_var,
        alternative="two-sided", nan_policy="raise",
    )
    ci = result.confidence_interval(confidence_level=0.95)
    return {
        "difference": float(treated.mean() - control.mean()),
        "t": float(result.statistic),
        "p": float(result.pvalue),
        "ci_low": float(ci.low),
        "ci_high": float(ci.high),
    }

print("RCTのspend・等分散:", compare_means(male_df, "spend", equal_var=True))
print("RCTのspend・Welch:", compare_means(male_df, "spend"))
print("RCTのconversion・Welch:", compare_means(male_df, "conversion"))
conversion
の平均差は購入確率の差である。0/1データでも、十分な標本数があり、各群で購入・非購入の件数が十分にあれば、平均差について人数が多いときの推論を行える。ただし、人数が少ない場合や極端に稀なイベントの場合は、正規近似の信頼区間をそのまま信用してはいけない。
公開CSVによる実行結果は、後述の実行結果表で確認する。資料掲載の丸めた値では対照群の購入率が約0.573%、介入群が約1.25%なので、差は 約0.677 pp である。確率の差で書けば約0.00677となり、「0.677だけ確率が上がる」と書くと単位を誤ることになる。なお、CSVの丸める前の値から計算した差は 約0.6805 pp である。
また、提供された本文中の平均購買額 と の差を直接計算すると になるが、掲載された信頼区間の中点は約0.7652772となっていて、同じt検定の結果としては整合しない。そのため、本ノートでは掲載出力を正解として固定せず、CSVからの計算を基準にする。
1.4.4 無作為化したデータでも、後からの抽出でバイアスが生まれる
ここでは、「実験時にランダムだったから、どんな前処理の後でも公平な比較ができる」という思い込みを確かめるために、わざとデータを偏らせる。Huluでも、ログが豊富な人だけを残す、表示を確認できた人だけを残す、といった加工によって群の構成が変わる可能性があるので、影響の仕組みを自分で作って観察すると、実務でどの抽出条件を点検すべきかが分かりやすくなる。
次のコードでは、購買意欲の高そうな人を介入群に多く残し、購買意欲の低そうな人を対照群に多く残す。これは学習用の操作であり、RCTの本分析で行う前処理ではない。
「高意欲らしい」の条件は教科書のコードに合わせ、history > 300、recency < 6、channel == "Multichannel"
のいずれかを満たすこととする。本文には recency < 3
と書かれた箇所もあるが、ここではコードの6を採用する。
| 特徴 | 介入群に残す確率 | 対照群に残す確率 |
|---|---|---|
| 高意欲らしい | 100% | 50% |
| それ以外 | 50% | 100% |
rng = np.random.default_rng(1)
diagnostic = (
    male_df.with_columns(
        (
            (pl.col("history") > 300)
            | (pl.col("recency") < 6)
            | (pl.col("channel") == "Multichannel")
        ).alias("high_intent"),
        pl.Series("random_number", rng.random(male_df.height)),
    )
    .with_columns(
        pl.when(pl.col("treatment") == 1)
        .then(pl.when(pl.col("high_intent")).then(1.0).otherwise(0.5))
        .otherwise(pl.when(pl.col("high_intent")).then(0.5).otherwise(1.0))
        .alias("keep_probability")
    )
)
biased_df = diagnostic.filter(pl.col("random_number") < pl.col("keep_probability"))

print("選択バイアスを作った後の集計")
print(summarize(biased_df))
print("抽出後のspend・等分散:", compare_means(biased_df, "spend", equal_var=True))
print("抽出後のspend・Welch:", compare_means(biased_df, "spend"))

for label, frame in [("元の高意欲者割合", diagnostic), ("抽出後の高意欲者割合", biased_df)]:
    print(label, frame.group_by("treatment").agg(
        pl.col("high_intent").mean().alias("high_intent_rate")
    ).sort("treatment"))
簡単な例で確かめよう。高意欲者が元データの60%で、ランダム割当により両群で同じ割合だったとすると、抽出後の介入群での高意欲者割合は次になる。
高意欲者60%は全員残り、それ以外40%は半分だけ残るので、残った人のうち高意欲者が占める割合は75%になる。一方、対照群では次になる。
同じ60%から始まっても、抽出後は75%と約42.9%に開き、その結果として介入の効果に元来の購買傾向の違いが混ざる。 抽出に乱数を使っていても、残す確率が処置と特徴に依存していれば、比較の無作為性は保たれない 。
なお、PythonとRでは乱数生成器が異なるため、同じシード1でも抽出される行や推定値は一致しない。また、抽出によって対象集団そのものも変化するので、RCTとの差をすべて厳密に「バイアスの大きさ」と断定することはできず、効果が人によって違えばATTの変化や偶然の誤差も含まれる。ただし、この操作が比較可能性を壊すことは、抽出の仕組みから説明できる。
さらに、p値が小さくなることと標準誤差が小さくなることは同じではない。平均差そのものが大きくなれば、標準誤差が増えていてもp値は小さくなりうる。
1.4.5 Huluの視聴率の計算をPythonで確認する
hulu_demo = pl.DataFrame({
    "treatment": np.repeat([0, 1], 1000),
    "viewed": np.concatenate([
        np.ones(200), np.zeros(800),
        np.ones(250), np.zeros(750),
    ]),
})
view_result = compare_means(hulu_demo, "viewed")
print("視聴率の差と区間(pp):", {
    name: round(view_result[name] * 100, 4)
    for name in ["difference", "ci_low", "ci_high"]
})
print("視聴率のp値:", view_result["p"])
平均差は5 ppである。ここでは標本分散とt分布を使うため、手計算の正規近似と区間の末尾がわずかに異なるが、これは計算間違いではない。
1.4.6 公開CSVでの実行結果
上記コードを公開元のCSVに対して実行した結果は次の通りである。購入率は割合のまま表示しており、たとえば0.005726は約0.5726%である。
| データ | 群 | 人数 | 購入率 | 一人当たり購買額(ドル) |
|---|---|---|---|---|
| 元のRCT | メールなし | 21,306 | 0.005726 | 0.652789 |
| 元のRCT | 男性向け商品メール | 21,307 | 0.012531 | 1.422617 |
| 意図的な抽出後 | メールなし | 14,775 | 0.004873 | 0.577320 |
| 意図的な抽出後 | 男性向け商品メール | 17,150 | 0.013120 | 1.531037 |
購買額についてのWelch検定は次の結果となった。
| データ | 平均差(ドル) | 95%信頼区間(ドル) | 両側p値 |
|---|---|---|---|
| 元のRCT | 0.769827 | [0.485140, 1.054515] | 約 |
| 意図的な抽出後 | 0.953718 | [0.619285, 1.288150] | 約 |
抽出後は元のRCTより平均差が大きく、p値も小さい。しかし、抽出後の高意欲者割合は介入群で約75.98%、対照群で約44.45%となっており、比較している人の構成が大きく異なる。つまり、見かけ上は「より強い証拠」が出ているが、比較の質は落ちているのである。
推定値の変化と、比べている人の中身の変化を並べたのが次の図である。
元のRCTの購入率差は0.006805、すなわち約0.6805 ppで、その95%信頼区間は約0.5000〜0.8610 ppである。一方、Huluの架空例は5 pp、95%信頼区間は約1.3423〜8.6577 pp、p値は約0.00740となった。実際のメール実験とHuluの架空例は、別のデータである。
再現性のため、今回取得したCSVのSHA-256を記す。
0e5893329d8b93cefecc571777672028290ab69865718020c78c7284f291aece1.5 ビジネスにおける因果推論の必要性
1.5.1 RCTのコストと、比較のために残す対照群
RCTには、モデルの分岐、割当の保存、ログ整備、実験監視、結果を得るまでの時間といったコストがかかる。また、新モデルが有効なら、旧モデル群を残すことで短期的な機会損失も生じうる。一方で、新モデルの効果はまだ不明なのだから、全員へ適用した方が必ず得だとは事前には言えない。
RCTを行うために、「興味のある作品を全部ランダムに推薦する」といった大きな変更が必要なわけではない。たとえば、事前にアニメ視聴者を対象と決め、その人たちの中で新旧モデルをランダムに割り当てれば、その対象集団についてのRCTになる。実験対象と比較対象を丁寧に定義することで、事業上の制約と比較可能性を両立できる。
RCTが難しい場合には、回帰、傾向スコア、DID(差の差法)、RDD(回帰不連続デザイン)などを使う余地がある。しかし、手法が観察データを無条件に実験データへ変えてくれるわけではなく、「誰がなぜ処置を受けるのか」という理解と、その手法に対応する仮定が必要になる。
1.5.2 視聴予測の高さと増分の大きさは違う
推薦やメール施策の担当者が「配信後の視聴数」を最大化しようとすると、もともと視聴しそうな人や作品を選びやすい。この意思決定は自然なものだが、「施策の増分を測る」という目的とは一致しないことがある。
次の確率は、二つのタイプについて設定した仮想的な真値である。
| タイプ | 推薦しない場合の視聴確率 | 推薦する場合の視聴確率 | 増分 |
|---|---|---|---|
| 毎週『名探偵コナン』を見る人 | 80% | 82% | 2 pp |
| 興味はあるが見始めていない人 | 10% | 25% | 15 pp |
配信後の視聴数だけを見るなら前者(82%)が魅力的に見える。しかし、どちらか100人にしか介入できないとすると、新たに生まれる視聴者数の期待値は、前者なら 人、後者なら 人である。つまり、視聴率が高い人ほど、推薦の「増分」は小さいことがある。
これは視聴予測モデルが不要という意味ではなく、通常の予測モデルが推定する量(見るかどうか)と、施策による増分効果(推薦したから見るようになったか)は別の量だ、という意味である。増分に応じた配信を目指すuplift modeling(アップリフトモデリング)はこの区別を利用するが、その学習にも比較可能なデータが必要であり、しかもRCTを行っても各個人の効果の正解ラベルが得られるわけではない。
1.5.3 バイアスのある評価は、次のデータも偏らせる
「人気作品を推薦する→多く視聴される→推薦の効果が大きいと判断する→さらに人気作品へ露出を集中する」という更新を繰り返すと、もともとの需要の高さを推薦の手柄と誤認する可能性がある。
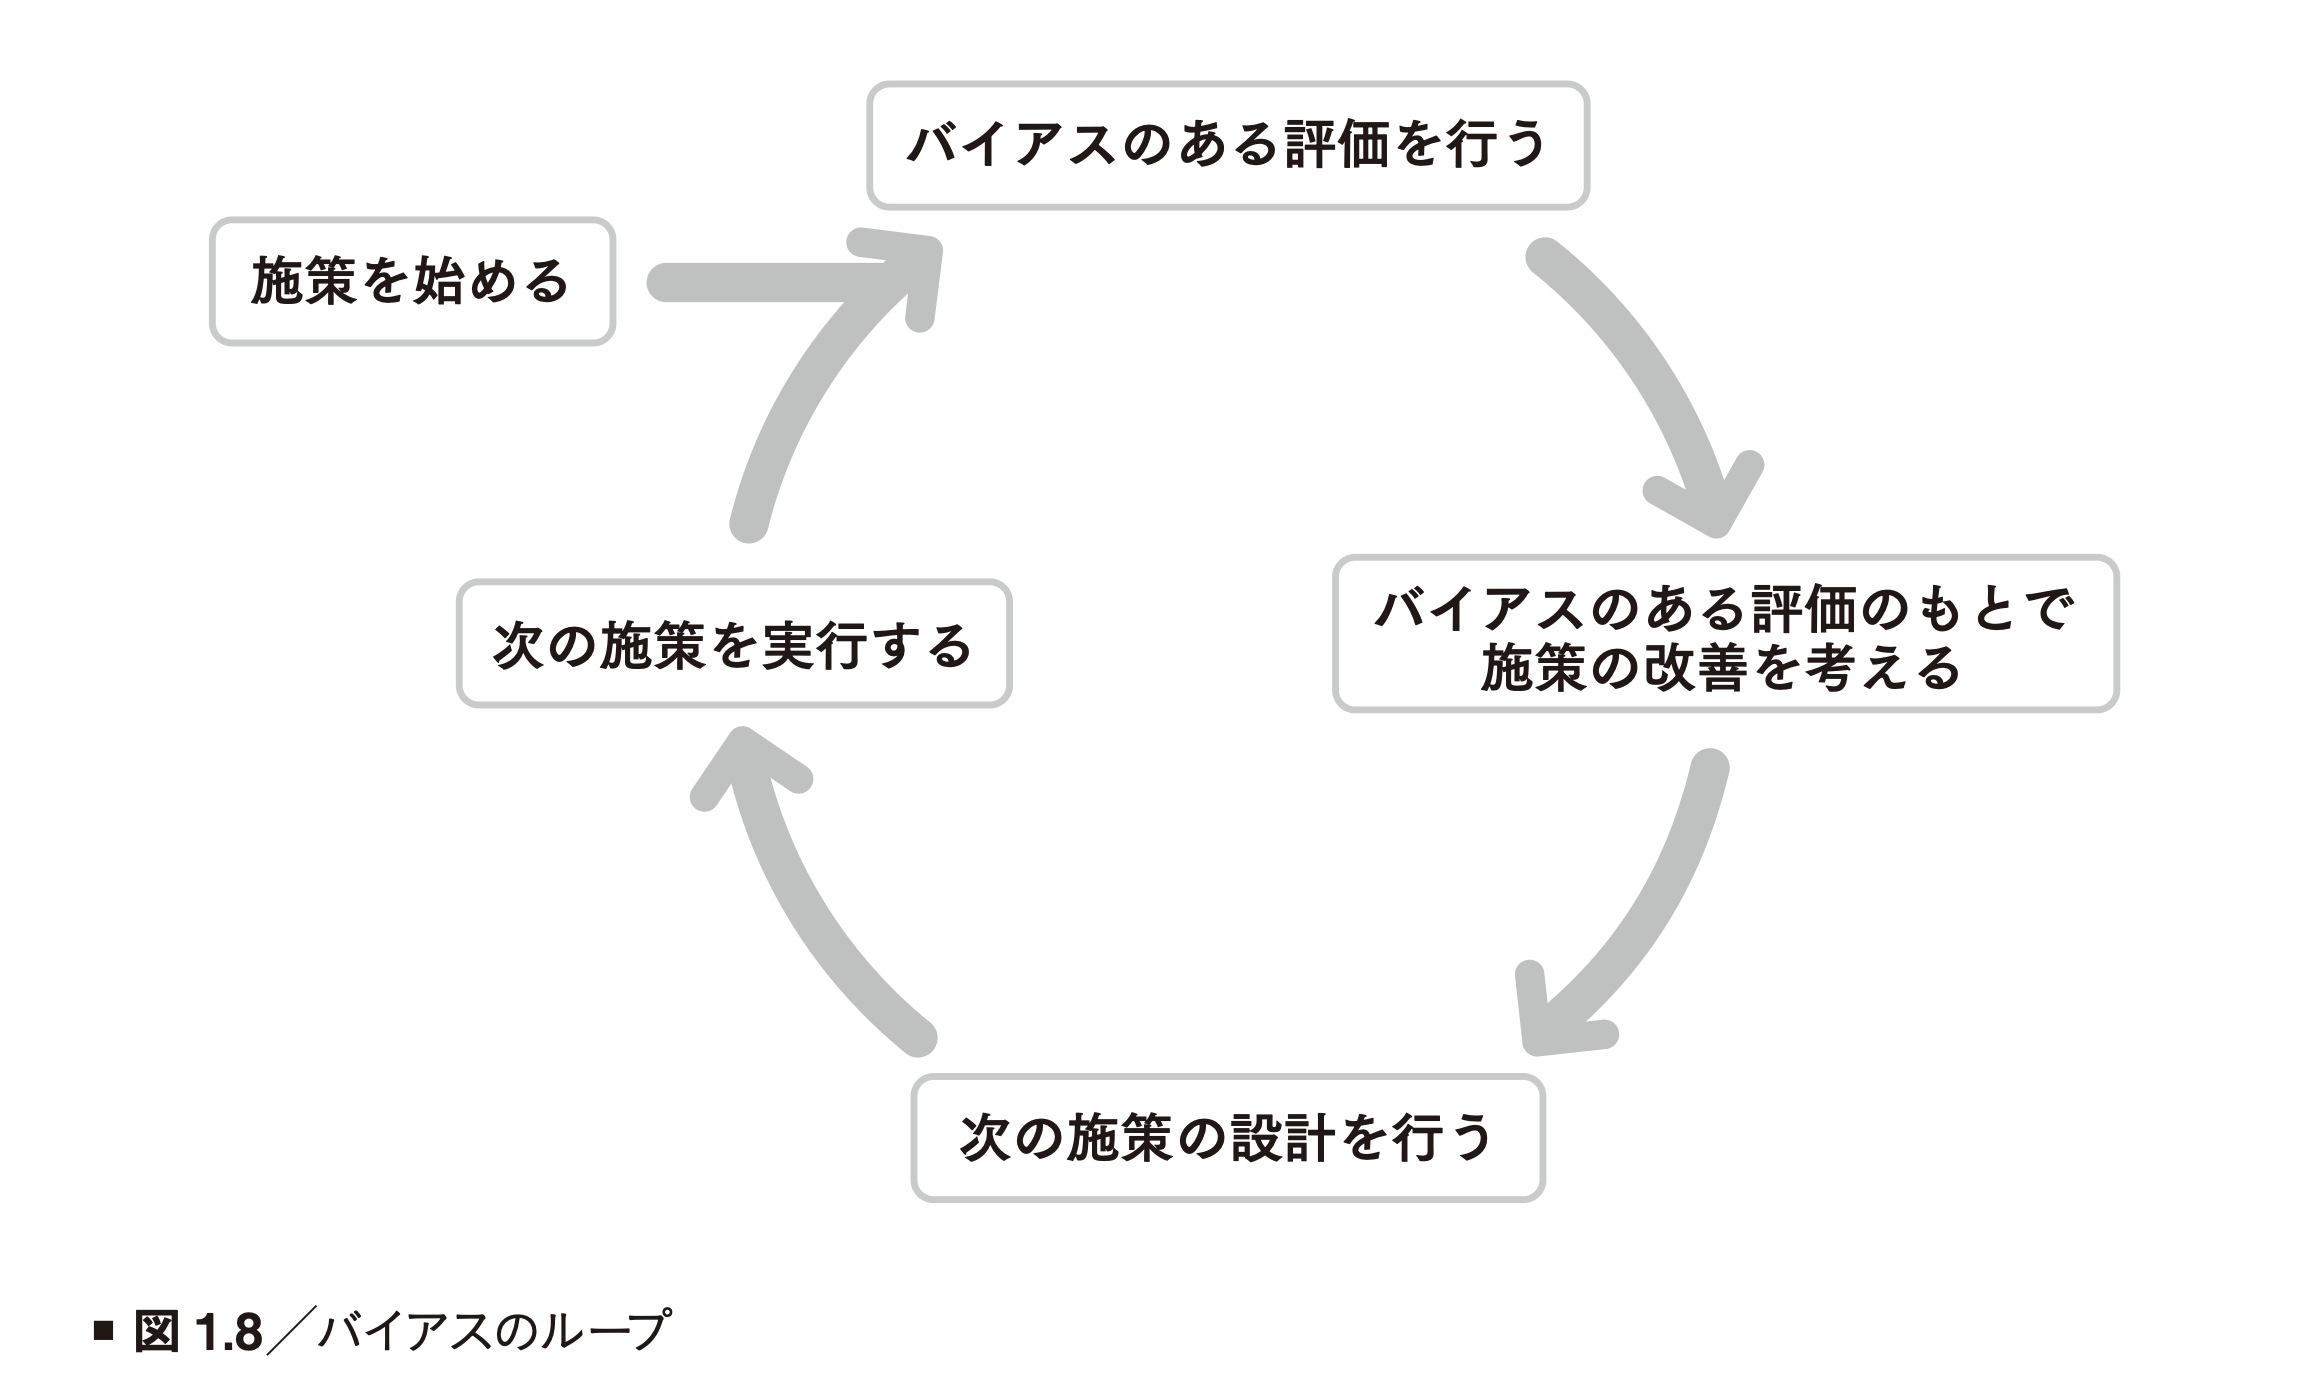
暗黙的フィードバック(視聴の有無など、ユーザが明示的に評価しない行動データ)では、未視聴が「嫌い」を意味するとは限らず、作品を知らない、画面に表示されなかった、時間がなかったといった理由もある。露出を絞ると視聴も観測されにくくなり、そのログを学習すると、露出の少ない作品をさらに推薦しにくくすることがある。
そのため、モデル学習用の視聴ログだけでなく、比較のためのランダム割当とその結果を継続的に残すことに価値がある。オフラインのRecallやNDCGが改善しても、それだけでは「そのモデルに替えた結果、視聴が増えた」とは結論できない。
2. HuluのデータでRCTを設計するなら
2.1 最初に固定するのは、対象・介入・期間・分母である
集計を始める前に定義を固定するのは、分析の最後に答えが出たとき、「結局どの施策の、何に対する効果だったのか」がぶれないようにするためである。
たとえば、結果を見てから対象をアニメ好きへ絞り、観測期間も7日から3日に変えたとすると、最初に判断したかった「全体展開」の問いからは離れてしまう。しかも、結果がよく見える定義を後から選ぶこと自体が、評価を楽観的にする原因になる。先に決めておけば、データ収集から意思決定まで同じ問いを保てる。
たとえば次のように、実験開始前に一つの問いを固定する。
| 項目 | 設計例 |
|---|---|
| 対象 | 開始時点で対象条件を満たす有料プロフィール。キッズを含むかも事前に決める |
| 割当単位 | プロフィール。家庭内干渉が重要ならアカウント |
| 介入群 | ホームの特定推薦枠に新モデルを適用する |
| 対照群 | 同じ枠に旧モデルを適用する |
| 主要指標 | 割当後7日間に、事前指定した対象シリーズを視聴したプロフィールの割合 |
| 視聴の条件 | 例として、期間内の対象作品の視聴秒数合計が60秒以上。これは本ノート独自の指標例である |
| 分母 | 事前に定義した対象者のうち、各群に割り当てられた全プロフィール |
| 補助指標 | 全作品の視聴時間、視聴シリーズ数、再生失敗率など |
| 判定時点 | 全対象者で7日間の観測が完了し、ログの到着を待った後 |
ここで一つ注意したいのは、対象作品の視聴が増えても、別の作品の視聴を置き換えただけかもしれないという点である。たとえば『名探偵コナン』の視聴が増えた分だけ、他のアニメの視聴が減っているかもしれない。そのため、作品単位の改善とサービス全体への効果は分けて考える必要があり、推薦モデル全体を評価したいなら、「対象シリーズ視聴率」ではなく「全作品の視聴日数」などを主要指標にする設計も考えられる。どちらを採用するかで、答えようとしている因果的な問いそのものが変わる。
もう一つの注意は、介入後にトップページを開いた人や動画を再生した人だけへ分母を絞ってはいけないことである。それは介入によって変わる行動で対象を選ぶことになるからである。もしトップ訪問を参加条件にしたいなら、初回訪問の時点で割り当ててその時点より後を測るというように、介入と参加判定の順序を先に設計しておく。
2.2 割当、表示、視聴を別の変数として持つ
モデルを全対象者へ適用するとき、その対象には推薦を見る人だけでなく、ホームを開かない人も含まれる。したがって、展開した方針全体の成果を判断するには、表示に至らなかった人も含めて結果を見る必要がある。一方で、「表示されればよい結果が出るのに、表示機会が少ない」という改善課題を調べたいこともあり、そのときには表示ログも必要になる。
割当、表示、視聴を分けて持つのは、この二つの目的をそれぞれ検討できるようにするためである。割当は方針全体の因果効果の比較に使い、表示や視聴への移行は結果が生じた経路を理解する材料にする。なお、表示された人だけを比べて因果効果として読みたい場合は、別途その比較を正当化する根拠が必要になる。
具体的に考えると、新モデル群に割り当てても本人がホームを開かなければ推薦は表示されないし、表示されても画面外にあって見られないことや、見られても視聴されないことがある。
ランダムに決める。未訪問者も記録する。
訪問、画面、表示位置などに依存する。
未視聴も0として分母に残す。
割当で比較する分析を ITT(Intention-to-Treat)分析 と呼ぶ。これは、実際に見たかどうかではなく、どちらの群に割り当てたかで比べる分析であり、測っているのは「新モデルへ割り当てるという方針の効果」である。表示された人だけの効果とは対象が異なるが、実際に全対象者へ新モデルを適用するという意思決定には、こちらの方が対応しやすい。
数値で確かめよう。新モデル群1,000人のうち250人が視聴し、そのうち実際の推薦表示を確認できたのが500人で、その中の視聴者が200人だったとする。表示者だけなら視聴率は40%だが、ITTの視聴率は25%である。ここで旧モデル群全体の20%と表示者の40%を比較してしまうと、来訪しやすい人を片側だけに選んでいることになる。
なお、ITTの効果を単純に表示率で割れば「表示自体の因果効果」が得られる、というわけでもない。その解釈には、割当が表示以外の経路では視聴へ影響しないといった追加の仮定が必要になる。
2.3 データカタログとの対応
以下は、ローカルの docs/domain/data_catalog.md と
docs/domain/bq_data_definitions/*.csv
に基づく設計上の対応であり、実際のBigQueryデータに対する集計結果ではない。
| 必要な情報 | 確認できるデータ | 利用時のポイント |
|---|---|---|
| プロフィールとアカウントの対応 | hj-data-01.master.gene_profiles_YYYYMMDD の
id, account_id |
実験開始時点のスナップショットを使う。id と
profile_id の対応を確認する |
| 視聴イベント | hj-data-01.report.content_viewing の
profile_id, account_id,
series_id, asset_id,
watched_seconds, start_date_unixtime_sec |
実験期間で抽出し、重複と集計粒度を確認してからプロフィール単位へまとめる |
| 一定以上視聴したシリーズ | hj-data-01.report.unique_viewed_series |
コンテンツ長の25%以上を視聴したシリーズという定義。60秒以上の指標とは別である |
| 日次のパーソナライズKPI | hj-data-01.personalize.daily_personalize_viewing_kpi |
total_viewing_seconds, series_cnt,
asset_cnt
がある。対象母集団と未視聴日の行の有無を確認する |
| 表示・操作のイベント | hj-data-01.intermediate.ga4_unnested_cleaned_log |
masthead_imp
などのイベントがあるが、対象枠の表示をどう定義しているかは実装ごとに確認する |
| シリーズページへの訪問 | hj-data-01.raw_data.import_raw_data_tracking |
event_type='imp'
はカタログ上、シリーズページ訪問である。推薦カードの表示と同一視しない |
| 推薦候補の出力 | recommend_engine.two_tower_u2i_recommendation_{genre}
など |
候補に含まれることは、実際の表示や無作為割当の証拠ではない |
unique_viewed_series は last_viewing_date
を持つが、最終視聴日だけを参照しても、過去の任意の実験期間の視聴有無を完全に復元できるとは限らない。実験後に再視聴すると値が更新されるのか、それとも過去のスナップショットを保持しているのかを確認する必要がある。
同じように、日次の series_cnt
を7日分足しても、7日間のユニークシリーズ数にはならない。たとえば同じシリーズを月曜と火曜に見れば、日次合計では2になるが週次ユニークでは1である。週次テーブルを使う場合も、カタログ上の週次は前週月曜〜日曜なので、「各人の割当後7日」と期間が一致するかを確認しておく。
確認したカタログには、実験IDとランダムな群割当の履歴を明示する専用テーブルの定義は見当たらなかったため、その存在を仮定して実テーブル名を作ることはしない。分析には、少なくとも次の列を持つ割当台帳を、実際の実験基盤から用意する必要がある。
| 提案する割当台帳の列 | 用途 |
|---|---|
experiment_id |
実験を区別する |
randomization_unit_id |
割当に使ったプロフィールまたはアカウントを特定する |
treatment |
0/1の割当を固定する |
assigned_at |
各対象者の観測開始点を決める |
assignment_probability |
どの確率で新モデル群へ割り当てたかを残す |
model_version |
実際の比較条件を追跡する |
これらは提案スキーマであり、既存の列名を示すものではない。
2.4 視聴ログから始めず、割当台帳を基準に結合する
0/1指標を作るときには、「0をどこから得るか」が重要になる。視聴イベントのログは視聴が起きたときにだけ行を作るので、ログだけを見ても、視聴しなかった対象者が誰なのかは分からない。一方、割当台帳は、結果が1でも0でも分析に含めるべき対象者を全員持っている。そこで台帳を基準に結合すれば、実験設計で決めた分母を分析表までそのまま引き継げる。これは結合の書き方の好みの問題ではなく、求めたい確率を正しく定義するための操作である。
最終的には、たとえば次のような「1実験・1プロフィールにつき1行」の分析表を作る。
| profile_id | treatment | pre_viewing_days | viewed_7d |
|---|---|---|---|
| P001 | 0 | 3 | 1 |
| P002 | 0 | 0 | 0 |
| P003 | 1 | 4 | 1 |
| P004 | 1 | 0 | 0 |
pre_viewing_days
は介入前7日間の視聴日数、viewed_7d
は介入後7日間の視聴の有無である。作成の手順は次の通りである。
- 実験開始前に対象条件を決め、対象者の割当を保存する。
- 視聴イベントを各人の観測期間に絞り、定義した視聴条件に従って0/1へ集計する。
- 割当台帳を左側にして、集計した視聴結果をLEFT JOINする。
- ログが完全に取得できており、視聴イベントがないと判断できる行だけを0にする。
- 実験・プロフィールで1行であることを確認し、群別の人数と平均を計算する。
なぜ台帳から始めるのかを数で確かめると、割当者1,000人のうち視聴者250人だけを視聴ログから抽出した場合、全行が
viewed_7d=1
となって視聴率は100%になってしまう。割当台帳から始めて残り750人を含めることで、正しい25%が得られる。
ただし、ログ障害や未到着による欠損は未視聴と同じではないし、期間の途中に実験へ入った人を既に7日間観測した人と混ぜることも避ける。日時はUTCとJSTを統一し、観測窓の境界を明示する。
ワークド例:6人の割当と視聴ログをPolarsで結合する
視聴イベントをそのまま平均すると視聴しなかった人が消えてしまうことを、小さな例で確かめる。ここではプロフィールP1〜P3を旧モデル群、P4〜P6を新モデル群へ割り当てたとし、視聴条件は対象シリーズを合計60秒以上見たこととする。イベントは全員について割当後7日間の対象シリーズだけに絞り込み済みで、観測窓は完了し、ログ欠損もないものとする。
| プロフィール | 群 | 記録された視聴秒数 | 合計 | 60秒以上か |
|---|---|---|---|---|
| P1 | 旧モデル | 30秒、40秒 | 70 | 1 |
| P2 | 旧モデル | 10秒 | 10 | 0 |
| P3 | 旧モデル | 記録なし | 0 | 0 |
| P4 | 新モデル | 90秒 | 90 | 1 |
| P5 | 新モデル | 20秒、50秒 | 70 | 1 |
| P6 | 新モデル | 記録なし | 0 | 0 |
ここで大事なのは、P1やP5のイベントを先に合計することである。もし「1イベントで60秒以上」という条件にすると、合計では条件を満たすこの2人を取り逃がしてしまう。また、集計前のイベントをそのまま結合すると、P1とP5の割当行が複製されて人数の重みが変わってしまうので、これも避ける。
assignments_demo = pl.DataFrame({
    "profile_id": ["P1", "P2", "P3", "P4", "P5", "P6"],
    "treatment": [0, 0, 0, 1, 1, 1],
})
events_demo = pl.DataFrame({
    "profile_id": ["P1", "P1", "P2", "P4", "P5", "P5"],
    "watched_seconds": [30, 40, 10, 90, 20, 50],
})
viewing_totals = events_demo.group_by("profile_id").agg(
    pl.col("watched_seconds").sum().alias("seconds_7d")
)
analysis_demo = (
    assignments_demo.join(
        viewing_totals, on="profile_id", how="left", validate="1:1"
    )
    # この例では、ログの完全性を確認済みという前提で0にする。
    .with_columns(pl.col("seconds_7d").fill_null(0))
    .with_columns((pl.col("seconds_7d") >= 60).cast(pl.Int8).alias("viewed_7d"))
    .sort("profile_id")
)
joined_summary = (
    analysis_demo.group_by("treatment")
    .agg(pl.len().alias("n"), pl.col("viewed_7d").mean().alias("view_rate"))
    .sort("treatment")
)
print("未視聴者を含む分析表:", analysis_demo)
print("割当者を分母にした視聴率:", joined_summary)
join_difference = (
    joined_summary.filter(pl.col("treatment") == 1).get_column("view_rate").item()
    - joined_summary.filter(pl.col("treatment") == 0).get_column("view_rate").item()
)
print("視聴率差(pp):", 100 * join_difference)
validate="1:1"
は、結合キーが左右の表で一意であることを検証する指定である。ここでは一つの実験だけを扱うので
profile_id
をキーにできるが、複数の実験を扱う場合は、実験IDなどを含めてキーを定義する。Polars公式:join
計算結果は次になる。
旧モデル群3人のうち視聴者は1人、新モデル群3人のうち視聴者は2人なので、その差は3分の1、つまり約33.33 ppである。
では、視聴ログがある人だけで集計するとどうなるか。旧モデル群ではP1・P2の2人、新モデル群ではP4・P5の2人が分母になるため、 、すなわち50 ppとなる。さらに60秒以上の人だけを残せば両群とも100%となり、差は0 ppになる。つまり、同じログでも分母を変えるだけで、答えは33.33 pp、50 pp、0 ppと変わるのである。
三つの分母の取り方を並べると、答えの違いが一目で分かる。
なお、この6人は集計手順の練習用であり、推定効果の確実性を判断するための十分な実験規模ではない。
2.5 割当単位に合わせて不確実性を評価する
標準誤差を小さくするために必要なのは、行数を増やすことではなく、結果の揺れについて新しい情報を得ることである。たとえば同じ人のイベントを細かく分割しても、その人が視聴しやすいという共通の要因は残るので、行の数を独立な対象者数と見なすと、実際より多くの情報を持っているかのように計算してしまう。割当単位や共有される行動に合わせて集計・推論するのは、証拠の量を過大に数えないためである。
言い換えると、一人が100回再生したとしても、それを100人分の独立した実験と扱うことはできない。プロフィール単位で割り当てたなら、まずプロフィール単位で集計するのが出発点になる。
家族で一つのテレビを使い、同じホーム画面を見ている場合のように、同一アカウント内で推薦結果や行動が共有されるなら、アカウント単位の割当が候補になる。その場合、推論もアカウント単位の集計や、クラスタ頑健標準誤差(同じアカウント内の相関を許して計算する標準誤差)などに対応させる。アカウント単位で割り当てたのにプロフィールをすべて独立としてt検定すると、精度を過大評価するおそれがある。
なお、アカウント平均を単純に平均する場合と全プロフィールの平均を求める場合では、プロフィール数の多いアカウントへの重みが異なるので、どちらを主要な効果とするかも事前に決める必要がある。
ワークド例:アカウント平均とプロフィール平均で答えが変わる
説明用に、アカウントAにはプロフィールが1個、アカウントBには3個あるとし、新モデルによる個人効果はAの1人だけが1、Bの3人は全員0という仮想設定にする。
まず、プロフィールを同じ重みで扱うATEは、次になる。
4人のプロフィールのうち効果があったのは1人なので、平均は0.25である。
一方、アカウントごとの「プロフィール平均の効果」を先に求めると、Aは 、Bは であり、この二つのアカウントを同じ重みで平均すると次になる。
2つのアカウントのうち片方の平均効果が1、もう片方が0なので、平均は0.50である。
プロフィール平均を求めたいなら、アカウント平均にプロフィール数の重みを掛けて とすればよい。どちらも計算としては正しく、同じ人を対象にしていても「何を1単位として同じ重みを与えるか」が違うのである。したがって、割当単位に合わせるために集計粒度を変えるときは、求めたい平均まで意図せず変えていないかを確認する。
3. 第1章を実務で強化する追加手法
以下は、第1章の単純平均差による分析を拡張するものであるが、「より複雑な手法を使えば必ずよい」という意味ではない。何を改善し、どの前提が増えるのかを分けて理解することが大切である。
3.1 層別無作為化:重要な事前特徴の偏りを抑える
通常の無作為割当でも繰り返しの平均では偏りはないが、今から一度だけ行う実験でヘビーユーザが片側へ多く入ることはあり、その偶然の差が小さなモデル改善を見えにくくする。視聴量を強く左右する特徴が事前に分かっているなら、各タイプ(層)の中で割り当てることで、この偶然の不均衡をあらかじめ抑えられる。これが 層別無作為化 であり、まずユーザをタイプ別に分け、そのタイプの中でくじ引きをする方法だと考えればよい。層別化は、このように実験を始める前から比較の精度を高めるために行う。
その後に層の重みを掛けるのは、ライト層とヘビー層を何人ずつ含む対象集団の平均なのかを再構成するためである。層内の効果を求めただけでは、「全体でどれだけ増えるか」という問いへの答えはまだ完成していない。
たとえば、介入前の視聴日数でライト層とヘビー層に分け、各層の中で新旧モデルを無作為に割り当てれば、片方の群にヘビー層が偶然多く入ることを抑えられる。
全体の効果は、対象母集団での層の割合に従って、層内の効果を平均する。
層ごとに新旧モデルの平均差を出し、その層が対象集団に占める割合を掛けて全部足す、という計算である。 は層、 は対象母集団における層の割合であり、合計が1になる。たとえばライト層が60%で効果8 pp、ヘビー層が40%で効果2 ppなら、全体の効果は次である。
ここで注意したいのは、各層で介入確率を変えると介入群と対照群の層構成が異なりうることで、その場合は全員をひとまとめにした単純平均差へ戻さず、設計に対応した重み付けを行う。また、介入後の視聴量で層を作ると、処置によって変化した特徴で条件付けることになるため、層別化には介入前の特徴を使う。
ワークド例:層ごとに割当比率が違うと、単純平均差は32.67 ppになる
先ほどのライト層60%、ヘビー層40%の対象集団について、次の結果が得られたとする。各層の中ではランダムに割り当てているが、新モデルへ割り当てる割合はライト層で 、ヘビー層で と層によって異なる。
| 層 | 新モデル人数 | 新モデル視聴者 | 旧モデル人数 | 旧モデル視聴者 |
|---|---|---|---|---|
| ライト | 100 | 18 | 500 | 50 |
| ヘビー | 300 | 186 | 100 | 60 |
まず層内で比較すると、ライト層は 、ヘビー層は であり、これを対象集団の構成比で平均すると先ほどと同じ5.6 ppになる。
一方、層を無視して合計すると、新モデル群にはもともと視聴しやすいヘビー層が多くなる。
新モデル群400人のうち204人が視聴し、旧モデル群600人のうち110人が視聴したので、その差は約32.67 ppである。
層内の差は8 ppと2 ppなのに単純平均差が32.67 ppになるのは、新モデル群ではヘビー層が75%を占めるのに対し、旧モデル群では約16.67%しか占めないためである。「層内では無作為化している」という性質を使うなら、分析も層内の比較から組み立てる必要がある。
層内の比較と、層を無視した比較を並べたのが次の図である。
3.2 CUPED:介入前の行動から説明できる変動を減らす
RCTの結果が不確かなら人数や期間を増やす方法があるが、結果を待つ時間が長くなり、実験を続けるコストもかかる。そこで、同じ人数からもっと精密に効果を測るために、すでに持っている事前の視聴履歴を使えないかと考える。
たとえば「新モデル群は実験前から平均視聴日数が少し多かった」という情報があれば、実験中の差の一部はその偶然の偏りで説明できそうだと分かる。その説明できる部分を調整し、モデル変更による小さな差を捉えやすくするのがCUPEDの動機である。ここでは順序が大事で、 まず無作為化で比較の根拠を作り、そのうえで事前情報を使って推定の揺れを減らす 、ということになる。
Huluでは、もともとよく視聴する人ほど実験期間にも視聴しやすいと考えられる。その事前情報を利用して、群間の偶然の偏りが推定値へ与える影響を減らす方法がCUPED(Controlled-experiment Using Pre-Experiment Data)であり、つまり実験前の行動データを使って推定値の揺れを小さくする方法である。介入前データを使う分散削減手法として提案された。CUPEDの原論文:Deng et al. (2013)
介入前の指標を として、調整後のアウトカムを次で定義する。
これは、その人の結果から、事前の視聴が平均よりどれだけ多かったか(少なかったか)に応じた分を差し引く操作である。 は共通の基準平均、 は と の関係の強さを表す係数であり、この調整を両群に同じ係数で適用すると、平均差は次になる。
つまり、実験中の平均差から、事前指標の平均差に係数を掛けた分を引いている。新モデル群が偶然「介入前からよく見る人の多い群」になっていた場合、その差から説明できる部分を引くわけである。無作為化されたRCTでは事前特徴の群間差は期待値でゼロなので、固定した係数による調整は、平均効果を保ちながら変動を減らすことができる。
式の中で共通平均を引くのは、「平均的な人と比べて事前の視聴がどれだけ多いか」というずれだけを調整に使うためである。実験全体の標本平均を共通基準にすれば、事前のずれの合計はゼロになる。なお、群間差だけを計算すると共通基準は相殺されるが、それでも全員に同じ基準を使うことが大切である。
ここで注意したいのは、各群の をそれぞれの群平均で中心化してはいけないことである。そうすると各群内で調整量の平均がゼロになって群平均の差は全く変わらず、補正したかった「新モデル群の事前平均が高い」という情報まで消えてしまう。
また、係数を掛けるのは、事前の視聴日数をアウトカムの単位へ換算するためである。「1日多いことが視聴確率の何ポイント分に対応するか」を決めずに、日数を視聴率から直接引くことはできない。共分散を分散で割る係数は、この換算を、線形調整の分散が最小になるように選ぶ方法である。
数値例 で確かめよう。実験中の視聴率が旧モデル20%、新モデル25%で、介入前の平均視聴日数は旧モデル2.0日、新モデル2.2日だったとする。さらに、過去の別データから 、つまり事前視聴が1日多いと実験中の視聴確率がおおよそ3 pp高いという関係を得ているとする。
観測した差5 ppから、新モデル群が事前に0.2日多く見ていた分の0.6 ppを引くので、調整後の推定値は4.4 ppになる。この例では調整後の推定値が小さくなったが、逆方向の事前の偏りなら、調整後の推定値は大きくなる。
単一の確率変数 の分散を線形調整で最小化する係数は次である。
分子は と が一緒に動く度合い、分母は 自身の散らばりであり、これは次の分散を で微分してゼロにすることで得られる。
最適係数を代入すると、次になる。
調整後の分散は、元の分散に を掛けたものになる。 は と の相関係数で、相関が0.6なら分散は元の64%、標準偏差は80%になる。群ごとの関係が近いなどの条件のもとでは平均差の標準誤差も同様に小さくなるので、同じ精度に必要な人数を減らせる。ただし、処置群と対照群で共分散構造が違う場合や不均等割当の場合には、平均差の分散を最小化する係数を単純な全体共分散から決めてよいとは限らないので注意がいる。実装上の論点:Microsoft, Deep Dive Into Variance Reduction
相関の強さと分散の減り方の関係は、次の曲線で表せる。
ワークド例:4人から共分散・係数・調整後分散を求める
係数 を与えるだけでは仕組みが見えにくいので、計算練習用の過去データを4行用意し、 を事前の視聴日数、 をその次の期間の視聴有無とする。これはCUPEDの係数を理解するための表であり、4人で実務用の係数を安定して推定できるという意味ではない。
| 人 | 二つのずれの積 | ||||
|---|---|---|---|---|---|
| A | 0 | 0 | -1.5 | -0.5 | 0.75 |
| B | 1 | 0 | -0.5 | -0.5 | 0.25 |
| C | 2 | 1 | 0.5 | 0.5 | 0.25 |
| D | 3 | 1 | 1.5 | 0.5 | 0.75 |
まず、 、 となる。標本共分散と標本分散は、ともに分母を として計算する。
したがって、係数は次になる。
係数0.4は、事前の視聴日数が1日多いと視聴の有無が0.4だけ高いという関係を表す。この係数と共通平均1.5を使い、各行の を求める。
| 人 | 代入計算 | 調整後の値 |
|---|---|---|
| A | 0.6 | |
| B | 0.2 | |
| C | 0.8 | |
| D | 0.4 |
調整後の平均は で調整前と同じだが、平均からの散らばりは小さくなる。
元の分散に対する比は であり、相関係数の二乗から計算しても同じ結果になる。
事前の視聴日数で視聴有無の散らばりの80%を説明でき、残る散らばりは20%ということである。
「事前データで説明できる変動を引く」とは、各人を全く同じ値へ揃えることではなく、このように平均を保ちながら不要な散らばりを減らすことである。なお、これは係数を学習した同じ4行での分散の計算なので、別の実験でも80%の分散削減が得られる保証はない。
次は、説明のために作ったRCTデータへ、独立した過去データで決めたとみなす固定係数を適用する例である。
rng_cuped = np.random.default_rng(2026)
size = 20_000
pre_days = rng_cuped.integers(0, 8, size=size)
treatment = np.repeat([0, 1], size // 2)
rng_cuped.shuffle(treatment)
view_probability = 0.10 + 0.06 * pre_days + 0.03 * treatment
viewed = rng_cuped.binomial(1, view_probability)

cuped_demo = pl.DataFrame({
    "treatment": treatment,
    "pre_days": pre_days,
    "viewed": viewed,
})
# 教育用に、過去の別データで固定した係数として設定する。
theta_fixed = 0.06
cuped_demo = cuped_demo.with_columns(
    (
        pl.col("viewed")
        - theta_fixed * (pl.col("pre_days") - pl.col("pre_days").mean())
    ).alias("viewed_adj")
)
print("CUPED前:", compare_means(cuped_demo, "viewed"))
print("CUPED後:", compare_means(cuped_demo, "viewed_adj"))
調整後の値は負や1超になることがあるが、これは確率の予測ではなく平均効果を推定するための調整スコアなので問題ない。生成過程における新旧モデルの視聴確率差は3 ppであり、推定値はその周辺で揺れる。
このコードの実行では、調整前が2.8700 pp(95%区間1.5710〜4.1690 pp)、調整後が2.7722 pp(1.5312〜4.0132 pp)となった。この一回では点推定が真値3 ppに近づいたわけではないが、区間の幅は小さくなっている。分散削減は、各回の点推定を必ず真値へ近づける保証ではない。
調整前後の推定値と区間の幅を並べると、次のようになる。
実務で同じ実験データから係数を推定する場合は、共変量調整回帰と頑健標準誤差、あるいは別サンプルでの学習やcross-fittingなど、係数推定も踏まえた推論を検討する。RCTの事前共変量調整については、処置と中心化共変量の交互作用を含めた回帰と頑健標準誤差について、理論的な結果がある。Lin (2013), Agnostic notes on regression adjustments to experimental data
ただし、CUPEDは観察データの交絡を自動で除く手法ではない。また、実験中のクリック数や視聴日数のように、介入によって変わりうる指標を事前特徴の代わりに入れることも避ける。さらに、履歴がない新規プロフィールを単に削除すると対象集団が変わってしまうので、欠損の扱いは事前に決めておく。
3.3 必要人数を先に考える:検出力とMDE
実験終了後に「有意ではなかった」と分かっても、そもそも検出したかった改善を捉えられない人数で始めていたなら、モデルが役に立つかという問いには答えられない。たとえば事業上は1 ppの改善に価値があるのに、5 ppほどの差しか検出しにくい設計だったなら、有用なモデルを見逃しやすい。必要人数を先に考えるのは、実験に使う時間と対象者数を、判断したい効果の大きさに合わせるためである。
有意差が出なかったとき、「十分に小さい効果しかない」のか、それとも「人数が足りず分からなかった」のかを区別するには、実験前の検出力設計が役立つ。
検出力 は、ある大きさの効果が本当にあるとき、設定した検定が帰無仮説を棄却できる確率、言い換えると本当に効果があるときにそれを「ある」と言える確率である。 MDE(Minimum Detectable Effect、最小検出可能効果) は、設定した有意水準・検出力・人数で検出したい最小の効果幅を指す。これは事業上価値のある最小効果とは別のものなので、両者は別途すり合わせる必要がある。
基準視聴率 、検出したい差 、各群同人数の近似では、各群の必要人数は次で概算できる。
結果のばらつきが大きいほど、また検出したい差が小さいほど、必要な人数は増える。 は有意水準、 は検出力、 は標準正規分布の 分位点である。基準視聴率20%、検出したい差2 pp、両側5%検定、検出力80%なら、次の程度になる。
各群約6,300人、合計約12,600人が目安である。ここで検出したい差を1 ppへ半減させると、分母が4分の1になるので必要人数は約4倍になり、小さい差を測ることの難しさが分かる。実際の設計では、処置群の比率、クラスタ内相関、欠測、複数指標などを反映させるため、この式だけで確定はしない。
ワークド例:CUPEDの分散削減を必要人数へ換算する
各群6,272人が必要という先ほどの近似設計について、事前指標との相関が0.6あり、CUPEDで平均差の分散も0.64倍になる条件が満たされるとする。平均差の分散はおおよそ「一人当たりの分散÷人数」に比例するので、同じ精度に必要な各群人数は次のように概算できる。
分散が0.64倍になるなら必要な人数も0.64倍でよいので、切り上げて各群約4,015人である。ただし、これは相関と分散削減の見積もりが新しい実験にも当てはまるとした計算なので、最終的な必要人数は対象指標と設計で求め直す。
逆に、人数を各群6,272人に維持するなら、標準誤差は 倍になるので、同じ検出力で検出できる差の概算は ppになる。つまり、CUPEDの利点を「人数を減らす」ために使うか、「小さい改善を測る」ために使うかという違いである。
検出したい差と必要人数の関係を曲線で描くと、小さい差を測る難しさが見える。
3.4 途中確認と多重比較を設計に含める
実験を運用していると、良い結果が出たら早く展開したくなるし、全体で差がなければ効果のありそうなセグメントを探したくなる。どちらも自然な行動だが、判定する機会を増やすと、偶然よく見える結果を拾う機会も増える。そのため、一回の検定だけを考えるのでは足りず、 結果を見てから何を選び、いつ判断を止めるかという手続き全体 を考える必要がある。逐次検定(途中で何度も判定することを前提にした検定)や多重比較の調整は、その手続きのもとでも誤判定を管理するために導入する。
たとえば、通常の固定標本のp値を毎日見て、5%未満になった最初の日に終了すると、予定した偽陽性率を維持できない場合がある。途中の安全監視は必要だが、成功判定は事前に決めた期間・人数で行うか、途中終了に対応する逐次検定を設計する。Johari et al., Always Valid Inference
また、独立な20指標について、すべて効果ゼロなのに各々5%水準で検定すると、少なくとも一つが有意になる確率は次になる。
これは20個すべてが有意にならない確率を1から引いたものである。実際の指標は互いに相関するので64.2%がそのまま当てはまるわけではないが、それでも「たくさん見れば何かは当たる」ことが分かる。したがって、主要指標を先に定め、確認的に判断する複数の検定にはHolm法などの調整を検討し、探索的に見つけたセグメント差は別の実験で確認する。Holm (1979), A Simple Sequentially Rejective Multiple Test Procedure
指標の数を増やしたとき、「何かが有意になる確率」がどう増えるかを次の図に示す。
3.5 手法ごとに改善する対象が違う
| 方法 | 主に改善すること | その方法だけでは解決しないこと |
|---|---|---|
| 無作為割当とITT | 処置の選ばれ方による比較の偏り | ログ欠測、干渉、対象外の集団への一般化 |
| 層別無作為化 | 重要な事前特徴の偶然の不均衡 | 介入後の抽出による偏り |
| CUPED・事前共変量調整 | 推定値の変動、必要人数 | 未観測交絡を含む観察データの識別 |
| 検出力設計 | 必要人数と検出できる効果の見通し | データの系統的な偏り |
| 逐次検定・多重比較調整 | 途中終了や多数の検定に伴う誤判定 | 因果的に不適切な比較 |
| 回帰・傾向スコアなど | 仮定の下での観察データの比較可能性 | 未観測要因を含むあらゆるバイアス |
第1章の平均差は単純な計算だが、その単純さを支えているのは実験の設計である。高度な推薦モデルや推定手法を使う場合も、出発点は同じで、「誰の、どの二つの世界を比較しているか」を明示するところから始まる。
4. 理解を確かめる小問
問1:表示者の視聴率が高ければ、表示の効果か
推薦を実際に見た人の視聴率が40%、見ていない人が10%だった。表示の効果は30 ppと言えるか。
解答 :それだけでは言えない。ホームへよく訪問する人ほど推薦を見やすく、しかも視聴もしやすいかもしれないからである。したがって、ランダムに割り当てた群の比較なのか、それとも後から表示の有無で分けた比較なのかを確認する必要がある。
問2:選択バイアス項がゼロなら、必ずATEか
が成り立つとき、単純平均差は必ずATEになるか。
解答 :一般にはATTになる。効果が人によって違い、効果の大きい人に介入が集中していれば、ATTとATEは違う値になる。ATEと一致するには、効果の大きさによる選択もないことなどが必要である。
問3:有意差が出ないのは効果ゼロの証明か
視聴率の差の推定値が1 pp、95%信頼区間が -3〜5 ppだった。効果なしと結論してよいか。
解答 :よくない。この区間には意味のある改善も悪化も含まれており、十分な精度で小さな差に絞れた状態ではない。「実質的に差がない」ことを示したいなら、許容する差の範囲を定義し、同等性の問題として扱う。
問4:視聴ログにない人は分析から外してよいか
割当者1万人のうち視聴ログがあるのは2,500人だった。2,500人だけで視聴率を計算してよいか。
解答 :よくない。ログが完全なら、残り7,500人の未視聴も含めて25%と計算する。ただし、ログ欠損や未到着を確認せずに、記録がないことをすべて未視聴と扱ってはいけない。